

Cette page est une traduction automatique de la page en anglais, qui fait foi. Lire la page en anglais
Maintenance
Comment mettre le serveur hors service pour intervenir sur la base de données, le KV ou la file de tâches, et ce qu’il faut afficher pendant ce temps.
Il y a deux outils :
- Le mode maintenance (
maintenance = true,MY_MAINTENANCE=trueoumy serve -maintenance).my servedémarre sans ouvrir aucun adaptateur et répond à chaque requête par un503, unRetry-Afteret une réponse que chaque client comprend. Utilisez-le chaque fois quemy servelui-même peut s’exécuter. - La page exportée (
my maintenance export). Du HTML statique issu du même modèle, qu’un répartiteur de charge, un CDN ou un proxy inverse sert lorsquemy servene peut plus du tout s’exécuter (image en cours de remplacement, révision qui ne démarre pas). Voir Exporter la page de maintenance.
Ce que répond le mode maintenance
Section intitulée « Ce que répond le mode maintenance »Le processus ne lit que l’adresse d’écoute, host, account_domain, web_origin, les proxies (trusted_proxies, trusted_proxy_header),
la vérification d’origine (origin_secret, origin_secret_previous, origin_secret_header), status_page_url et les paramètres maintenance_* (référence de la configuration).
Les paramètres de la base de données, de la file, du stockage de blobs, du KV, de l’e-mail et du flux ne sont ni lus ni vérifiés ; ils peuvent donc être erronés ou inaccessibles pendant ce temps.
Quel que soit le role, il ne sert que du HTTP : aucun job, aucun job périodique, aucun courtier de flux. Il sert aussi du HTTP simple quoi que dise tls,
sur listen ou son :8080 par défaut (servir le HTTPS depuis le serveur).
my config check -maintenance vérifie exactement ce que lit le mode maintenance.
Avec origin_secret défini, une requête qui exige l’en-tête et qui en est dépourvue reçoit le 403 de cette vérification au lieu du tableau ci-dessous.
| Requête | État | Corps |
|---|---|---|
GET /healthz, GET /readyz, GET /health/live, GET /health/ready |
200 |
{"status":"maintenance"} |
GET /api/v1/instance/health |
503 |
{"status":"maintenance"} |
Le reste de l’API cliente (/api/*) et les points de terminaison OAuth qui répondent en JSON |
503 |
application/problem+json de type /api/v1/problems/maintenance, avec message, until et status_page_url lorsqu’ils sont définis |
ActivityPub (par chemin, Accept ou Content-Type), WebFinger, host-meta, NodeInfo, les webhooks de paiement, les appels de Cloud Tasks et de Cloud Scheduler (/_internal/*) |
503 |
{"error":"maintenance"} |
| Tout le reste (pages, client web, ses ressources, envois de formulaires) | 503 |
La page de maintenance, ou le problème lorsque Accept demande du JSON |
Chaque réponse porte Retry-After et Cache-Control: no-store. Retry-After compte les secondes jusqu’à maintenance_until tant qu’il est à venir
(au plus 86 400), et vaut sinon maintenance_retry_after (une durée Go, 10m par défaut).
La page et le problème affichent :
| Paramètre | Affiché comme |
|---|---|
maintenance_server_name |
Le nom du serveur. Le nom d’hôte lorsqu’il n’est pas défini (le nom propre de l’instance se trouve dans la base de données) |
maintenance_message |
Un avis en texte brut, de 2 000 caractères au plus, identique dans chaque locale |
maintenance_until |
Quand les travaux devraient se terminer (RFC 3339). La page l’affiche en UTC ; le client web dans le fuseau horaire de l’utilisateur |
status_page_url |
Un lien vers la page d’état (Surveillance) |
Les paramètres maintenance_* peuvent rester définis en fonctionnement normal : ils ne sont utilisés que lorsque maintenance est vrai.
Les mots de la page suivent Accept-Language (anglais sinon).
Le client web affiche un avis de maintenance plein écran lorsque l’API répond avec le problème de maintenance,
garde l’utilisateur connecté et réessaie après Retry-After.
Combien de temps
Section intitulée « Combien de temps »Limitez une maintenance à quelques heures. Les autres serveurs réessaient leurs remises en cas de 503, mais aucun d’eux ne lit Retry-After,
et lorsque leurs tentatives sont épuisées, les activités envoyées entre-temps sont perdues pour ce serveur.
La fenêtre de nouvelles tentatives la plus courte parmi les principales implémentations est d’environ un jour (Akkoma environ 1 jour, Misskey environ 1,5 jour, Mastodon environ 2 à 3 jours, Pleroma environ 7 jours,
d’après leurs calendriers de nouvelles tentatives).
Les moteurs de recherche traitent un 503 bref comme une panne temporaire, mais Google déconseille de servir un 503 pour robots.txt pendant plus d’un jour ou deux.
Un arrêt de plus d’un jour ou deux n’est pas une maintenance : fermez plutôt le service (Fermer le service).
- Annoncez-la. Publiez la fenêtre sur la page d’état (
status_page_url) et comme annonce (Administration → Annonces) un peu à l’avance. Définissezmaintenance_messageetmaintenance_untildans la configuration du déploiement, et actualisez les pages exportées (my maintenance export) si le front-end les sert. - Arrêtez la file de poussée (Cloud Tasks) — voir ci-dessous. Sinon, chaque envoi pendant la fenêtre
est un
503qui consomme l’une des tentatives de la tâche. - Passez en mode de maintenance : redéployez avec
MY_MAINTENANCE=true(selon la cible ci-dessous). Chaque réplique redémarre en mode de maintenance ; le répartiteur de charge les conserve car/readyzrépond200. - Faites le travail.
- Revenez en arrière : redéployez sans
MY_MAINTENANCE(ou avecfalse), vérifiez que/health/readyet/api/v1/instance/healthrépondent{"status":"ok"}, puis reprenez la file de poussée et fermez l’annonce.
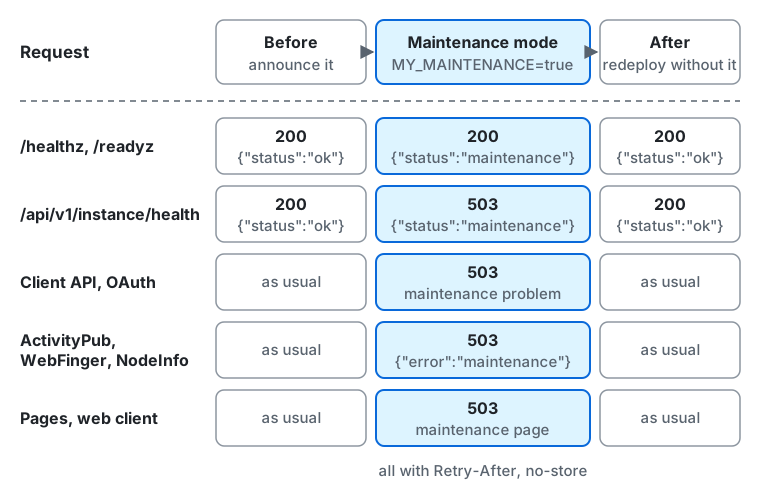
De gauche à droite :
- Avant, pendant que vous annoncez la maintenance, chaque requête reçoit sa réponse habituelle :
/healthz,/readyzet/api/v1/instance/healthrépondent200avec{"status":"ok"}. - En mode de maintenance (
MY_MAINTENANCE=true) :/healthz,/readyz,/health/liveet/health/readyrépondent200avec{"status":"maintenance"}./api/v1/instance/healthrépond503avec{"status":"maintenance"}.- Le reste de l’API cliente et les points de terminaison OAuth qui répondent en JSON reçoivent
503avec le problème de maintenance. - ActivityPub, WebFinger et NodeInfo répondent
503avec{"error":"maintenance"}. - Les pages et le client web reçoivent
503avec la page de maintenance. - Chaque réponse porte
Retry-AfteretCache-Control: no-store.
- Après que vous avez redéployé sans
MY_MAINTENANCE, chaque requête reçoit de nouveau sa réponse habituelle.
Files en mode push
Section intitulée « Files en mode push »-
Cloud Tasks : mettez la file en pause, ce qui lui permet de continuer à accepter de nouvelles tâches mais cesse de les distribuer, et reprenez-la après le travail. Le nombre de tentatives d’une tâche est le
retryConfig.maxAttemptsde la file.Fenêtre de terminal gcloud tasks queues pause my-jobs --location=asia-northeast1gcloud tasks queues resume my-jobs --location=asia-northeast1Mettez aussi en pause la tâche Cloud Scheduler de
/_internal/tick(gcloud scheduler jobs pause/resume), ou laissez ses appels échouer avec503entre-temps. Les tâches elles-mêmes sont dans la base de données : une tâche qui a épuisé ses tentatives ne perd que son signal, et le premier tick après le travail signale de nouveau chaque tâche due.
Selon la cible
Section intitulée « Selon la cible »Les pages d’erreur des frontaux ci-dessous répondent aux erreurs du serveur avec la page exportée. Ne les appliquez qu’aux erreurs d’un serveur qui ne s’exécute pas
(502 et 504, et le 503 propre au répartiteur de charge lorsqu’il n’a aucun backend sain), ou n’activez la règle que lorsque my serve ne peut pas s’exécuter :
une règle sur chaque 503 remplacerait aussi les réponses propres du mode maintenance, comme le problème que lisent l’API cliente et le client web.
Cloud Run
Section intitulée « Cloud Run »Déployez une nouvelle révision avec la variable, puis supprimez-la ensuite :
gcloud run services update my --region=asia-northeast1 \ --update-env-vars=MY_MAINTENANCE=true,MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Zgcloud run services update my --region=asia-northeast1 --remove-env-vars=MY_MAINTENANCE,MY_MAINTENANCE_UNTILAvec le module OpenTofu, définissez-la plutôt dans le bloc, sous la forme settings = { maintenance = "true" }, et appliquez, puisque la prochaine application remet
ce que dit le bloc : Déployer sur Cloud Run l’utilise autour d’une mise à niveau.
Lorsque Cloud Run est exposé directement, sans répartiteur de charge, il n’y a rien devant lui ; le mode maintenance est donc le seul outil.
Lorsque my serve ne peut pas s’exécuter derrière un Application Load Balancer externe global : téléversez le index.html exporté dans un bucket Cloud Storage
ajouté comme bucket backend, et ajoutez une politique de réponse d’erreur personnalisée qui répond avec lui aux 502 et 504 du backend, avec overrideResponseCode: 503.
Seul l’Application Load Balancer externe global dispose de réponses d’erreur personnalisées (pas les régionaux ni les classiques), et la politique ne s’applique
qu’aux réponses du backend, pas à celles que Google Front End produit lui-même. Ce chemin ne peut pas envoyer Retry-After : les en-têtes personnalisés de la source d’erreur ne sont pas ajoutés.
# Part of the URL map (gcloud compute url-maps import).defaultCustomErrorResponsePolicy: errorService: https://www.googleapis.com/compute/v1/projects/<project>/global/backendBuckets/my-maintenance errorResponseRules: - matchResponseCodes: ["502", "504"] path: /index.html overrideResponseCode: 503Enregistrez une révision de la définition de tâche du service avec MY_MAINTENANCE=true dans l’environnement du conteneur, mettez à jour le service avec elle,
et faites de même sans la variable ensuite. Avec le module OpenTofu, définissez-la plutôt dans le bloc, sous la forme settings = { maintenance = "true" },
et appliquez, puisque la prochaine application remet ce que dit le bloc : autour d’une mise à niveau, appliquez le mode, puis la nouvelle version, puis le bloc sans lui,
comme le fait Déployer sur Cloud Run.
Lorsque my serve ne peut pas s’exécuter derrière CloudFront : téléversez le index.html exporté dans un bucket S3 qui est une seconde origine
(la page d’erreur ne peut pas provenir de l’origine défaillante), et ajoutez des réponses d’erreur personnalisées pour 502 et 504 (et 503 seulement tant que my serve ne peut pas s’exécuter)
avec ResponsePagePath: /maintenance/index.html et ResponseCode: 503.
CloudFront peut ajouter Retry-After par une politique d’en-têtes de réponse avec un en-tête personnalisé, mais la politique s’applique à chaque réponse du comportement de cache ;
ne l’attachez donc que pour la maintenance et détachez-la ensuite.
La réponse fixe d’un Application Load Balancer ne peut pas porter la page exportée : son corps compte au plus 1 024 caractères et il ne définit aucun en-tête comme Retry-After.
Ne l’utilisez que pour un court texte et l’état :
{ "Type": "fixed-response", "FixedResponseConfig": { "StatusCode": "503", "ContentType": "text/plain", "MessageBody": "This server is under maintenance. Please try again later. / メンテナンス中です。しばらくしてからお試しください。" }}Sans Retry-After, les autres serveurs réessaient selon leur propre calendrier, ce que la fenêtre ci-dessus prévoit déjà.
Docker Compose
Section intitulée « Docker Compose »deploy/docker/compose.yaml transmet les paramètres de .env au serveur, et prend aussi MY_MAINTENANCE, MY_MAINTENANCE_MESSAGE et MY_MAINTENANCE_UNTIL depuis le shell.
Définissez-les et recréez le service my, puis retirez MY_MAINTENANCE et recréez-le de nouveau après le travail.
--no-deps empêche l’exécution des services ponctuels de base de données (upgrade-check, schema, upgrade) ; une mise à niveau les exécute (Mettre à niveau) :
MY_MAINTENANCE=true MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Z docker compose up -d --no-deps --force-recreate mydocker compose up -d --no-deps --force-recreate myLorsque my serve ne peut pas s’exécuter derrière nginx : servez les pages exportées depuis un répertoire, choisissez-en une selon Accept-Language,
et répondez aux 502 et 504 propres à nginx (le serveur est arrêté ou ne répond pas) avec elle, en 503.
Les 503 propres au mode maintenance passent sans changement, puisque proxy_intercept_errors reste désactivé.
map $http_accept_language $maintenance_page {    default  en.html;    ~*^ja    ja.html;}
server {    # ...    location / {        proxy_pass http://my:8080;        error_page 502 504 =503 /maintenance/$maintenance_page;    }    location /maintenance/ {        internal;        alias /srv/maintenance/;   # the -out directory of my maintenance export        add_header Retry-After 600 always;        add_header Cache-Control no-store always;    }}
microk8s (Kubernetes)
Section intitulée « microk8s (Kubernetes) »Définissez la variable sur le Deployment, ce qui déploie les pods, puis retirez-la ensuite :
microk8s kubectl set env deployment/my MY_MAINTENANCE=true MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Zmicrok8s kubectl rollout status deployment/mymicrok8s kubectl set env deployment/my MY_MAINTENANCE- MY_MAINTENANCE_UNTIL-La sonde de disponibilité sur /readyz continue de réussir en mode maintenance : le déploiement progressif aboutit donc et le Service continue d’acheminer vers les pods.
Lorsque my serve ne peut pas s’exécuter derrière le NGINX Ingress Controller (l’add-on ingress de microk8s) : servez les pages exportées depuis un petit
Deployment nginx (par exemple depuis un ConfigMap contenant index.html, en.html et ja.html) et faites-en le backend par défaut personnalisé,
le contrôleur lui confiant les réponses aux 502 et 504 du serveur (ajoutez 503 uniquement tant que my serve ne peut pas s’exécuter) :
metadata: annotations: nginx.ingress.kubernetes.io/custom-http-errors: "502,504" nginx.ingress.kubernetes.io/default-backend: my-maintenance # a Service in the same namespaceSurveillance pendant la maintenance
Section intitulée « Surveillance pendant la maintenance »/healthz,/readyz,/health/liveet/health/readyrestent à200avec{"status":"maintenance"}: les répartiteurs de charge et Kubernetes conservent les instances./api/v1/instance/healthrépond503avec{"status":"maintenance"}(Surveillance). Les moniteurs de disponibilité voient le serveur comme arrêté, à moins qu’ils ne vérifient le corps ou qu’ils aient une fenêtre de maintenance ; mettez-les en pause ou définissez la fenêtre.
Pour les LLM et les agents de programmation :llms.txt,llms-full.txt, llms-small.txt