

Cette page est une traduction automatique de la page en anglais, qui fait foi. Lire la page en anglais
Base de données : initialisation, mise à niveau et recréation
Comment les opérateurs créent la base de données, la mettent à niveau vers une nouvelle version et, uniquement sur les instances de développement et de test, l’effacent.
Le schéma se trouve dans schema/, un répertoire par module avec un fichier par base de données (schema/<NN>-<module>/sqlite.sql et postgres.sql). Le binaire du serveur contient le schéma de sa version, et
my schema apply l’applique : chaque déploiement l’exécute comme tâche ponctuelle avant le serveur, avec l’image du serveur et les
paramètres de base de données du serveur, de sorte que l’image du serveur est la seule image dont une instance a besoin.
my serve n’applique jamais le schéma. Démarré sur une base de données qui n’en a pas, le serveur répond 503 sur /readyz (voir Démarrer le serveur).
Les données qu’une modification du schéma doit reprendre (une colonne scindée en deux, une valeur déplacée vers une nouvelle table) sont réécrites par la commande
my db upgrade de l’image du serveur, qui s’exécute une fois par version après l’application du schéma. L’ordre complet figure dans Mettre à niveau.
Initialisation (application du schéma)
Section intitulée « Initialisation (application du schéma) »my schema apply n’exécute que les instructions qui amènent la base de données au schéma de sa version : sur une base vide, il crée tout,
sur une base à jour, il ne fait rien. Il peut être exécuté sans risque autant de fois que nécessaire, et chaque mise à niveau l’exécute de nouveau.
Avec my schema apply
Section intitulée « Avec my schema apply »my schema apply lit les paramètres de base de données de la configuration du serveur (database, database_url et database_dev_url,
depuis -config <file> ou l’environnement ; il n’a besoin d’aucun autre paramètre) et amène la base de données au schéma de la version du binaire :
my schema apply -dry-run # print the SQL statements it would run, and change nothingmy schema apply # run them- Il affiche les instructions SQL qu’il exécute, et les exécute dans une seule transaction : si l’une échoue, aucune ne subsiste.
Une base de données qui correspond déjà au schéma est laissée inchangée (
ok: the database matches the schema; nothing to apply). - Un plan qui supprime une table ou une colonne est refusé, et rien ne s’exécute, sauf si
-allow-destructiveest indiqué. Ne le passez que lorsque les notes de version l’exigent, après une sauvegarde. Reconstruire une table SQLite pour la modifier ne compte pas comme une suppression. - Sur PostgreSQL, il construit le schéma auquel il se compare dans un schéma temporaire de la même base de données et le supprime à la fin,
y compris en cas d’échec ; le rôle doit avoir le privilège de créer un schéma à cet endroit. S’il ne l’a pas, définissez
database_dev_urlvers une autre base où il l’a (database_dev_url). Les exécutions sur une même base de données s’attendent mutuellement : deux exécutions simultanées réussissent donc toutes les deux. - Il prend en charge
database = sqliteetdatabase = postgres, et se termine avec le code1lorsqu’il n’a rien appliqué à cause d’une erreur ou d’une suppression refusée.
À partir de v0.1.0, une mise à niveau entre des versions prises en charge ne contient jamais de différence qui fasse perdre des données ; les versions antérieures à v0.1.0 peuvent supprimer des colonnes
et des tables, et exigent -allow-destructive. Lisez le SQL avec -dry-run avant chaque mise à niveau (voir Mettre à niveau).
Via un pooler de connexions
Section intitulée « Via un pooler de connexions »my schema apply doit atteindre directement la base de données. Il détient un verrou de niveau session, qu’un pooler en mode transaction (le pooling par transaction de PgBouncer, la chaîne de connexion poolée de Neon) ne conserve pas : à travers l’un d’eux, deux exécutions simultanées se sont bloquées au lieu d’échouer. Donnez-lui une URL directe comme database_url. pool_max_conns et les autres paramètres pool_* peuvent y rester, ainsi que dans database_dev_url et stream_postgres_url : les commandes qui n’ouvrent aucun pool les ignorent. my db upgrade, my db upgrade -check et la console prennent la même URL.
my serve peut utiliser un pooler en mode transaction, à condition que :
- le pooler gère les requêtes préparées au niveau du protocole, que le serveur utilise pour chaque requête : PgBouncer 1.21 ou ultérieur avec
max_prepared_statementssupérieur à 0, ce qu’a la chaîne de connexion poolée de Neon. Derrière un pooler qui ne les gère pas, des requêtes échouent au hasard avecprepared statement ... does not existoualready exists: ajoutezdefault_query_exec_mode=execà l’URL, ce qui les évite au prix d’un aller-retour de plus par requête. stream_postgres_urlcontienne une URL directe lorsquestream = postgres, puisqueLISTENappartient à une session. Un listener sur une URL poolée se connecte puis ne reçoit rien.- l’URL ne comporte ni
search_pathni autre paramètre que le pooler refuse à la connexion : PgBouncer ferme une telle connexion, sauf siignore_startup_parametersle liste.
Docker Compose
Section intitulée « Docker Compose »Dans deploy/docker/compose.yaml, trois services ponctuels de l’image du serveur s’exécutent dans cet ordre, chacun seulement
après la réussite du précédent, et le serveur (my) démarre en dernier :
| Service | Exécute |
|---|---|
upgrade-check |
my db upgrade -check (réussit sur une base vide) |
schema |
my schema apply, sur /data/my.db ou, avec la couche compose.postgres.yaml, sur son PostgreSQL (fichiers Docker Compose) |
upgrade |
my db upgrade |
cd deploy/dockerdocker compose up -d # pulls the image of MY_VERSION; the three one-off services run in order, then my startscurl -fsS localhost:8080/readyz # ready when it answers {"status":"ok"}docker compose exec -T my my admin create -username alice -email alice@example.com < password.txt- Si l’un des trois échoue,
myne démarre pas. Lisez sa sortie avecdocker compose logs upgrade-check(ouschema,upgrade). - La création des administrateurs est décrite dans Administrateurs et rôles.
Autres plateformes
Section intitulée « Autres plateformes »Sans Compose, exécutez my schema apply de l’image du serveur comme tâche ponctuelle (un Job ou un init container Kubernetes, un job Cloud Run, etc.),
avec les mêmes paramètres de base de données que le serveur :
# SQLite: mount the volume that holds the database file at /datadocker run --rm -v my_data:/data -e MY_DATABASE=sqlite -e MY_DATABASE_URL=/data/my.db my schema apply
# PostgreSQLdocker run --rm -e MY_DATABASE=postgres -e MY_DATABASE_URL='postgres://my:...@db.example/my' my schema apply
Le pool de connexions
Section intitulée « Le pool de connexions »Le pool de PostgreSQL suit les paramètres pool_* de database_url : pool_max_conns (par défaut le plus grand de 4 et du nombre de CPU) et pool_min_conns, les connexions qu’il conserve lorsque rien n’est demandé, pool_max_conn_idle_time (30 minutes) fermant les autres. Définissez pool_min_conns pour une instance dont les requêtes sont très espacées, faute de quoi chacune ouvre une connexion.
SQLite accepte aussi pool_max_conns, avec la même valeur par défaut, et pool_max_idle_conns, le nombre maximal de connexions inactives qu’il conserve, un plafond et non un plancher comme pool_min_conns (par défaut toutes, et aucune n’est fermée avec le temps, de sorte qu’une instance calme répond aussitôt). Une nouvelle connexion analyse le schéma avant sa première requête, ce pourquoi le pool conserve ses connexions.
Mettre à niveau
Section intitulée « Mettre à niveau »Une mise à niveau vers une nouvelle version exécute toujours ces étapes dans cet ordre, avec l’image de serveur de la nouvelle version :
- Sauvegardez la base de données (et, avec le stockage de blobs sur le système de fichiers, les médias). Voir Sauvegarder.
my db upgrade -check. Il ne change rien. Il se termine avec1lorsque le nouveau schéma supprimerait des données que la base de données n’a pas encore reprises, et nomme la version par laquelle passer d’abord ; arrêtez-vous alors et suivez Sauter des versions. Une base de données vide passe.my schema apply, comme dans Initialiser. Vérifiez d’abord le SQL avec-dry-run.my db upgrade. Il exécute chaque étape de mise à niveau des données de la version que la base de données n’a pas encore enregistrée, reconstruit les projections que ces étapes nomment, et enregistre chaque étape. Réexécuté, il ne fait rien. Si une étape échoue, il se termine avec1; les étapes terminées restent enregistrées, et le réexécuter reprend à partir de celle qui a échoué.- Démarrez le nouveau serveur. Il répond
503sur/readyzet journalise les étapes manquantes jusqu’à ce que chaque étape de mise à niveau des données de sa version soit enregistrée.
my serve n’exécute jamais my db upgrade -check, my schema apply ni my db upgrade ; ce sont des jobs ponctuels. N’en exécutez qu’un seul à la fois sur une base de données.
Exécuter les étapes dans un seul job
Section intitulée « Exécuter les étapes dans un seul job »my upgrade exécute les étapes 2 à 4 dans un seul processus, après les vérifications de my config check, de sorte qu’un seul job ponctuel (une exécution de job Cloud Run,
une tâche ECS, un Job Kubernetes) porte toute la migration :
my config checkmy db upgrade -checkmy schema apply, avec-allow-destructivelorsquemy upgradele reçoitmy db upgrade
Il s’arrête à la première étape qui échoue et se termine avec le code de cette étape ; les étapes suivantes ne s’exécutent pas. Chaque étape affiche une ligne qui la nomme,
comme ==> my schema apply, puis la sortie de cette commande, de sorte que le journal du job montre où il s’est arrêté. Après avoir corrigé la cause, exécutez
my upgrade de nouveau : les étapes terminées ne trouvent plus rien à faire. -config <file> est transmis à chaque étape.
my upgrade -dry-run exécute my config check, my db upgrade -check et my schema apply -dry-run, et ne change rien : lisez le SQL qu’il
affiche avant la mise à niveau. Sauvegardez la base de données avant my upgrade, comme à l’étape 1 ; il ne passe pas en mode maintenance et ne démarre pas
le serveur.
La plupart des versions n’ajoutent aucune étape de mise à niveau des données : my db upgrade -check affiche ok: the database can be upgraded to this release et, sur une
base de données qui a enregistré les étapes des versions précédentes, my db upgrade affiche ok: no data upgrade step to run. Une nouvelle base de données enregistre
chaque étape de la version dès son premier my db upgrade, sans rien à réécrire. Exécutez-les quand même tous les deux, afin que la procédure ne dépende pas de la lecture de
chaque note de version.
La section Mise à niveau des notes de version liste les étapes de chaque version.
Le serveur pendant une mise à niveau
Section intitulée « Le serveur pendant une mise à niveau »Les mises à niveau sans interruption ne sont pas garanties. Le serveur précédent continue de fonctionner sur le nouveau schéma pendant le court laps de temps entre les étapes 3 et 5,
mais il ne peut pas participer aux étapes de mise à niveau des données. Passez en mode maintenance pour la mise à niveau : en mode maintenance,
my serve n’ouvre aucune connexion à la base de données, de sorte que la sauvegarde est cohérente et que rien n’écrit pendant l’exécution des étapes.
Limitez la fenêtre de maintenance à quelques heures (combien de temps).
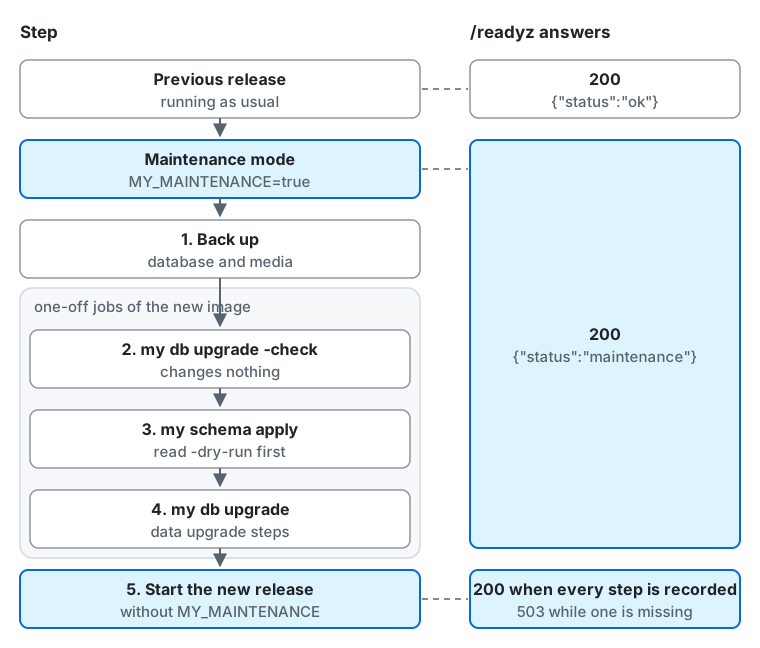
De haut en bas du schéma :
- Version précédente. Le serveur fonctionne normalement, et
/readyzrépond200avec{"status":"ok"}. - Mode maintenance. Redéployez avec
MY_MAINTENANCE=true. À partir de là et jusqu’au démarrage de la nouvelle version,/readyzrépond200avec{"status":"maintenance"}: le répartiteur de charge conserve donc les instances tandis que rien n’atteint la base de données. - 1. Sauvegardez la base de données et les médias.
- 2 à 4 : les tâches ponctuelles de la nouvelle image.
my db upgrade -checkne change rien ;my schema applys’exécute après que vous avez lu son-dry-run;my db upgradeexécute les étapes de mise à niveau des données. - 5. Démarrez la nouvelle version sans
MY_MAINTENANCE./readyzrépond200avec{"status":"ok"}dès que chaque étape de mise à niveau des données de la version est enregistrée, et503tant qu’il en manque une (ou que le schéma n’est pas appliqué).
Avec Docker Compose, docker compose up remplace le conteneur en mode maintenance avant l’exécution des tâches ponctuelles : rien ne répond donc
sur /readyz pendant les étapes 2 à 4 (Docker Compose).
Vérifier le SQL avec -dry-run
Section intitulée « Vérifier le SQL avec -dry-run »Avant que l’étape 3 n’applique quoi que ce soit, exécutez my schema apply -dry-run et lisez ce qu’il exécuterait.
Les ajouts (CREATE TABLE, ADD COLUMN, CREATE INDEX) sont ce que contiennent la plupart des versions. Une table de projection peut aussi être reconstruite,
my db upgrade la remplissant alors de nouveau à partir de ses événements. Un DROP de toute autre chose, ou un changement de type, devrait figurer dans la section
Breaking changes des notes de version ; si ce n’est pas le cas, arrêtez-vous et signalez-le avant d’appliquer. my schema apply refuse un plan qui supprime une table
ou une colonne, sauf si -allow-destructive est indiqué.
Docker Compose
Section intitulée « Docker Compose »docker compose up -d exécute lui-même les étapes 2 à 5, dans l’ordre (voir le tableau dans Initialisation). Si l’une d’elles échoue, le nouveau serveur ne démarre pas.
cd deploy/docker
# 1. Switch to the maintenance mode. --no-deps keeps the one-off services from running.MY_MAINTENANCE=true docker compose up -d --no-deps --force-recreate my
# 2. Back up the volume (database and media) while the maintenance mode holds no connection.docker run --rm -v my_data:/data -v "$PWD":/backup busybox tar czf /backup/my-data-$(date +%Y%m%d%H%M).tar.gz -C /data .
# 3. Set MY_VERSION in .env to the new version (0.2.0, or its digest form 0.2.0@sha256:... from the notes), and pull it.docker compose pull
# 4. Check the SQL that the schema service will run.docker compose run --rm --no-deps upgrade-checkdocker compose run --rm --no-deps schema schema apply -dry-run
# 5. Upgrade: upgrade-check, schema, upgrade, then my starts again without the maintenance mode.docker compose up -dcurl -fsS localhost:8080/readyz
docker compose up remplace le conteneur my avant l’exécution des services ponctuels, et ne démarre le nouveau qu’après la réussite des trois.
Si l’un échoue, docker compose up le signale et le serveur reste arrêté : placez entre-temps devant lui la page de maintenance exportée.
Lisez docker compose logs <service>, puis corrigez la cause et exécutez de nouveau docker compose up -d, ou revenez en arrière.
Le nom de volume my_data est le nom du projet Compose (my) suivi du nom du volume (data).
MY_VERSION est la seule chose qu’une mise à niveau modifie, et rien ne la modifie à votre place : il n’y a pas de tag latest, et 0.1 ne bouge qu’au sein de v0.1. Avec MY_VERSION=0.1, l’étape 3 se réduit à docker compose pull, qui récupère le dernier correctif.
Pour compiler plutôt depuis les sources, extrayez le tag de la nouvelle version et utilisez docker compose -f compose.yaml -f compose.build.yaml build à l’étape 3, et les mêmes options -f aux autres étapes.
Kubernetes
Section intitulée « Kubernetes »Exécutez les étapes 2 à 4 comme un seul Job avant de déployer la nouvelle image. Les init containers s’exécutent l’un après l’autre, chacun seulement après la réussite du précédent, et le conteneur principal s’exécute en dernier : un échec arrête donc le Job avant l’étape suivante. Donnez aux conteneurs la même configuration qu’au Deployment.
apiVersion: batch/v1kind: Jobmetadata: name: my-upgrade-v0-2-0spec: backoffLimit: 0 template: spec: restartPolicy: Never initContainers: - name: upgrade-check image: ghcr.io/mycroblog/my:0.2.0 args: [db, upgrade, -check] envFrom: [{ secretRef: { name: my-config } }] # the Deployment's settings - name: schema image: ghcr.io/mycroblog/my:0.2.0 args: [schema, apply] envFrom: [{ secretRef: { name: my-config } }] containers: - name: upgrade image: ghcr.io/mycroblog/my:0.2.0 args: [db, upgrade] envFrom: [{ secretRef: { name: my-config } }]kubectl set env deployment/my MY_MAINTENANCE=true && kubectl rollout status deployment/my# back up, and check the SQL with a one-off Pod of the new image: my schema apply -dry-runkubectl apply -f my-upgrade-v0-2-0.yamlkubectl wait --for=condition=complete --timeout=30m job/my-upgrade-v0-2-0kubectl set image deployment/my my=ghcr.io/mycroblog/my:0.2.0kubectl set env deployment/my MY_MAINTENANCE-kubectl rollout status deployment/mySi le Job échoue, kubectl logs job/my-upgrade-v0-2-0 -c upgrade-check (ou -c schema, -c upgrade) montre pourquoi, et le Deployment reste sur l’image précédente.
Avec SQLite sur un volume, montez le même volume dans le Job et arrêtez d’abord les pods du Deployment : SQLite n’admet qu’un seul écrivain.
Cloud Run
Section intitulée « Cloud Run »Avec le module OpenTofu, une mise à niveau consiste à appliquer la nouvelle version, ce qui exécute my upgrade dans le job de migration avant que les services prennent
la nouvelle image, et s’arrête là en cas d’échec : voir Déployer sur Cloud Run. À la main :
Les jobs Cloud Run exécutent un conteneur chacun ; créez donc un job par étape et exécutez-les dans l’ordre avec --wait, qui échoue lorsque le job échoue.
Donnez aux jobs les mêmes variables d’environnement et secrets qu’au service.
gcloud run services update my --region=asia-northeast1 --update-env-vars=MY_MAINTENANCE=true# back up (see below)
gcloud run jobs deploy my-upgrade-check --region=asia-northeast1 --image=ghcr.io/mycroblog/my:0.2.0 \  --args=db,upgrade,-check --set-env-vars=... --set-secrets=...gcloud run jobs deploy my-schema --region=asia-northeast1 --image=ghcr.io/mycroblog/my:0.2.0 \  --args=schema,apply --set-env-vars=... --set-secrets=...gcloud run jobs deploy my-upgrade --region=asia-northeast1 --image=ghcr.io/mycroblog/my:0.2.0 \  --args=db,upgrade --set-env-vars=... --set-secrets=...
gcloud run jobs execute my-upgrade-check --region=asia-northeast1 --wait &&  gcloud run jobs execute my-schema --region=asia-northeast1 --wait &&  gcloud run jobs execute my-upgrade --region=asia-northeast1 --wait &&  gcloud run deploy my --region=asia-northeast1 --image=ghcr.io/mycroblog/my:0.2.0 --remove-env-vars=MY_MAINTENANCE
Pour vérifier d’abord le SQL, déployez le job de schéma avec --args=schema,apply,-dry-run, exécutez-le et lisez ses journaux avant de le redéployer pour l’application.
Sauvegarder
Section intitulée « Sauvegarder »Faites la sauvegarde après que le serveur a cessé d’écrire (en mode maintenance, ou arrêté) et avant toute étape de la mise à niveau. Sauvegarde et restauration couvre chaque élément en détail ; pour une mise à niveau :
-
SQLite : copiez le fichier de base de données avec ses fichiers
-walet-shm, tant qu’aucun processus ne l’a ouvert. Avec Compose, letardu volume ci-dessus couvre aussi les médias dans/data/blobs. -
PostgreSQL :
pg_dumpau format personnalisé, que litpg_restore.Fenêtre de terminal pg_dump --format=custom --file=my-$(date +%Y%m%d%H%M).dump "postgres://my:...@db.example/my"La sauvegarde propre à une base de données gérée (une sauvegarde à la demande Cloud SQL, un instantané RDS) convient aussi ; faites-la au même moment.
-
Médias : le stockage de blobs sur système de fichiers est un répertoire à copier avec la base de données.
-
La KEK n’est pas dans la base de données. Conservez-la là où elle se trouve déjà ; une base de données restaurée a besoin de la même KEK.
Revenir en arrière
Section intitulée « Revenir en arrière »Il n’existe aucune migration inverse. Pour revenir en arrière, restaurez la sauvegarde faite avant la mise à niveau, puis démarrez la version précédente :
- Arrêtez le nouveau serveur (ou passez-le en mode maintenance).
- Restaurez la sauvegarde : avec Compose, extrayez l’archive dans le volume vidé
(
docker run --rm -v my_data:/data -v "$PWD":/backup busybox sh -c 'rm -rf /data/* && tar xzf /backup/<archive> -C /data') ; avec PostgreSQL,pg_restore --clean --if-exists --dbname=<url> <dump>. - Démarrez l’image de la version précédente (avec Compose, remettez
MY_VERSIONà la version précédente, puisdocker compose up -d).
Tout ce que la nouvelle version a écrit après la mise à niveau est perdu : revenez donc en arrière peu après la mise à niveau, avant que l’instance ne se fédère beaucoup.
Sauter des versions
Section intitulée « Sauter des versions »Chaque version prend en charge les mises à niveau depuis la même version mineure (par exemple v0.2.1 vers v0.2.4) et depuis la dernière version corrective de la version
mineure précédente (la dernière v0.1.x vers v0.2.y). Les versions correctives ne suppriment jamais de colonnes ni de tables : au sein d’une version mineure, n’importe quel ordre convient.
Pour franchir plus d’une version mineure, passez successivement par la dernière version corrective de chaque version mineure, en exécutant toute la procédure à chaque fois.
De v0.1.3 à v0.4.0, par exemple : la dernière v0.1.x, puis la dernière v0.2.x, puis la dernière v0.3.x, puis v0.4.0.
my db upgrade -check arrête un saut qui ferait perdre des données et nomme la version par laquelle passer ; rien n’a changé à ce stade.
Vérifier et reconstruire les projections
Section intitulée « Vérifier et reconstruire les projections »Certaines tables sont des projections : le serveur les dérive des événements et des ressources de leur module (les restrictions d’un compte à partir de ses actions de modération, par exemple). Le worker vérifie chaque projection une fois par jour et corrige toute différence qu’il trouve. Pour en vérifier ou en corriger une à la main :
my projection list # each projection with its module and tablesmy projection verify [<name>] # derive every projection, or the one named, and print the rows that differ; changes nothingmy projection rebuild [<name>] # derive them the same way and write the difference<name>est une projection ou l’une de ses tables.verifyaffiche les lignes que les tables contiennent mais que les sources ne dérivent pas (-) et les lignes que les sources dérivent mais qui manquent aux tables (+), et se termine avec le code1si certaines diffèrent.rebuildécrit au plus 500 lignes par transaction, de sorte que les lecteurs ne voient jamais une projection vidée. Exécutez-le lorsque l’instance est calme : une ligne qui change pendant la reconstruction garde sa nouvelle valeur, et unverifyultérieur signale toute différence restante.
Recréer (effacer toutes les lignes)
Section intitulée « Recréer (effacer toutes les lignes) »Recréer signifie vider la base de données et appliquer de nouveau le schéma. À partir de v0.1.0, la recréation est réservée aux instances de développement et de test.
Ne recréez jamais une instance publique qui se fédère avec d’autres serveurs.
Toutes les lignes sont perdues et ne peuvent pas être récupérées. Les clés de compte enveloppées avec la clé de chiffrement de clés (KEK) sont perdues elles aussi : un compte recréé sous le même nom d’hôte reçoit donc une clé différente et est un Actor différent pour les autres serveurs, et ses relations d’abonnement distantes ne reviennent pas. Une instance publique qui ne peut pas appliquer une modification du schéma revient en arrière depuis sa sauvegarde à la place.
Il n’existe aucune commande my qui efface une base de données : supprimez-la avec les outils de la base de données, puis appliquez de nouveau le schéma.
La base vide n’a ni host ni account_domain enregistrés : le prochain démarrage enregistre donc les valeurs configurées.
Docker Compose
Section intitulée « Docker Compose »cd deploy/dockerdocker compose stop my # stop the serverdocker run --rm -v my_data:/data busybox rm -f /data/my.db /data/my.db-wal /data/my.db-shmdocker compose up -d # the one-off services apply the schema to the empty database, then my starts- Les médias téléversés et traités (
/data/blobs) restent. Pour les effacer avec la base de données, supprimez le volume nommé avecdocker compose down -v, puis exécutezdocker compose up -d. Sans-v, le volume est conservé. - Pour en garder d’abord une copie, arrêtez le serveur et copiez
my.db(avec ses fichiers-walet-shm) depuis le volume.
PostgreSQL
Section intitulée « PostgreSQL »Supprimez la base de données et créez-la de nouveau, vide, avec le même propriétaire (ou avec la console de la base de données gérée), puis exécutez my schema apply :
# stop every server and job that uses the database firstdropdb --maintenance-db="postgres://postgres:...@db.example/postgres" mycreatedb --maintenance-db="postgres://postgres:...@db.example/postgres" --owner=my mymy schema applyPour les LLM et les agents de programmation :llms.txt,llms-full.txt, llms-small.txt