

Cette page est une traduction automatique de la page en anglais, qui fait foi. Lire la page en anglais
Vue d’ensemble d’un serveur mycroblog
La première page à lire avant de lancer un serveur. mycroblog est un microblog qui se fédère
avec le reste du fediverse via ActivityPub ; my est son logiciel serveur, un binaire unique qui contient le serveur, le worker
de tâches, le client web et les commandes qui s’en occupent. Cette page présente de quoi se compose un serveur, ce que
vous choisissez par la configuration, comment un petit serveur devient un grand serveur, et où lire ensuite.
De quoi un serveur est fait
Section intitulée « De quoi un serveur est fait »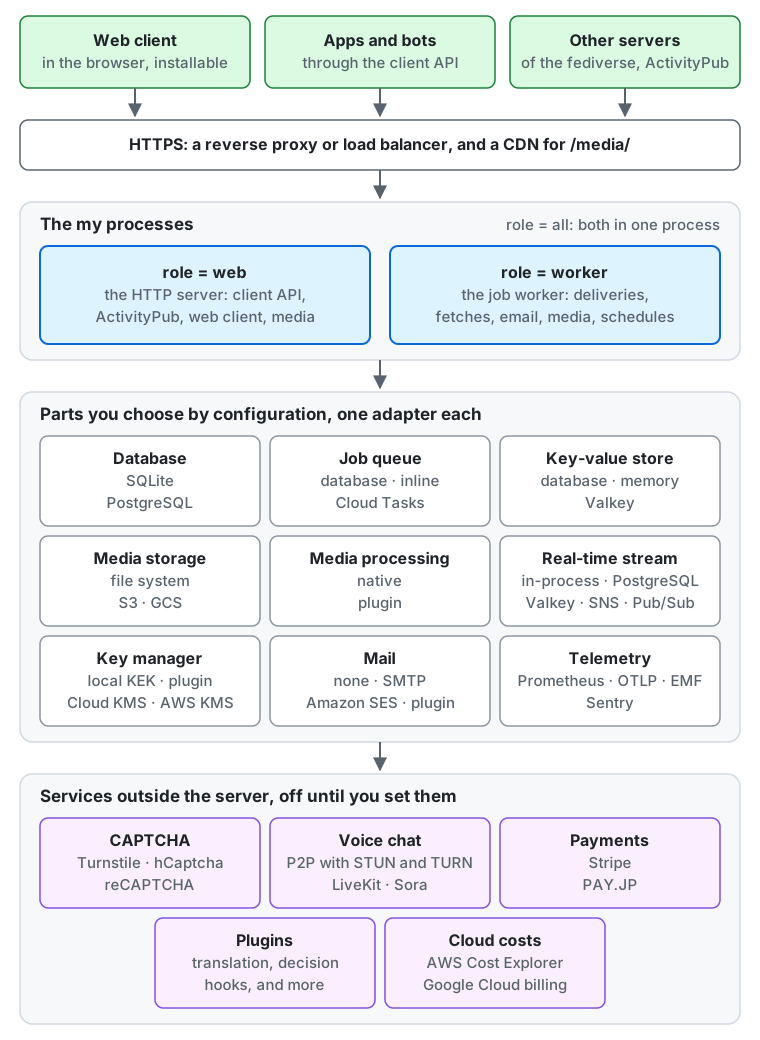
Du haut du schéma vers le bas :
- Qui se connecte. Les personnes utilisent le client web dans leur navigateur (il peut être installé comme une application), les applications et les bots utilisent l’API cliente, et les autres serveurs du fédivers livrent et récupèrent des publications via ActivityPub. Tous atteignent le serveur en HTTPS.
- Devant le serveur. Par défaut,
myparle en HTTP simple ; un proxy inverse ou un répartiteur de charge termine donc le HTTPS devant lui. Sur une seule machine,mypeut servir lui-même le HTTPS à la place (servir le HTTPS depuis le serveur). Un CDN devant les fichiers de médias est facultatif. - Les processus
my. Chaque processus exécutemy serve, et sonroledit ce qu’il exécute :weble serveur HTTP,workerle worker de jobs, qui livre les publications, récupère des données d’autres serveurs, envoie des e-mails, traite les médias et exécute les jobs périodiques, etall, la valeur par défaut, les deux dans un seul processus. - Les composants que vous choisissez. Chaque composant au milieu du schéma a un paramètre qui choisit son adaptateur, listé dans la section suivante.
- Les services extérieurs au serveur. Le CAPTCHA, le chat vocal, les paiements, les plugins et l’import des coûts du cloud restent chacun désactivés tant que vous ne les configurez pas, et le serveur appelle alors le service que vous nommez.
Les composants que vous choisissez par la configuration
Section intitulée « Les composants que vous choisissez par la configuration »Chaque composant est un paramètre de la référence de la configuration, défini dans un fichier TOML ou comme une
variable d’environnement (MY_ et la clé en majuscules, comme MY_DATABASE). La première option de chaque liste est la valeur par défaut.
Lorsqu’un composant conserve des données, choisissez-le avant le premier démarrage : les données ne se déplacent pas d’elles-mêmes lorsque le paramètre change.
| Composant | Paramètre | Options | À lire ensuite |
|---|---|---|---|
| Base de données | database |
sqlite (un fichier), postgres (PostgreSQL et services compatibles) |
Base de données, sauvegarde |
| File de jobs | queue |
db (une table dans la base de données), inline (exécute chaque job aussitôt dans le même processus, pour les tests et le développement), cloudtasks (Google Cloud Tasks réveille le serveur pour chaque job ; exige PostgreSQL) |
La file de jobs |
| Magasin clé-valeur, pour les caches, les limites de débit et les réponses conservées un jour pour les écritures renvoyées | kv |
db (une table dans la base de données), memory (chaque processus de son côté), valkey (Valkey ou un autre serveur au protocole Redis, partagé par tous les processus) |
kv |
| Stockage des médias | blob |
fs (un répertoire), s3 (Amazon S3, Cloudflare R2, MinIO, Garage et autres stockages compatibles S3), gcs (Google Cloud Storage) |
Fichiers Docker Compose, sauvegarder les médias |
| Traitement des médias | media_image, media_video, media_audio, un pour chaque type de fichier |
native (dans le serveur), plugin (un plugin à vous convertit les fichiers de ce type) |
Convertir des médias |
| Flux en temps réel entre les processus | stream |
hub (dans un seul processus), postgres (LISTEN / NOTIFY), valkey, sns (Amazon SNS et SQS), pubsub (Google Cloud Pub/Sub) |
stream |
| Gestionnaire de clés, qui chiffre les clés privées des comptes | key_manager |
local (une clé de chiffrement de clés que vous conservez), gcpkms (Google Cloud KMS), awskms (AWS KMS), plugin |
Gérer la clé |
mail |
none, smtp, ses (Amazon SES), plugin |
Envoyer des e-mails | |
| CAPTCHA | captcha |
none, turnstile (Cloudflare Turnstile), hcaptcha, recaptcha (Google reCAPTCHA v2) |
CAPTCHA |
| Chat vocal | voice |
off, p2p (de navigateur à navigateur, avec TURN depuis voice_turn : none, coturn ou cloudflare), livekit, sora |
Chat vocal |
| Paiements des soutiens | payments |
none, stripe, payjp (PAY.JP) |
Soutiens, Stripe, PAY.JP |
| Plugins | plugin_<kind>_address |
aucun par défaut ; une adresse pour chaque type : translator, search, billing, mailer, media_image, media_video, media_audio, key_manager, et les hooks de décision inbound.status, local.status, inbound.follow, signup.check, media.check, inbound.actor, local.profile |
Plugins, hooks de décision |
| Traduction des publications | translator_<provider>_*, plugin_translator_address |
aucune (seulement la traduction propre au navigateur) ; libretranslate, deepl, google (Google Cloud Translation), aws (Amazon Translate), ou un plugin à vous devant le service que vous choisissez |
Traduire des publications, un plugin de traduction |
| Recherche en texte intégral des publications | search |
none ; ou elasticsearch, opensearch ou meilisearch (moteurs de recherche) ; ou plugin, un plugin à vous devant un autre moteur |
Recherche en texte intégral, un plugin de recherche |
| CDN pour les médias | media_origin |
non défini (le serveur sert les médias depuis sa propre origine), ou l’origine de votre CDN | Servir les médias par un CDN |
| Coûts du cloud | billing_sources |
aucun, ou l’un quelconque de aws (AWS Cost Explorer), gcp (l’export de facturation ou le budget de Google Cloud), cloudflare (les frais d’utilisation de Cloudflare), plugin |
Importer les coûts du cloud |
| Métriques | metrics_exporter |
none, prometheus, otlp (OpenTelemetry), emf (CloudWatch) |
Métriques, alertes |
| Traces | traces_exporter |
none, otlp |
Traces |
| Signalements d’erreurs | errors_exporter |
none (la ligne de journal et les groupes d’erreurs seulement), sentry (Sentry, GlitchTip, Datadog), otlp |
Signalement des erreurs |
Le binaire publié et l’image de conteneur contiennent tous les adaptateurs du tableau.
my config check signale d’un coup tous les problèmes de la configuration, avant que vous démarriez le serveur
(liste de contrôle de production).
D’un petit serveur à un grand
Section intitulée « D’un petit serveur à un grand »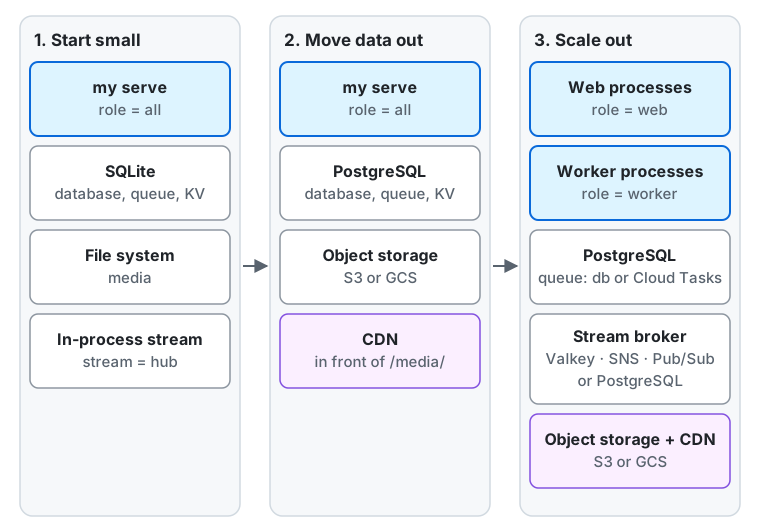
- Commencer petit. Un processus avec
role = all, sur SQLite, avec les médias sur le système de fichiers et les valeurs par défaut pour le reste : la file et le magasin clé-valeur dans la base de données, et le flux en temps réel dans le processus. Les fichiers Docker Compose dedeploy/dockerdémarrent cette configuration sur une machine (déployer avec Docker Compose). Elle convient à un serveur personnel ou petit.stream = hubn’atteint que le processus dans lequel il s’exécute ; cette configuration reste donc à un seul processus. - Sortir les données. PostgreSQL pour la base de données, un bucket compatible S3 ou Google Cloud Storage pour les médias, et un CDN devant les médias. Le serveur reste un seul processus, mais il ne dépend plus d’un seul disque, et les processus de l’étape suivante peuvent partager les données. Décidez-le avant le premier démarrage si vous le pouvez : déplacer ensuite les données de SQLite et du système de fichiers est un travail à part (ce qu’il faut sauvegarder liste ce qui doit être déplacé).
- Monter en charge. Exécutez des processus avec
role = webpour les requêtes etrole = workerpour les jobs, autant que chacun en exige, et répartissez les workers par type de job (répartir les workers). Avec plus d’un processus, le flux en temps réel a besoin d’un courtier qui atteint tous les processus (postgres,valkey,snsoupubsub), et le magasin clé-valeur doit être partagé (dbouvalkey), carmemorygarde séparées les limites de débit et les réponses aux écritures renvoyées de chaque processus. La file de jobs reste dans PostgreSQL, ou passe à Google Cloud Tasks (Cloud Tasks).
Le déploiement sur Cloud Run est un exemple de configuration entre la deuxième et la troisième étape :
role = all sur Cloud Run, PostgreSQL sur Neon, les médias dans Cloud Storage, Cloud Tasks pour les jobs et Pub/Sub pour le
flux, sans aucune instance en cours d’exécution tant que personne n’utilise le serveur.
Où aller ensuite
Section intitulée « Où aller ensuite »Lisez les guides de l’opérateur dans cet ordre :
- Démarrer : lancer le serveur ou le déployer sur Cloud Run, puis parcourez la liste de contrôle de production avant de l’ouvrir aux utilisateurs.
- Configurer l’instance : ses paramètres, l’inscription, les fournisseurs de connexion externes, l’e-mail, le CAPTCHA, le CDN, les aperçus de liens, et les moteurs de recherche et robots d’IA.
- Activer des fonctionnalités : la modération, les relais, les webhooks, les plugins et les hooks de décision, le chat vocal, la recherche plein texte, les soutiens et leurs paiements, et l’import des coûts cloud.
- L’exploiter au quotidien : la supervision, les alertes, les rapports d’erreurs, la maintenance, la sauvegarde, la base de données, la clé de chiffrement de clés, et les administrateurs et rôles.
- Juridique et fermeture : les modèles de politique de confidentialité et de registre des traitements, et la fermeture du service.
La référence de configuration liste tous les paramètres, et la référence des tâches toutes les tâches que les workers exécutent.
Pour les LLM et les agents de programmation :llms.txt,llms-full.txt, llms-small.txt