

Cette page est une traduction automatique de la page en anglais, qui fait foi. Lire la page en anglais
Sauvegarde et restauration
Ce qu’il faut sauvegarder, comment réaliser chaque sauvegarde pendant que l’instance continue de fonctionner, comment restaurer une instance à partir de celles-ci et comment répéter une restauration avant d’en avoir besoin. Les mises à niveau font aussi l’objet d’une sauvegarde ; Mise à niveau détaille les étapes qui l’entourent.
Ce qu’il faut sauvegarder
Section intitulée « Ce qu’il faut sauvegarder »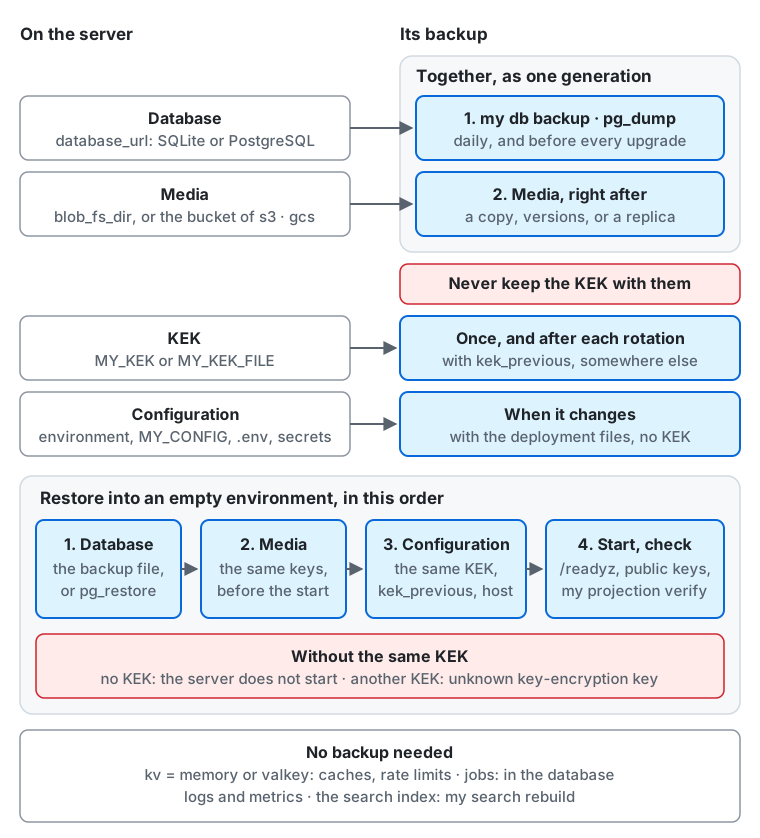
Du haut du schéma vers le bas :
- La base de données (
database_url: SQLite ou PostgreSQL) est sauvegardée en premier, avecmy db backupoupg_dump, chaque jour et avant chaque mise à niveau. - Les médias (
blob_fs_dir, ou le bucket du magasin de blobss3ougcs) sont sauvegardés juste après, sous forme de copie, de versions du bucket ou de réplica. Les deux sauvegardes forment une même génération, conservée ensemble, à l’écart du serveur et chiffrée. - La KEK (
MY_KEKouMY_KEK_FILE) est sauvegardée une fois et après chaque rotation, aveckek_previous, et jamais au même endroit que les sauvegardes de la base de données. Aveckey_manager = gcpkmsouawskms, la KEK reste dans le KMS : gardez la clé dekms_keyactivée aussi longtemps que vous conservez des sauvegardes qui en ont besoin (Mettre hors service une clé AWS KMS). - La configuration (l’environnement,
MY_CONFIG,.envet les secrets) est copiée avec les fichiers de déploiement lorsqu’elle change, sans la KEK. - Une restauration se fait dans un environnement vide, dans cet ordre : la base de données, puis les médias avec les mêmes clés avant le démarrage du serveur,
puis la configuration avec la même KEK,
kek_previousethost; ensuite le serveur démarre et vous vérifiez/readyz,my projection verifyet les clés publiques des acteurs (Restauration). Sans la KEK, le serveur ne démarre pas, et avec une autre, la lecture d’un secret échoue avecunknown key-encryption key(Sans la bonne KEK). - Aucune sauvegarde n’est nécessaire pour le magasin clé-valeur avec
kv = memoryouvalkey(caches et limites de débit), les tâches (elles sont dans la base de données), les journaux et les métriques, ni l’index d’un moteur de recherche, quemy search rebuildrecrée.
| Quoi | Où cela se trouve | Sauvegarde | Perdu sans sauvegarde |
|---|---|---|---|
| La base de données | le fichier SQLite (database_url) ou la base de données PostgreSQL |
SQLite ou PostgreSQL | tout : comptes, publications, abonnements, paramètres |
| Les médias | le répertoire blob_fs_dir du magasin de blobs fs, ou le bucket blob_s3_bucket du magasin de blobs s3 ou blob_gcs_bucket du magasin de blobs gcs |
Médias ou Médias dans un bucket | les images, vidéos et fichiers audio téléversés, ainsi que les fichiers distants en cache |
| La KEK | là où vous conservez MY_KEK ou le fichier de MY_KEK_FILE (secrets/kek avec Compose ; jamais dans la base de données) |
La KEK, séparément de la base de données | la clé privée de chaque acteur et avec elle l’identité de l’acteur dans le fédivers, ainsi que les autres secrets que stocke la base de données |
| La configuration | les variables d’environnement, le fichier de configuration (MY_CONFIG), les secrets (MY_VAPID_PRIVATE_KEY, clés de messagerie et de paiement), .env avec Compose |
copiez-les avec vos fichiers de déploiement | rien dans les données, mais l’instance ne peut pas démarrer de la même façon ; modifier host casse chaque URL fédérée |
Ce qui n’a pas besoin de sauvegarde :
- Le magasin clé-valeur (
kv). Aveckv = db, il fait partie de la base de données. Aveckv = memoryoukv = valkey, il contient des caches, des compteurs de limite de débit et des états de courte durée, comme une connexion qui attend son second facteur. Après une restauration avec un Valkey vide, les caches se remplissent à nouveau, les limites de débit repartent de zéro, et une connexion ou un appel vocal en cours doit recommencer. - La file de tâches (
queue). Avecqueue = dbetqueue = cloudtasks, les tâches font partie de la base de données et reviennent avec elle. Les tâches de Cloud Tasks ne portent qu’un signal pour une tâche de la base de données ; après une restauration, le serveur signale à nouveau les tâches échues en quelques minutes. - Les journaux et les métriques, que le serveur ne relit pas.
- L’index d’un moteur de recherche, si vous en avez un.
my search rebuildle recrée à partir de la base de données. Si vous faites des instantanés du moteur, ils contiennent le texte des publications, y compris celles supprimées après l’instantané ; traitez-les donc comme des sauvegardes de la base de données (Recherche en texte intégral).
La clé VAPID de Web Push est un secret de la configuration. Une nouvelle clé interrompt les notifications push vers tous les abonnements existants (Clé VAPID de Web Push) ; conservez-la donc avec la configuration.
À quelle fréquence et où
Section intitulée « À quelle fréquence et où »- Base de données : au moins une fois par jour, et avant chaque mise à niveau. Conservez plusieurs générations, par exemple 7 sauvegardes quotidiennes, 4 hebdomadaires et 3 mensuelles, afin qu’une erreur remarquée tardivement puisse encore être annulée. Un PostgreSQL géré avec restauration à un instant donné couvre les jours que sa rétention conserve.
- Médias : avec la base de données, à chaque fois (voir L’ordre de la base de données et des médias).
- KEK et configuration : lorsqu’elles changent. Une rotation de la KEK est un changement : sauvegardez la nouvelle KEK avant de l’utiliser, et conservez la précédente
tant que
kek_previousla liste. - Où : à l’écart du serveur et de son disque, dans un autre domaine de défaillance (une autre machine, une autre région, un autre fournisseur ou compte). Une sauvegarde sur le disque du serveur lui-même ne survit pas à la perte de ce disque.
- Chiffrement : la sauvegarde de la base de données contient des adresses e-mail, des empreintes de mots de passe et des messages directs ; chiffrez-la au repos
(un bucket chiffré, ou chiffrez le fichier avec
ageougpgavant le téléversement). Les secrets qu’elle contient, comme les clés privées des acteurs, sont chiffrés avec la KEK, donc ne conservez jamais la KEK au même endroit que les sauvegardes de la base de données : quiconque obtient les deux peut lire tous les secrets. - Rétention : une sauvegarde conserve des données que des utilisateurs ont supprimées ou que vous avez effacées sur demande. Supprimez les anciennes générations selon un calendrier que votre politique de confidentialité indique.
Sauvegarder
Section intitulée « Sauvegarder »Le serveur peut continuer de fonctionner pendant une sauvegarde. Pour en réaliser une qui corresponde exactement à un instant donné, par exemple avant une mise à niveau,
passez d’abord en mode maintenance : en mode maintenance, my serve n’ouvre aucune connexion à la base de données et n’écrit rien.
my db backup <file> écrit une copie cohérente de la base de données SQLite dans un nouveau fichier pendant que le serveur continue de fonctionner.
La copie contient toutes les écritures validées avant le démarrage de la commande, y compris celles qui sont encore dans le fichier -wal, et aucune après.
C’est un fichier unique, plus petit que l’original car les pages libres sont omises. La commande refuse un fichier qui existe déjà,
et ne fonctionne qu’avec database = sqlite.
my db backup /backup/my-$(date +%Y%m%d%H%M).dbAvec Docker Compose, exécutez-la dans le conteneur du serveur. La copie est écrite à l’intérieur du conteneur ; écrivez-la donc dans le volume de données et sortez-la de là :
cd deploy/dockerdocker compose exec -T my my db backup /data/backup.dbdocker run --rm -v my_data:/data -v "$PWD":/backup busybox sh -c 'mv /data/backup.db /backup/my-$(date +%Y%m%d%H%M).db'Ne copiez pas le fichier de la base de données avec cp ou tar pendant que le serveur fonctionne : le fichier seul ne contient pas les écritures encore présentes dans le fichier -wal,
et une copie réalisée au milieu d’une écriture peut être corrompue. Une copie simple convient lorsqu’aucun processus n’a la base de données ouverte
(serveur arrêté, ou en mode maintenance) ; copiez alors aussi les fichiers -wal et -shm.
PostgreSQL
Section intitulée « PostgreSQL »Utilisez pg_dump au format personnalisé, que pg_restore lit. Il lit un seul instantané, de sorte que le serveur peut continuer de fonctionner.
pg_dump --format=custom --file=my-$(date +%Y%m%d%H%M).dump "postgres://my:...@db.example/my"Avec la couche Compose compose.postgres.yaml, exécutez-le dans le conteneur de la base de données (nommez la couche avec -f ou dans COMPOSE_FILE) :
cd deploy/dockerdocker compose exec -T postgres pg_dump --format=custom -U my my > my-$(date +%Y%m%d%H%M).dumpUtilisez le pg_dump de la même version majeure que le serveur ou d’une version plus récente.
Un PostgreSQL géré dispose de ses propres sauvegardes, qui sont le meilleur choix pour une grande base de données :
- Cloud SQL et Amazon RDS réalisent des sauvegardes quotidiennes automatiques et, avec la restauration à un instant donné activée, restaurent à n’importe quelle seconde de la période de rétention. Activez les deux, réglez la rétention pour couvrir les générations souhaitées, et réalisez une sauvegarde à la demande (une sauvegarde à la demande de Cloud SQL, un instantané RDS) avant chaque mise à niveau.
- Leur restauration crée une nouvelle instance (ou en écrase une) : faites ensuite pointer
database_urlvers elle. - Ces sauvegardes restent dans le compte du fournisseur. Exportez de temps en temps un
pg_dumpvers un emplacement extérieur à celui-ci également, afin que la perte du compte n’entraîne pas celle des données.
Le magasin de blobs fs conserve chaque fichier sous blob_fs_dir (/data/blobs avec Compose) : les téléversements dans objects/, et les fichiers en cours d’écriture dans tmp/.
Copiez le répertoire, à l’exception de tmp/, avec n’importe quel outil qui copie des fichiers (tar, rsync, un instantané du volume ou du disque).
Un fichier est écrit sous tmp/ puis renommé dans objects/ en une seule étape ; une copie réalisée pendant que le serveur fonctionne ne contient donc jamais la moitié d’un fichier dans objects/.
docker run --rm -v my_data:/data -v "$PWD":/backup busybox \ tar czf /backup/blobs-$(date +%Y%m%d%H%M).tar.gz -C /data --exclude=blobs/tmp blobsrsync vers l’hôte de sauvegarde garde la copie petite après la première fois, puisque les fichiers médias ne changent jamais une fois écrits.
Médias dans un bucket
Section intitulée « Médias dans un bucket »Les magasins de blobs s3 et gcs conservent chaque fichier comme un objet du bucket blob_s3_bucket ou blob_gcs_bucket, nommé par sa clé : les médias traités sous media/, les téléversements tels que reçus sous uploads/, et les fichiers distants mis en cache sous remote/. Le bucket reste privé : le serveur lit les fichiers et les sert sous /media/. Un objet n’apparaît qu’une fois écrit en entier ; une copie réalisée pendant que le serveur fonctionne ne contient donc jamais un fichier à moitié écrit. Protégez le bucket en trois couches, de la moins coûteuse à la plus sûre.
Versionnement. Activez le versionnement des objets du bucket lorsque le service le propose (Amazon S3, Google Cloud Storage, MinIO, et d’autres). Un objet supprimé ou écrasé reste alors comme version non courante, et le bucket peut revenir au moment d’une sauvegarde de la base de données.
aws s3api put-bucket-versioning --bucket my-media --versioning-configuration Status=EnabledAvec les modules OpenTofu d’Amazon S3 et de Google Cloud Storage, définissez versioning = true : cela active le versionnement et ajoute la règle des versions non courantes ci-dessous, dont l’âge est noncurrent_version_days (35 par défaut). Cloudflare R2 n’a pas de versionnement des objets, et le module d’un autre magasin compatible S3 ne crée pas le bucket ; pour ces deux cas, utilisez une copie (ci-dessous).
Règles de cycle de vie. Avec le versionnement, chaque fichier supprimé conserve son coût de stockage jusqu’à ce qu’une règle le retire. Ajoutez une règle qui supprime les versions non courantes après l’âge de votre plus ancienne sauvegarde de la base de données (35 jours pour les générations de Fréquence et destination sans les mensuelles), afin que chaque sauvegarde de la base de données que vous conservez retrouve ses fichiers et qu’un fichier supprimé par un utilisateur ne reste pas plus longtemps que ne l’indique votre politique de confidentialité. Ajoutez une règle qui interrompt les téléversements multipartites incomplets après un jour : le serveur interrompt lui-même un téléversement échoué d’un gros fichier, mais un processus qui s’arrête au milieu de l’un d’eux laisse ses parties derrière lui.
{ "Rules": [ { "ID": "noncurrent-versions", "Status": "Enabled", "Filter": {}, "NoncurrentVersionExpiration": { "NoncurrentDays": 35 }, "AbortIncompleteMultipartUpload": { "DaysAfterInitiation": 1 } } ]}aws s3api put-bucket-lifecycle-configuration --bucket my-media --lifecycle-configuration file://lifecycle.jsonUne copie dans un autre compte ou une autre région. Le versionnement protège contre une erreur, pas contre la perte du bucket ou du compte qui le possède, et les identifiants du serveur peuvent supprimer des objets. Conservez une copie que ces identifiants ne peuvent pas atteindre :
-
Réplication. Amazon S3 réplique un bucket versionné vers un bucket d’une autre région ou d’un autre compte (Cross-Region ou Same-Region Replication, la destination appartenant à l’autre compte). Activez aussi le versionnement sur la destination, et ne répliquez pas les suppressions (laissez la réplication des marqueurs de suppression désactivée), afin qu’une suppression sur l’instance n’atteigne pas la copie. D’autres services ont leur propre réplication, comme les buckets bi-régionaux de Cloud Storage et la réplication de buckets de MinIO.
-
Une copie planifiée. Là où il n’y a pas de réplication, ou pour copier vers un autre fournisseur, copiez le bucket selon le calendrier de la sauvegarde de la base de données, juste après elle, avec des identifiants qui ne peuvent que lire le bucket de l’instance et que écrire dans le bucket de sauvegarde :
Fenêtre de terminal rclone copy --checksum source:my-media backup:my-media-backuprclone copyetaws s3 syncsans--deleteajoutent les nouveaux objets et n’en retirent jamais un de la copie. Les fichiers ne changent jamais une fois écrits ; après la première exécution, chaque copie ne transfère donc que les nouveaux. Supprimez les anciens objets de la copie selon le calendrier de votre politique de conservation, ou activez-y aussi le versionnement et une règle de cycle de vie.
Les identifiants restent hors de la copie : le bucket ne contient aucun secret, mais la configuration nomme la clé dans blob_s3_access_key_id et blob_s3_secret_access_key, qui vont avec la configuration. Le magasin de blobs gcs ne conserve aucune clé : il utilise le compte de service de la machine ou de Cloud Run.
L’ordre de la base de données et des médias
Section intitulée « L’ordre de la base de données et des médias »Sauvegardez la base de données d’abord, puis les médias, et conservez les deux ensemble comme une seule génération. Pour un bucket, la copie ou la réplication qui s’exécute après la sauvegarde de la base de données est la sauvegarde des médias ; avec la gestion des versions, ce sont les versions à l’instant de la sauvegarde de la base de données.
La base de données nomme les fichiers médias qu’elle utilise, et la copie des médias est réalisée un instant plus tard. Pendant cet instant :
- De nouveaux téléversements peuvent arriver dans la copie des médias sans ligne dans la copie de la base de données. Ce sont des fichiers que rien n’utilise ; ils prennent de la place sans faire de mal.
- Un fichier supprimé après la sauvegarde de la base de données (le média d’une publication supprimée, un téléversement qui n’a jamais été attaché) est dans la copie de la base de données mais pas dans la copie des médias.
Après une restauration, ce fichier répond
404, et la publication qui l’affichait montre une image manquante.
L’autre ordre est pire : chaque fichier téléversé entre la sauvegarde des médias et celle de la base de données manquerait après une restauration, y compris les médias des nouvelles publications. Réaliser les deux en mode maintenance évite l’un et l’autre écart.
Sur les cibles OpenTofu
Section intitulée « Sur les cibles OpenTofu »Les modules ne conservent aucune sauvegarde propre au-delà de ce que le fournisseur offre : le PostgreSQL géré de Cloud SQL et de RDS dispose de sauvegardes automatiques avec une durée de conservation que vous définissez, alors qu’une base de données avec seulement l’historique du fournisseur (Neon) ne peut remonter que jusqu’où va cet historique. Planifiez-les vous-même, avec des identifiants que l’instance ne détient pas :
- La base de données, chaque jour. Exécutez
pg_dumpsur le PostgreSQL de l’instance depuis une machine ou une tâche planifiée extérieure au fournisseur qui héberge la base de données (voir PostgreSQL), chiffrez l’export et écrivez-le dans un bucket d’un autre compte ou fournisseur. Conservez les générations de Fréquence et destination. La tâche n’a besoin que dedatabase_url; elle ne doit pas détenir la KEK. - Les médias, juste après. Avec
versioning = truesur le module du bucket, les versions sont la copie pour les derniersnoncurrent_version_days; pour la perte du compte, exécutez aussirclone copydu bucket de l’instance vers un bucket ailleurs, comme dans Médias dans un bucket, selon le calendrier de l’export de la base de données. - La KEK et la configuration ne font pas partie du calendrier : sauvegardez-les lorsqu’elles changent (La KEK et la configuration).
La KEK et la configuration
Section intitulée « La KEK et la configuration »La KEK n’est pas dans la base de données. Sauvegardez-la une fois, séparément des sauvegardes de la base de données, comme le décrit Gérer la clé de chiffrement de clés,
et à nouveau après chaque rotation. Conservez une copie de la configuration (l’environnement, le fichier de configuration, .env et les fichiers de secrets)
avec vos fichiers de déploiement, sans la KEK.
Restauration
Section intitulée « Restauration »Une sauvegarde contient le host et le account_domain de son instance. Démarrez la base de données restaurée avec les mêmes valeurs : avec d’autres, le serveur refuse de démarrer.
Restaurez dans un environnement vide (une nouvelle machine, de nouveaux volumes ou une nouvelle base de données), dans cet ordre : la base de données, les médias (le répertoire ou le bucket),
puis la configuration avec la même KEK (et le même kek_previous) que celle utilisée lors de la sauvegarde. Démarrez ensuite le serveur comme d’habitude.
Arrêtez le serveur, mettez le fichier de sauvegarde à la place du fichier de base de données, et supprimez les anciens fichiers -wal et -shm s’il en reste.
Avec Docker Compose, dans le volume my_data (un volume existant, ou un nouveau sur une autre machine) :
cd deploy/dockerdocker compose down # keeps the volume; on a new machine, `docker compose up --no-start` creates itdocker run --rm -v my_data:/data -v "$PWD":/backup busybox sh -c ' rm -rf /data/my.db /data/my.db-wal /data/my.db-shm /data/blobs && cp /backup/my-202601010000.db /data/my.db && tar xzf /backup/blobs-202601010000.tar.gz -C /data && chown -R 65532:65532 /data'docker compose up -dL’image du serveur s’exécute sous l’utilisateur 65532, qui doit posséder les fichiers du volume (le chown ci-dessus).
PostgreSQL
Section intitulée « PostgreSQL »Restaurez dans une nouvelle base de données vide, préparée comme pour une nouvelle instance, mais sans appliquer le schéma : le dump le contient.
-
Créez le rôle et la base de données.
-
Restaurez le dump. En superutilisateur, les tables restaurées conservent leur propriétaire (le rôle doit exister) ; en tant que propriétaire de la base de données, ajoutez
--no-owner.Fenêtre de terminal pg_restore --exit-on-error --dbname="postgres://postgres:...@db.example/my" my-202601010000.dump -
Avec la sauvegarde propre à une base de données gérée, restaurez-la plutôt à la manière du fournisseur, et faites pointer
database_urlvers l’instance restaurée.
Avec la couche Compose compose.postgres.yaml, démarrez uniquement la base de données, sur un nouveau volume, et restaurez dedans. Le conteneur a créé le rôle et la base de données :
cd deploy/dockerdocker compose up -d --wait postgresdocker compose exec -T postgres pg_restore --exit-on-error --no-owner -U my -d my < my-202601010000.dumpdocker compose up -dPour restaurer par-dessus une base de données existante (annuler une mise à niveau), utilisez pg_restore --clean --if-exists, comme le montre Revenir en arrière.
Extrayez la copie des médias dans blob_fs_dir avant le démarrage du serveur, avec pour propriétaire l’utilisateur sous lequel le serveur s’exécute.
Médias dans un bucket
Section intitulée « Médias dans un bucket »Restaurez les objets dans un bucket vide avant le démarrage du serveur, puis définissez blob_s3_bucket (ainsi que le point de terminaison, la région et les identifiants) ou blob_gcs_bucket sur celui-ci.
Les clés doivent rester les mêmes : la base de données nomme chaque fichier par sa clé.
-
À partir d’une copie dans un autre bucket, recopiez-la :
Fenêtre de terminal rclone copy --checksum backup:my-media-backup target:my-media-restored -
À partir des versions du bucket de l’instance elle-même, copiez les objets tels qu’ils étaient à l’instant de la sauvegarde de la base de données vers un nouveau bucket.
rclonelit les versions de cet instant avec--s3-version-at:Fenêtre de terminal rclone copy --s3-version-at "2026-01-01 00:00:00" source:my-media target:my-media-restored -
À partir d’un réplica, faites pointer
blob_s3_bucketoublob_gcs_bucketvers le réplica, ou recopiez-le vers un bucket du compte d’origine.
Les identifiants du serveur doivent pouvoir lire, écrire et supprimer des objets du bucket restauré (s3:GetObject, s3:PutObject, s3:DeleteObject
et s3:AbortMultipartUpload sur Amazon S3 ; le rôle roles/storage.objectUser sur le bucket dans Google Cloud Storage).
Démarrage et vérification
Section intitulée « Démarrage et vérification »Démarrez le serveur de la manière habituelle. Avec Docker Compose, docker compose up -d exécute d’abord my db upgrade -check, le schéma, puis my db upgrade ;
sur une sauvegarde de la même version, ils ne changent rien. Vérifiez ensuite :
/readyzrépond200, et le serveur n’enregistre aucune erreurunknown key-encryption key.my projection verifyne signale aucune différence (Vérifier et reconstruire les projections).- Vous pouvez vous connecter, et les dernières publications et leurs médias s’affichent.
- Les clés des acteurs n’ont pas changé : le
publicKey.publicKeyPemd’un acteur (curl -H 'Accept: application/activity+json' https://<host>/ap/actors/<id>) est le même qu’avant la restauration. Les autres serveurs vérifient les signatures de l’instance avec cette clé ; une clé inchangée signifie donc que la fédération reprend là où elle s’était arrêtée. - Une publication, un abonnement ou un désabonnement parvient à un autre serveur (un compte de test sur une autre instance le voit).
Les écritures réalisées après la sauvegarde sont perdues : les publications, abonnements et téléversements depuis lors n’existent plus sur cette instance, alors que d’autres serveurs peuvent encore avoir les activités qu’ils ont reçues. Cela ne peut pas être réparé d’ici ; restaurez à partir de la sauvegarde la plus récente dont vous disposez.
Avec un moteur de recherche, exécutez my search rebuild après la restauration, sans --keep, afin que les publications plus récentes que la sauvegarde quittent l’index (Recherche en texte intégral).
Sans la bonne KEK
Section intitulée « Sans la bonne KEK »- Pas de KEK : le serveur ne démarre pas.
my serveet les autres commandesmyqui lisent la configuration s’arrêtent avecThe required setting MY_KEK is not set.etkek: required when key_manager is local. - Une autre KEK : le serveur démarre et répond à
/readyz, mais tout ce qui lit un secret chiffré avec l’ancienne KEK échoue avecunknown key-encryption keyet l’ID de clé de l’ancienne KEK (local key manager: key "local:…" is not configured) : les envois vers d’autres serveurs et les récupérations signées (les clés privées des acteurs), les connexions avec authentification à deux facteurs, les signatures de webhooks et les fournisseurs de connexion externes. Les URL du proxy de médias émises auparavant cessent aussi de fonctionner. Les mots de passe et les publications ne sont pas chiffrés avec la KEK, de sorte que la connexion par mot de passe et la lecture des publications fonctionnent toujours, ce qui peut masquer le problème au début : surveillez le journal pour détecter l’erreur. - Trouvez la KEK dont l’ID de clé est nommé par l’erreur, définissez-la comme
kek(ou danskek_previous) et redémarrez. Il n’existe aucun moyen de récupérer un secret sans sa KEK ; si la KEK est définitivement perdue, les clés des acteurs doivent être régénérées, et les autres serveurs voient chaque acteur comme une nouvelle clé pour le même compte.
Exercice de restauration
Section intitulée « Exercice de restauration »On ne sait qu’une sauvegarde fonctionne qu’une fois qu’elle a été restaurée. Répétez une restauration avant que l’instance devienne publique, et de nouveau après un changement de la façon dont les sauvegardes sont réalisées (au moins tous les quelques mois) :
-
Réalisez une sauvegarde de l’instance en production comme ci-dessus : la base de données, puis les médias.
-
Sur une autre machine ou dans un autre projet Compose, restaurez-la avec la KEK et la configuration depuis l’endroit où vous les conservez (pas copiées depuis le serveur en production), et avec
hostinchangé pour que les URL des acteurs correspondent. -
Ne laissez pas la copie se fédérer. Définissez
role = web, qui n’exécute aucun worker de tâches : les tâches restaurées avec la base de données incluent des envois qui étaient dus au moment de la sauvegarde, et une copie qui les exécute les signe avec les clés des vrais acteurs et les renvoie à d’autres serveurs. Garder la copie hors d’Internet ne suffit pas, car c’est difficile à garantir. Activez le mode de maintenance une fois les vérifications ci-dessous réussies si vous la laissez en marche. -
En dehors de Compose, par exemple sur une machine locale face à une instance cloud, donnez à la copie ces réglages afin qu’elle ne touche à rien de l’instance en production :
Réglage Valeur dans la copie Pourquoi rolewebN’exécute aucune tâche ; rien de ce qui a été restauré n’est renvoyé queuedbLes tâches mises en file dans la copie restent dans sa base de données au lieu d’atteindre la file en production streampostgresNe rejoint pas le flux d’événements en production de l’instance mailnoneN’envoie aucun e-mail à de vrais utilisateurs le magasin de blobs un nouveau bucket (ou répertoire) contenant les médias restaurés Laisse intact le bucket en production database_urlla base de données restaurée Jamais celle en production la KEK ( MY_KEK, oukey_manageretkms_key)comme en production, depuis l’endroit où vous la conservez Sans elle, la copie ne démarre pas hostcomme en production Pour que les URL des acteurs correspondent -
Parcourez Démarrage et vérification : connexion, publications et médias, et la
publicKeyde quelques acteurs comparée à celle de l’instance en production. -
Démarrez-la une fois sans la KEK et une fois avec une autre, et vérifiez qu’elle échoue comme le décrit Sans la bonne KEK.
-
Notez la durée de chaque étape : c’est le temps pendant lequel une vraie restauration maintient l’instance à l’arrêt.
Pour les LLM et les agents de programmation :llms.txt,llms-full.txt, llms-small.txt