

このページは英語のページを機械翻訳したものです。内容は英語のページが正です。 英語のページを読む
メンテナンス
データベース、KV、キューの作業のためにサーバーを止める方法と、止めている間に何を表示するかを説明します。
手段は 2 つあります。
- メンテナンスモード(
maintenance = true、MY_MAINTENANCE=true、またはmy serve -maintenance)。my serveはアダプターを 1 つも開かずに起動し、 すべてのリクエストに503、Retry-After、各クライアントが理解できる応答を返します。my serve自体が動かせるときは、いつでもこれを使ってください。 - 書き出したページ(
my maintenance export)。同じテンプレートから作る静的な HTML で、my serveがまったく動かせないとき (イメージを入れ替えている途中、起動しないリビジョン)に、ロードバランサー、CDN、リバースプロキシが配信します。メンテナンスのページを書き出すを参照してください。
メンテナンスモードが返すもの
Section titled “メンテナンスモードが返すもの”プロセスが読むのは、待ち受けるアドレス、host、account_domain、web_origin、プロキシ(trusted_proxies、trusted_proxy_header)、
オリジンの確認(origin_secret、origin_secret_previous、origin_secret_header)、status_page_url、maintenance_* の設定だけです(設定リファレンス)。
データベース、キュー、blob ストア、KV、メール、ストリームの設定は読まれず確認もされないので、その間は誤っていても到達できなくてもかまいません。
role が何であっても HTTP だけを提供し、ジョブも定期ジョブもストリームブローカーも動かしません。tls の設定にかかわらず平文の HTTP で提供し、
listen か、その既定値の :8080 で待ち受けます(サーバー自身が HTTPS を配信する)。
my config check -maintenance は、メンテナンスモードが読むものだけをちょうど確認します。
origin_secret を設定しているときは、ヘッダーが必要なのにそれを持たないリクエストには、下の表ではなくその確認の 403 が返ります。
| リクエスト | ステータス | 本文 |
|---|---|---|
GET /healthz、GET /readyz、GET /health/live、GET /health/ready |
200 |
{"status":"maintenance"} |
GET /api/v1/instance/health |
503 |
{"status":"maintenance"} |
クライアント API(/api/*)の残りと、JSON を返す OAuth のエンドポイント |
503 |
型が /api/v1/problems/maintenance の application/problem+json。message、until、設定されていれば status_page_url を含みます |
ActivityPub(パス、Accept、Content-Type で判定)、WebFinger、host-meta、NodeInfo、決済の Webhook、Cloud Tasks と Cloud Scheduler からの呼び出し(/_internal/*) |
503 |
{"error":"maintenance"} |
| それ以外(ページ、Web クライアント、そのアセット、フォームの送信) | 503 |
メンテナンスのページ。Accept が JSON を求めるときは problem |
すべての応答に Retry-After と Cache-Control: no-store が付きます。Retry-After は、maintenance_until が先にある間はそこまでの秒数
(最大 86,400)で、それ以外のときは maintenance_retry_after(Go の duration、既定は 10m)です。
ページと problem には次のものが表示されます。
| 設定 | 表示 |
|---|---|
maintenance_server_name |
サーバーの名前。設定しないとホスト名になります(インスタンス自身の名前はデータベースにあるため) |
maintenance_message |
プレーンテキストのお知らせ。最大 2,000 文字で、どのロケールでも同じです |
maintenance_until |
作業が終わる見込みの日時(RFC 3339)。ページは UTC で、Web クライアントはユーザーのタイムゾーンで表示します |
status_page_url |
ステータスページへのリンク(監視) |
maintenance_* の設定は、通常の運用中も設定したままでかまいません。使われるのは maintenance が true の間だけです。
ページの文言は Accept-Language に従います(それ以外は英語です)。
Web クライアントは、API がメンテナンスの problem を返すと全画面のメンテナンスのお知らせを表示し、
ユーザーをサインインしたままにして、Retry-After のあとに再試行します。
メンテナンスは 数時間以内 に収めてください。ほかのサーバーは 503 を受けると配送を再試行しますが、どのサーバーも Retry-After を読みません。
再試行を使い切ると、その間に送られたアクティビティはこのサーバーには届かなくなります。
主要な実装のうち最も短い再試行の期間は約 1 日です(再試行のスケジュールから、Akkoma が約 1 日、Misskey が約 1.5 日、Mastodon が約 2~3 日、Pleroma が約 7 日)。
検索エンジンは短い 503 を一時的な停止として扱いますが、Google は robots.txt に 1~2 日を超えて 503 を返さないよう勧めています。
1~2 日より長い停止はメンテナンスではありません。代わりにサービスを閉鎖してください(サービスの閉鎖)。
- 告知する。 前もって、ステータスページ(
status_page_url)とお知らせ(「管理」→「お知らせ」)で作業の時間帯を告知します。 デプロイメントの設定にmaintenance_messageとmaintenance_untilを設定し、フロントエンドが書き出したページを配信するなら、 そのページを更新します(my maintenance export)。 - プッシュキュー(Cloud Tasks)を止める。 後述を参照してください。止めないと、作業の時間帯の配送がすべて
503になり、タスクの試行回数を 1 回ずつ使ってしまいます。 - メンテナンスモードに切り替える。
MY_MAINTENANCE=trueで再デプロイします(対象ごとの方法は下にあります)。すべてのレプリカがメンテナンスモードで再起動します。/readyzが200を返すので、ロードバランサーはレプリカを外しません。 - 作業をする。
- 元に戻す。
MY_MAINTENANCEなしで(またはfalseで)再デプロイし、/health/readyと/api/v1/instance/healthが{"status":"ok"}を返すことを確認してから、 プッシュキューを再開し、お知らせを終えます。
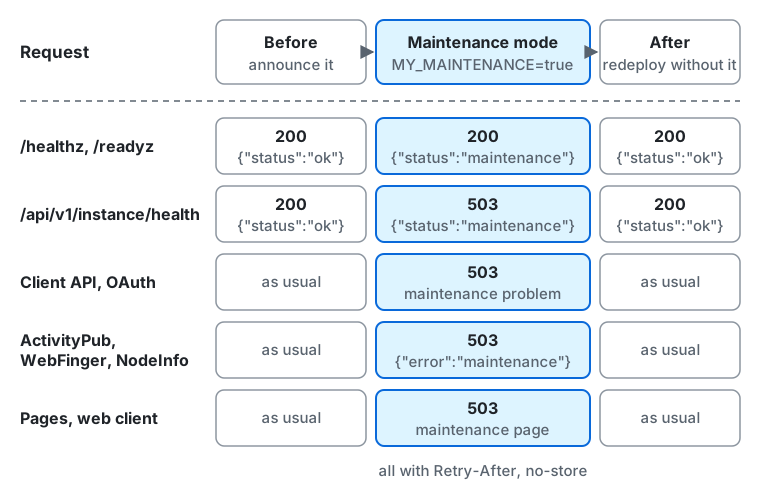
左から順に説明します。
- 前: メンテナンスを告知している間、すべてのリクエストに通常どおり応答します。
/healthz、/readyz、/api/v1/instance/healthは{"status":"ok"}で200を返します。 - メンテナンスモードの間(
MY_MAINTENANCE=true):/healthz、/readyz、/health/live、/health/readyは{"status":"maintenance"}で200を返します。/api/v1/instance/healthは{"status":"maintenance"}で503を返します。- クライアント API の残りと、JSON を返す OAuth のエンドポイントには、メンテナンスの problem で
503が返ります。 - ActivityPub、WebFinger、NodeInfo は
{"error":"maintenance"}で503を返します。 - ページと Web クライアントには、メンテナンスのページで
503が返ります。 - すべての応答に
Retry-AfterとCache-Control: no-storeが付きます。
- 後:
MY_MAINTENANCEなしで再デプロイすると、すべてのリクエストに再び通常どおり応答します。
プッシュキュー
Section titled “プッシュキュー”-
Cloud Tasks: キューを一時停止します。一時停止したキューは新しいタスクを受け付け続けますが、配信は止めます。作業のあとで再開してください。 タスクの試行回数は、キューの
retryConfig.maxAttemptsです。ターミナルウィンドウ gcloud tasks queues pause my-jobs --location=asia-northeast1gcloud tasks queues resume my-jobs --location=asia-northeast1/_internal/tickの Cloud Scheduler のジョブも一時停止するか(gcloud scheduler jobs pause/resume)、その間の呼び出しが503で失敗するのに任せてください。 ジョブそのものはデータベースにあります。試行回数を使い切ったタスクが失うのは合図だけで、作業のあとの最初の tick が、 期限の来たすべてのジョブにもう一度合図します。
対象ごとの方法
Section titled “対象ごとの方法”以下のフロントエンドのエラーページは、サーバーのエラーに書き出したページで応答します。一致させるのは、動いていないサーバーのエラー
(502 と 504、および正常なバックエンドがないときのロードバランサー自身の 503)だけにするか、my serve が動かせない間だけルールをオンにしてください。
すべての 503 に対するルールにすると、クライアント API や Web クライアントが読む problem のような、メンテナンスモード自身の応答まで置き換えてしまいます。
Cloud Run
Section titled “Cloud Run”変数を付けて新しいリビジョンをデプロイし、あとで外します。
gcloud run services update my --region=asia-northeast1 \ --update-env-vars=MY_MAINTENANCE=true,MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Zgcloud run services update my --region=asia-northeast1 --remove-env-vars=MY_MAINTENANCE,MY_MAINTENANCE_UNTILOpenTofu のモジュールを使う場合は、代わりにブロックで settings = { maintenance = "true" } として設定し、apply します。次の apply は
ブロックの内容に戻すためです。アップグレードの前後での扱いは、Cloud Run へのデプロイにあります。
ロードバランサーなしで Cloud Run を直接公開しているときは、その前に何もないので、使える手段はメンテナンスモードだけです。
グローバル外部アプリケーションロードバランサーの後ろで my serve が動かせないとき: 書き出した index.html を、バックエンドバケットとして追加した Cloud Storage のバケットにアップロードし、
バックエンドの 502 と 504 にそれと overrideResponseCode: 503 で応答するカスタムエラーレスポンスポリシーを追加します。
カスタムエラーレスポンスがあるのはグローバル外部アプリケーションロードバランサーだけで(リージョンやクラシックのものにはありません)、ポリシーが適用されるのは
バックエンドからの応答だけで、Google Front End が自分で作る応答には適用されません。この方法では Retry-After を送れません。エラーの送り元のカスタムヘッダーは追加されないためです。
# Part of the URL map (gcloud compute url-maps import).defaultCustomErrorResponsePolicy: errorService: https://www.googleapis.com/compute/v1/projects/<project>/global/backendBuckets/my-maintenance errorResponseRules: - matchResponseCodes: ["502", "504"] path: /index.html overrideResponseCode: 503AWS ECS
Section titled “AWS ECS”コンテナの環境に MY_MAINTENANCE=true を入れたサービスのタスク定義のリビジョンを登録し、サービスをそれに更新します。
作業のあとは、変数なしで同じことをします。OpenTofu のモジュールを使う場合は、代わりにブロックで settings = { maintenance = "true" } として設定し、
apply します。次の apply はブロックの内容に戻すためです。アップグレードの前後では、モードを apply し、次に新しいリリースを apply し、
最後にそれを外したブロックを apply します。Cloud Run へのデプロイと同じです。
CloudFront の後ろで my serve が動かせないとき: 書き出した index.html を、2 つ目のオリジンにした S3 のバケットにアップロードし
(エラーページを、失敗しているオリジンから出すことはできません)、502 と 504(503 は my serve が動かせない間だけ)に対するカスタムエラーレスポンスを、
ResponsePagePath: /maintenance/index.html と ResponseCode: 503 で追加します。
CloudFront は、カスタムヘッダーを持つレスポンスヘッダーポリシーで Retry-After を加えられますが、そのポリシーはキャッシュビヘイビアのすべての応答に適用されます。
メンテナンスの間だけ付けて、あとで外してください。
Application Load Balancer の固定レスポンスには、書き出したページを載せられません。本文は最大 1,024 文字で、Retry-After のようなヘッダーも設定できません。
短いテキストとステータスだけに使ってください。
{ "Type": "fixed-response", "FixedResponseConfig": { "StatusCode": "503", "ContentType": "text/plain", "MessageBody": "This server is under maintenance. Please try again later. / メンテナンス中です。しばらくしてからお試しください。" }}Retry-After がなければ、ほかのサーバーは自分のスケジュールで再試行しますが、上で述べた期間はそれをすでに見込んでいます。
Docker Compose
Section titled “Docker Compose”deploy/docker/compose.yaml は .env の設定をサーバーに渡し、MY_MAINTENANCE、MY_MAINTENANCE_MESSAGE、MY_MAINTENANCE_UNTIL はシェルからも受け取ります。
これらを設定して my サービスを作り直し、作業のあとで MY_MAINTENANCE を外してもう一度作り直します。
--no-deps を付けると、1 回だけ動くデータベースのサービス(upgrade-check、schema、upgrade)は動きません。これらはアップグレードのときに動かします(アップグレード)。
MY_MAINTENANCE=true MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Z docker compose up -d --no-deps --force-recreate mydocker compose up -d --no-deps --force-recreate mynginx の後ろで my serve が動かせないとき: 書き出したページをディレクトリーから配信し、Accept-Language で 1 つを選んで、
nginx 自身の 502 と 504(サーバーが止まっているか応答しない)に、それを 503 として返します。
proxy_intercept_errors はオフのままなので、メンテナンスモード自身の 503 はそのまま通ります。
map $http_accept_language $maintenance_page {    default  en.html;    ~*^ja    ja.html;}
server {    # ...    location / {        proxy_pass http://my:8080;        error_page 502 504 =503 /maintenance/$maintenance_page;    }    location /maintenance/ {        internal;        alias /srv/maintenance/;   # the -out directory of my maintenance export        add_header Retry-After 600 always;        add_header Cache-Control no-store always;    }}
microk8s (Kubernetes)
Section titled “microk8s (Kubernetes)”Deployment に変数を設定するとポッドがロールアウトされます。あとで変数を外します。
microk8s kubectl set env deployment/my MY_MAINTENANCE=true MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Zmicrok8s kubectl rollout status deployment/mymicrok8s kubectl set env deployment/my MY_MAINTENANCE- MY_MAINTENANCE_UNTIL-/readyz のレディネスプローブはメンテナンスモードでも通り続けるので、ロールアウトは完了し、Service はポッドへのルーティングを続けます。
NGINX Ingress Controller(microk8s の ingress アドオン)の後ろで my serve が動かせないとき: 書き出したページを小さな
nginx の Deployment から配信し(たとえば index.html、en.html、ja.html の ConfigMap から)、それをカスタムのデフォルトバックエンドにして、
コントローラーがサーバーの 502 と 504 にそこから応答するようにします(503 は my serve が動かせない間だけ加えます)。
metadata: annotations: nginx.ingress.kubernetes.io/custom-http-errors: "502,504" nginx.ingress.kubernetes.io/default-backend: my-maintenance # a Service in the same namespaceメンテナンス中の監視
Section titled “メンテナンス中の監視”/healthz、/readyz、/health/live、/health/readyは{"status":"maintenance"}で200のままです。ロードバランサーと Kubernetes はインスタンスを外しません。/api/v1/instance/healthは{"status":"maintenance"}で503を返します(監視)。 死活監視は、本文を照合するかメンテナンスの時間帯を設定していない限り、サーバーが停止していると判断します。死活監視を一時停止するか、時間帯を設定してください。
LLM とコーディングエージェント向け:llms.txt,llms-full.txt, llms-small.txt