

このページは英語のページを機械翻訳したものです。内容は英語のページが正です。 英語のページを読む
mycroblog サーバーの概要
サーバーを運用する前に最初に読むページです。mycroblog は ActivityPub でフェディバースのほかのサーバーと連合するマイクロブログで、my はそのサーバーソフトウェアです。これは 1 つのバイナリで、サーバー、ジョブワーカー、Web クライアント、そしてそれらを管理するコマンドを含みます。このページでは、サーバーが何でできているか、設定で何を選ぶか、小さなサーバーがどのように大きなサーバーへ育つか、次に何を読めばよいかを説明します。
サーバーの構成
Section titled “サーバーの構成”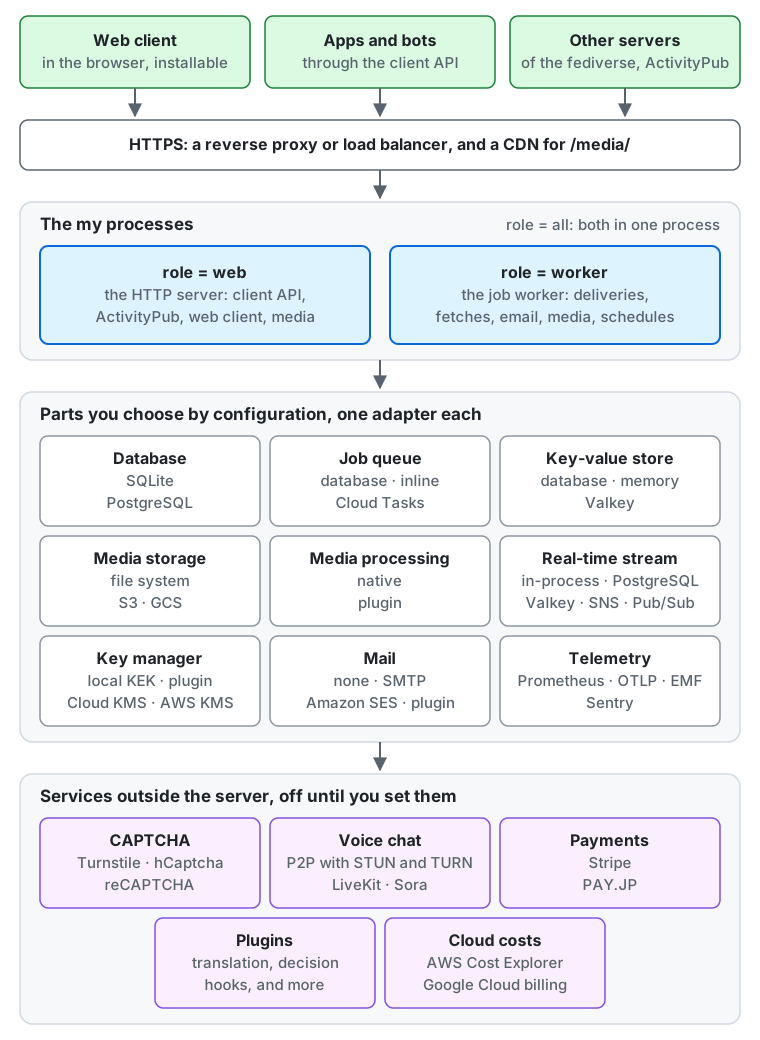
図の上から順に説明します。
- 接続してくるもの。 人はブラウザで Web クライアントを使い(アプリとしてインストールすることもできます)、アプリやボットはクライアント API を使い、フェディバースのほかのサーバーは ActivityPub で投稿を配送・取得します。いずれも HTTPS でサーバーにつながります。
- サーバーの前段。
myは既定では平文の HTTP を話すので、その前に置いたリバースプロキシやロードバランサーで HTTPS を終端します。1 台のマシンなら、代わりにmy自身が HTTPS を配信することもできます(サーバー自身による HTTPS の配信)。メディアファイルの前に CDN を置くこともできます(任意)。 myのプロセス。 各プロセスはmy serveを実行し、そのroleで何を動かすかが決まります。webは HTTP サーバー、workerはジョブワーカー(投稿の配送、ほかのサーバーからの取得、メールの送信、メディアの処理、定期ジョブの実行を行います)、既定値のallは 1 つのプロセスでその両方を動かします。- 選ぶ部品。 図の中央にある各部品には、そのアダプターを選ぶ設定が 1 つずつあります。次の節に一覧があります。
- サーバー外のサービス。 CAPTCHA、通話、支払い、プラグイン、クラウド費用の取り込みは、それぞれ設定するまで無効で、設定するとサーバーは指定したサービスを呼び出します。
設定で選ぶ部品
Section titled “設定で選ぶ部品”どの部品も設定リファレンスの設定項目で、TOML ファイルか環境変数(MY_ にキーを大文字にしたもの。例: MY_DATABASE)で設定します。各一覧の最初の選択肢が既定値です。データを保持する部品は、最初の起動の前に選んでください。設定を変えても、データが自動で移ることはありません。
| 部品 | 設定 | 選択肢 | 次に読むもの |
|---|---|---|---|
| データベース | database |
sqlite(ファイル)、postgres(PostgreSQL と互換サービス) |
データベース、バックアップ |
| ジョブキュー | queue |
db(データベースのテーブル)、inline(各ジョブを同じプロセスですぐに実行します。テストと開発用)、cloudtasks(ジョブごとに Google Cloud Tasks がサーバーを起こします。PostgreSQL が必要) |
ジョブキュー |
| キャッシュ、レート制限、再送された書き込みへの 1 日分の応答のためのキーバリューストア | kv |
db(データベースのテーブル)、memory(プロセスごとに独立)、valkey(Valkey またはほかの Redis プロトコルのサーバー。全プロセスで共有) |
kv |
| メディアの保存先 | blob |
fs(ディレクトリ)、s3(Amazon S3、Cloudflare R2、MinIO、Garage など S3 互換のストア)、gcs(Google Cloud Storage) |
Docker Compose のファイル、メディアのバックアップ |
| メディアの処理 | ファイルの種類ごとに 1 つずつ media_image、media_video、media_audio |
native(サーバー内)、plugin(あなたのプラグインがその種類のファイルを変換します) |
メディアの変換 |
| プロセス間のリアルタイムストリーム | stream |
hub(1 つのプロセス内)、postgres(LISTEN / NOTIFY)、valkey、sns(Amazon SNS と SQS)、pubsub(Google Cloud Pub/Sub) |
stream |
| アカウントの秘密鍵を暗号化する鍵管理 | key_manager |
local(あなたが保管する鍵暗号化鍵)、gcpkms(Google Cloud KMS)、awskms(AWS KMS)、plugin |
鍵の管理 |
| メール | mail |
none、smtp、ses(Amazon SES)、plugin |
メールの送信 |
| CAPTCHA | captcha |
none、turnstile(Cloudflare Turnstile)、hcaptcha、recaptcha(Google reCAPTCHA v2) |
CAPTCHA |
| 通話 | voice |
off、p2p(ブラウザ同士。TURN は voice_turn で none、coturn、cloudflare のいずれか)、livekit、sora |
通話 |
| サポーターの支払い | payments |
none、stripe、payjp(PAY.JP) |
サポーター、Stripe、PAY.JP |
| プラグイン | plugin_<kind>_address |
既定ではなし。種類ごとに 1 つのアドレス: translator、search、billing、mailer、media_image、media_video、media_audio、key_manager、および判定フックの inbound.status、local.status、inbound.follow、signup.check、media.check、inbound.actor、local.profile |
プラグイン、判定フック |
| 投稿の翻訳 | translator_<provider>_*、plugin_translator_address |
なし(ブラウザ自身の翻訳だけ)、libretranslate、deepl、google(Google Cloud Translation)、aws(Amazon Translate)、または選んだサービスの前に置くあなたのプラグイン |
投稿の翻訳、翻訳プラグイン |
| 投稿の全文検索 | search |
none、または elasticsearch、opensearch、meilisearch(検索エンジン)、またはほかのエンジンの前に置くあなたのプラグインである plugin |
全文検索、検索プラグイン |
| メディアの CDN | media_origin |
未設定(サーバーが自身のオリジンからメディアを配信します)、または CDN のオリジン | CDN からメディアを配信する |
| クラウド費用 | billing_sources |
なし、または aws(AWS Cost Explorer)、gcp(Google Cloud の請求データのエクスポートまたは予算)、cloudflare(Cloudflare の従量課金)、plugin のいずれか |
クラウド費用の取り込み |
| メトリクス | metrics_exporter |
none、prometheus、otlp(OpenTelemetry)、emf(CloudWatch) |
メトリクス、アラート |
| トレース | traces_exporter |
none、otlp |
トレース |
| エラーレポート | errors_exporter |
none(ログ行とエラーグループだけ)、sentry(Sentry、GlitchTip、Datadog)、otlp |
エラーレポート |
リリースされたバイナリとコンテナイメージには、表のアダプターがすべて含まれています。
my config check は、サーバーを起動する前に、設定の問題をまとめてすべて報告します(本番運用のチェックリスト)。
小さなサーバーから大きなサーバーへ
Section titled “小さなサーバーから大きなサーバーへ”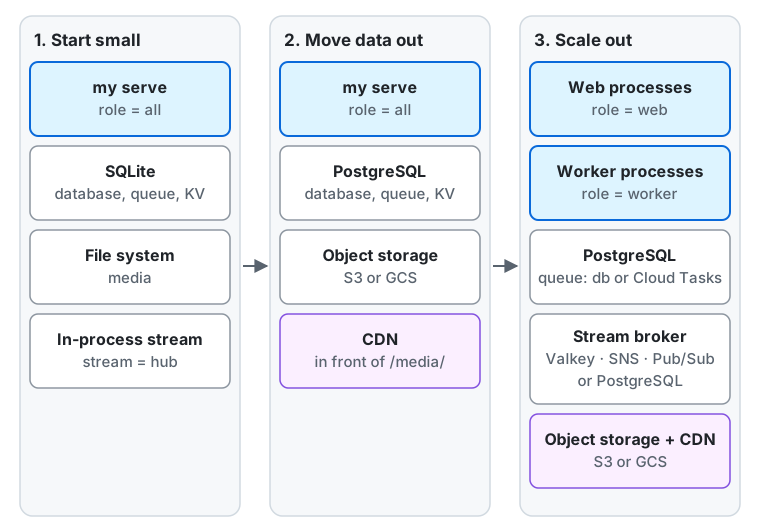
- 小さく始める。
role = allの 1 つのプロセスで、SQLite を使い、メディアはファイルシステムに置き、そのほかは既定値のままにします。キューとキーバリューストアはデータベースに、リアルタイムストリームはプロセス内に置かれます。deploy/dockerの Docker Compose のファイルで、この構成を 1 台のマシンで起動できます(Docker Compose でのデプロイ)。個人や小規模のサーバーに向いています。stream = hubは自分が動いているプロセスにしか届かないので、この構成は 1 つのプロセスのままです。 - データを外に出す。 データベースに PostgreSQL、メディアに S3 互換のバケットか Google Cloud Storage を使い、メディアの前に CDN を置きます。サーバーはまだ 1 つのプロセスですが、1 つのディスクには依存しなくなり、次の段階のプロセス同士でデータを共有できます。できれば最初の起動の前に決めてください。あとから SQLite とファイルシステムからデータを移すのは、それだけで 1 つの作業になります(移すべきものはバックアップする対象に一覧があります)。
- スケールアウトする。 リクエスト用に
role = web、ジョブ用にrole = workerのプロセスを、それぞれ必要な数だけ動かし、ワーカーをジョブの種類ごとに分けます(ワーカーの分割)。プロセスが複数あるときは、リアルタイムストリームにすべてのプロセスに届くブローカー(postgres、valkey、sns、pubsub)が必要です。また、memoryではレート制限と再送された書き込みへの応答がプロセスごとに別々になるので、キーバリューストアは共有するもの(dbかvalkey)にしてください。ジョブキューは PostgreSQL のままにするか、Google Cloud Tasks に移します(Cloud Tasks)。
Cloud Run へのデプロイは、2 番目と 3 番目の段階の間にある構成の例です。Cloud Run の上の role = all、Neon の PostgreSQL、Cloud Storage のメディア、ジョブには Cloud Tasks、ストリームには Pub/Sub を使い、誰もサーバーを使っていない間はインスタンスが 1 つも動きません。
次に読むもの
Section titled “次に読むもの”運用者向けのガイドは次の順に読んでください。
- 始める: サーバーを動かすかCloud Run にデプロイし、利用者に公開する前に本番運用のチェックリストを確認します。
- インスタンスを設定する: 設定、登録、外部のログインプロバイダー、メール、CAPTCHA、CDN、リンクプレビュー、検索エンジンと AI クローラー。
- 機能を有効にする: モデレーション、リレー、Webhook、プラグインと判定フック、通話、全文検索、サポーターとその支払い、クラウド費用の取り込み。
- 日々運用する: 監視、アラート、エラーレポート、メンテナンス、バックアップ、データベース、鍵暗号化鍵、管理者とロール。
- 法務とサービスの終了: プライバシーポリシーと処理活動の記録のテンプレート、サービスの終了。
LLM とコーディングエージェント向け:llms.txt,llms-full.txt, llms-small.txt