

このページは英語のページを機械翻訳したものです。内容は英語のページが正です。 英語のページを読む
バックアップと復元
何をバックアップするか、インスタンスを動かしたまま各バックアップを取る方法、それらからインスタンスを復元する方法、そして必要になる前に復元を練習する方法を説明します。アップグレードでもバックアップを取ります。その前後の手順は アップグレード で説明しています。
何をバックアップするか
Section titled “何をバックアップするか”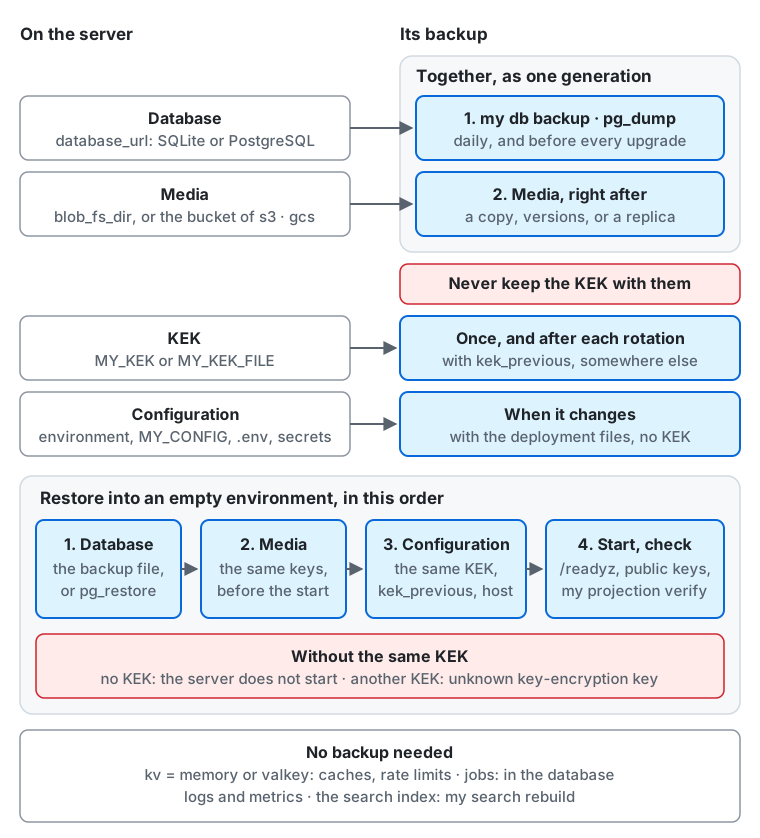
図の上から順に説明します。
- データベース(
database_url: SQLite または PostgreSQL)は、my db backupまたはpg_dumpで、毎日とアップグレードの前ごとに、最初にバックアップします。 - メディア(
blob_fs_dir、またはs3かgcsの blob ストアのバケット)は、その直後に、コピー、バケットのバージョン、レプリカのいずれかとしてバックアップします。 2 つのバックアップは 1 つの世代として一緒に、サーバーから離れた場所に、暗号化して保管します。 - KEK(
MY_KEKまたはMY_KEK_FILE)は、一度と、ローテーションのたびにkek_previousと一緒にバックアップします。データベースのバックアップと同じ場所には決して置きません。key_manager = gcpkmsまたはawskmsの場合、KEK は KMS の中にとどまります。kms_keyの鍵は、それを必要とするバックアップを保管している間は有効にしておいてください (AWS KMS の鍵を廃止する)。 - 設定(環境、
MY_CONFIG、.env、シークレット)は、変わったときにデプロイ用のファイルと一緒に、KEK を除いてコピーします。 - 復元 は空の環境に、次の順序で行います。データベース、次にサーバーを起動する前に同じキーでメディア、
そして同じ KEK、
kek_previous、hostを含む設定です。そのあとサーバーを起動し、/readyz、my projection verify、アクターの公開鍵を確認します (復元する)。KEK がなければサーバーは起動せず、別の KEK ではシークレットの読み取りがunknown key-encryption keyで失敗します (正しい KEK がないとき)。 - バックアップが要らないもの は、
kv = memoryまたはvalkeyの場合のキーバリューストア(キャッシュとレート制限)、ジョブ(データベースにあります)、 ログとメトリクス、そしてmy search rebuildで作り直せる検索エンジンのインデックスです。
| 対象 | 置き場所 | バックアップ | バックアップがないと失うもの |
|---|---|---|---|
| データベース | SQLite のファイル(database_url)または PostgreSQL のデータベース |
SQLite または PostgreSQL | すべて: アカウント、投稿、フォロー、設定 |
| メディア | fs の blob ストアのディレクトリ blob_fs_dir、または s3 の blob ストアのバケット blob_s3_bucket か gcs の blob ストアのバケット blob_gcs_bucket |
メディア または バケットのメディア | アップロードされた画像、動画、音声のファイルと、キャッシュしたリモートのファイル |
| KEK | MY_KEK または MY_KEK_FILE のファイルを保管している場所(Compose では secrets/kek。データベースには決して置きません) |
データベースとは別に KEK | すべてのアクターの秘密鍵とともにフェディバースでのアクターの同一性、そしてデータベースが保存するほかのシークレット |
| 設定 | 環境変数、設定ファイル(MY_CONFIG)、シークレット(MY_VAPID_PRIVATE_KEY、メールと決済のキー)、Compose では .env |
デプロイ用のファイルと一緒にコピーします | データは何も失いませんが、インスタンスを同じように起動できません。host を変えると、連合のすべての URL が壊れます |
バックアップが要らないものは次のとおりです。
- キーバリューストア(
kv)。kv = dbの場合はデータベースの一部です。kv = memoryまたはkv = valkeyの場合は、キャッシュ、レート制限のカウンター、 そして 2 段階目の認証を待っているサインインのような短期間の状態を保持します。Valkey が空の状態で復元すると、キャッシュは再び満たされ、 レート制限は最初からになり、進行中のサインインや音声通話はやり直しになります。 - ジョブキュー(
queue)。queue = dbとqueue = cloudtasksの場合、ジョブはデータベースの一部で、データベースと一緒に戻ります。 Cloud Tasks のタスクは、データベースのジョブへの合図を運ぶだけです。復元のあと、サーバーは数分のうちに、期限が来たジョブに改めて合図を送ります。 - ログとメトリクス。サーバーはこれらを読み戻しません。
- 検索エンジンのインデックス(使っている場合)。
my search rebuildがデータベースから作り直します。エンジンのスナップショットを取る場合、スナップショットには、スナップショットのあとに削除された投稿も含めて投稿のテキストが入るので、データベースのバックアップと同じように扱ってください(全文検索)。
Web Push の VAPID キーは設定のシークレットです。新しいキーにすると、既存のすべての購読へのプッシュ通知が止まります (Web Push の VAPID キー)。そのため、設定と一緒に保管してください。
頻度と保管場所
Section titled “頻度と保管場所”- データベース: 少なくとも 1 日に 1 回と、アップグレードの前ごと。遅れて気づいた誤りでも元に戻せるように、たとえば日次 7 つ、週次 4 つ、月次 3 つのように、複数の世代を残してください。 ポイントインタイムリカバリーのあるマネージド PostgreSQL では、その保持期間の日数分がカバーされます。
- メディア: 毎回データベースと一緒に(データベースとメディアの順序 を参照)。
- KEK と設定: 変わったとき。KEK のローテーションも変更です。新しい KEK を使う前にバックアップし、以前の KEK は
kek_previousに載っている間は残してください。 - 保管場所: サーバーとそのディスクから離れた、別の障害ドメイン(別のマシン、別のリージョン、別の事業者やアカウント)。 サーバー自身のディスクにあるバックアップは、そのディスクを失うと一緒に失われます。
- 暗号化: データベースのバックアップには、メールアドレス、パスワードのハッシュ、ダイレクトメッセージが入っています。保存時に暗号化してください
(暗号化したバケットを使うか、アップロードの前に
ageやgpgでファイルを暗号化します)。中にあるアクターの秘密鍵などのシークレットは KEK で暗号化されているので、KEK をデータベースのバックアップと同じ場所には決して置かないでください。両方を手に入れた人はすべてのシークレットを読めます。 - 保存期間: バックアップには、利用者が削除したデータや、求めに応じて消去したデータが残ります。プライバシーポリシーに書いた予定に従って、古い世代を削除してください。
バックアップを取る
Section titled “バックアップを取る”バックアップの間もサーバーは動かしたままにできます。アップグレードの前など、ある時点にぴったり一致するバックアップを取るには、
先に メンテナンスモード に切り替えてください。メンテナンスモードでは、my serve はデータベースへの接続を開かず、何も書き込みません。
SQLite
Section titled “SQLite”my db backup <file> は、サーバーを動かしたまま、SQLite のデータベースの一貫したコピーを新しいファイルに書き出します。
コピーには、コマンドの開始前にコミットされたすべての書き込みが、まだ -wal ファイルにあるものも含めて入り、開始後のものは入りません。
コピーは 1 つのファイルで、空きページを除くので元より小さくなります。コマンドは既存のファイルを拒否し、
database = sqlite の場合にだけ動きます。
my db backup /backup/my-$(date +%Y%m%d%H%M).dbDocker Compose では、サーバーのコンテナの中で実行します。コピーはコンテナの中に書き出されるので、データボリュームに書き出し、 そこから外へ移してください。
cd deploy/dockerdocker compose exec -T my my db backup /data/backup.dbdocker run --rm -v my_data:/data -v "$PWD":/backup busybox sh -c 'mv /data/backup.db /backup/my-$(date +%Y%m%d%H%M).db'サーバーが動いている間に、データベースのファイルを cp や tar でコピーしないでください。ファイルだけでは、まだ -wal ファイルにある書き込みが抜け落ちます。
また、書き込みの途中で取ったコピーは壊れていることがあります。どのプロセスもデータベースを開いていないとき(サーバーを止めているときや、
メンテナンスモードのとき)は、普通のコピーでかまいません。その場合は -wal と -shm のファイルも一緒にコピーしてください。
PostgreSQL
Section titled “PostgreSQL”pg_restore が読めるカスタム形式で pg_dump を使います。1 つのスナップショットを読むので、サーバーは動かしたままにできます。
pg_dump --format=custom --file=my-$(date +%Y%m%d%H%M).dump "postgres://my:...@db.example/my"Compose のレイヤー compose.postgres.yaml を使っている場合は、データベースのコンテナの中で実行します(レイヤーは -f か COMPOSE_FILE で指定します)。
cd deploy/dockerdocker compose exec -T postgres pg_dump --format=custom -U my my > my-$(date +%Y%m%d%H%M).dumpサーバーと同じかそれより新しいメジャーバージョンの pg_dump を使ってください。
マネージド PostgreSQL には独自のバックアップがあり、大きなデータベースではそちらのほうが適しています。
- Cloud SQL と Amazon RDS は日次の自動バックアップを取り、ポイントインタイムリカバリーを有効にすると、保持期間内の任意の秒に復元できます。 両方を有効にし、残したい世代をカバーする保持期間を設定し、アップグレードの前ごとにオンデマンドのバックアップ (Cloud SQL のオンデマンドバックアップ、RDS のスナップショット)を取ってください。
- これらの復元は新しいインスタンスを作ります(または既存のものを上書きします)。そのあとで
database_urlをそのインスタンスに向けてください。 - これらのバックアップは事業者のアカウントの中にとどまります。アカウントを失ってもデータを失わないように、ときどき
pg_dumpをアカウントの外にもエクスポートしてください。
fs の blob ストアは、すべてのファイルを blob_fs_dir(Compose では /data/blobs)の下に置きます。アップロードされたものは objects/ に、書き込み中のファイルは tmp/ にあります。
ファイルをコピーできる任意のツール(tar、rsync、ボリュームやディスクのスナップショット)で、tmp/ を除いてディレクトリをコピーしてください。
ファイルは tmp/ の下に書き込まれ、一度の操作で objects/ に名前を変えて移されるので、サーバーの動作中に取ったコピーでも、objects/ に書きかけのファイルが入ることはありません。
docker run --rm -v my_data:/data -v "$PWD":/backup busybox \ tar czf /backup/blobs-$(date +%Y%m%d%H%M).tar.gz -C /data --exclude=blobs/tmp blobsメディアのファイルは一度書き込まれたら変わらないので、バックアップ先のホストへの rsync では、2 回目以降のコピーは小さく済みます。
バケットのメディア
Section titled “バケットのメディア”s3 と gcs の blob ストアは、すべてのファイルをバケット blob_s3_bucket または blob_gcs_bucket のオブジェクトとして、キーを名前にして保管します。処理済みのメディアは media/ の下に、
受け取ったままのアップロードは uploads/ の下に、キャッシュしたリモートのファイルは remote/ の下にあります。バケットは非公開のままです。サーバーが
ファイルを読み、/media/ の下で配信します。オブジェクトは全体が書き込まれて初めて現れるので、サーバーの動作中に取ったコピーでも、
書きかけのファイルが入ることはありません。バケットは、費用の安いものから安全なものへ、3 つの層で守ってください。
バージョニング。 サービスが提供している場合(Amazon S3、Google Cloud Storage、MinIO など)は、バケットのオブジェクトのバージョニングを有効にしてください。 削除や上書きをされたオブジェクトは最新でないバージョンとして残り、バケットをデータベースのバックアップの時点に戻せます。
aws s3api put-bucket-versioning --bucket my-media --versioning-configuration Status=EnabledAmazon S3 と Google Cloud Storage の OpenTofu モジュールでは versioning = true を設定します。これでバージョニングが有効になり、下の最新でないバージョン用のルールが加わります。そのルールの経過日数は noncurrent_version_days(既定値 35)です。Cloudflare R2 にはオブジェクトのバージョニングがなく、ほかの S3 互換ストア用のモジュールはバケットを作らないので、この 2 つではコピー(下記)を使ってください。
ライフサイクルルール。 バージョニングを使うと、削除したファイルはどれも、ルールで取り除かれるまで保存料金がかかり続けます。最新でないバージョンを、 いちばん古いデータベースのバックアップの経過日数(頻度と保管場所 の世代から月次を除くと 35 日)のあとに削除するルールを加えてください。 そうすれば、保管しているどのデータベースのバックアップでもそのファイルが見つかり、利用者が削除したファイルがプライバシーポリシーに書いた期間より長く残ることもありません。 未完了のマルチパートアップロードを 1 日後に中止するルールも加えてください。大きなファイルのアップロードに失敗したときはサーバーが自分で中止しますが、 その途中で止まったプロセスはパートを残していきます。
{ "Rules": [ { "ID": "noncurrent-versions", "Status": "Enabled", "Filter": {}, "NoncurrentVersionExpiration": { "NoncurrentDays": 35 }, "AbortIncompleteMultipartUpload": { "DaysAfterInitiation": 1 } } ]}aws s3api put-bucket-lifecycle-configuration --bucket my-media --lifecycle-configuration file://lifecycle.json別のアカウントやリージョンのコピー。 バージョニングは誤操作から守りますが、バケットやそれを所有するアカウントを失うことからは守りません。 また、サーバー自身の認証情報でオブジェクトを削除できます。その認証情報が届かないコピーを残してください。
-
レプリケーション。 Amazon S3 は、バージョニングを有効にしたバケットを、別のリージョンや別のアカウントのバケットに複製します(Cross-Region Replication または Same-Region Replication で、 複製先は別のアカウントが所有します)。複製先でもバージョニングを有効にし、削除は複製しないでください (削除マーカーのレプリケーションは無効のままにします)。そうすれば、インスタンスでの削除がコピーに届きません。 ほかのサービスにも、Cloud Storage のデュアルリージョンバケットや MinIO のバケットレプリケーションのように、独自のレプリケーションがあります。
-
定期的なコピー。 レプリケーションがない場合や、別の事業者にコピーする場合は、データベースのバックアップの予定に合わせ、その直後にバケットをコピーしてください。 認証情報は、インスタンスのバケットを読むことと、バックアップ用のバケットに書くことしかできないものを使います。
ターミナルウィンドウ rclone copy --checksum source:my-media backup:my-media-backup--deleteを付けないrclone copyとaws s3 syncは、新しいオブジェクトを加えるだけで、コピーからオブジェクトを取り除くことはありません。ファイルは一度書き込まれたら変わらないので、 初回のあとは、各コピーで転送されるのは新しいものだけです。保存期間の方針の予定に従ってコピーから古いオブジェクトを削除するか、 そちらでもバージョニングとライフサイクルルールを有効にしてください。
認証情報はコピーに含めません。バケットにはシークレットはありませんが、設定は blob_s3_access_key_id と blob_s3_secret_access_key でキーを指定しており、
これらは設定と一緒に扱うものです。gcs の blob ストアはキーを持たず、マシンまたは Cloud Run のサービスアカウントを使います。
データベースとメディアの順序
Section titled “データベースとメディアの順序”データベースを先に、メディアをあとに バックアップし、2 つを 1 つの世代として一緒に保管してください。バケットの場合は、データベースのバックアップのあとに行うコピーやレプリケーションがメディアのバックアップです。 バージョニングを使う場合は、データベースのバックアップの時点のバージョンがそれにあたります。
データベースは使っているメディアのファイルを名前で指し、メディアのコピーはその少しあとに取られます。その間に、次のことが起こりえます。
- 新しいアップロードが、データベースのコピーに行がないまま、メディアのコピーに入ることがあります。どこからも使われないファイルで、場所を取りますが害はありません。
- データベースのバックアップのあとに削除されたファイル(削除された投稿のメディア、添付されなかったアップロード)は、データベースのコピーにはあってもメディアのコピーにはありません。
復元のあと、そのファイルは
404を返し、それを表示していた投稿では画像が欠けて表示されます。
逆の順序はもっと悪くなります。メディアのバックアップとデータベースのバックアップの間にアップロードされたすべてのファイルが、新しい投稿のメディアも含めて、 復元のあとに欠けてしまいます。両方をメンテナンスモードで取れば、どちらの隙間も避けられます。
OpenTofu のターゲットの場合
Section titled “OpenTofu のターゲットの場合”モジュールは、プロバイダーが提供するもの以上のバックアップを自分では持ちません。Cloud SQL と RDS のマネージド PostgreSQL には、保持期間を設定できる自動バックアップがあります。一方、プロバイダーの履歴しかないデータベース(Neon)は、その履歴が届く範囲までしか戻せません。 次のものは、インスタンスが持たない認証情報を使って、自分でスケジュールしてください。
- データベース(毎日)。 データベースをホストしているプロバイダーの外にあるマシンまたは定期ジョブから、インスタンスの PostgreSQL に対して
pg_dumpを実行し(PostgreSQL を参照)、ダンプを暗号化して、別のアカウントまたは別のプロバイダーのバケットに書き込みます。 頻度と保管場所 の世代を保管してください。このジョブに必要なのはdatabase_urlだけで、KEK を持たせてはいけません。 - メディア(その直後)。 バケットモジュールで
versioning = trueにしていれば、直近のnoncurrent_version_daysの間はバージョンがコピーになります。 アカウントを失う場合に備えて、バケットのメディア のように、データベースのダンプの予定に合わせて、インスタンスのバケットから別の場所のバケットへrclone copyも実行してください。 - KEK と設定 はスケジュールの対象ではありません。変更したときにバックアップしてください(KEK と設定)。
KEK と設定
Section titled “KEK と設定”KEK はデータベースの中にはありません。鍵暗号化キーの管理 で説明しているとおり、データベースのバックアップとは別に一度バックアップし、
ローテーションのたびにまたバックアップしてください。設定(環境、設定ファイル、.env、シークレットのファイル)のコピーは、
KEK を除いて、デプロイ用のファイルと一緒に保管してください。
バックアップには、そのインスタンスの host と account_domain が入っています。復元したデータベースは同じ値で起動してください。ほかの値では、サーバーは起動を拒否します。
空の環境(新しいマシン、新しいボリューム、新しいデータベース)に、次の順序で復元します。データベース、メディア(ディレクトリまたはバケット)、
そしてバックアップを取ったときに使っていた 同じ KEK(と同じ kek_previous)を含む設定です。そのあと、いつもどおりサーバーを起動します。
SQLite
Section titled “SQLite”サーバーを止め、データベースのファイルの代わりにバックアップのファイルを置き、古い -wal と -shm のファイルが残っていれば取り除きます。
Docker Compose では、ボリューム my_data(既存のもの、または別のマシンの新しいもの)に入れます。
cd deploy/dockerdocker compose down # keeps the volume; on a new machine, `docker compose up --no-start` creates itdocker run --rm -v my_data:/data -v "$PWD":/backup busybox sh -c ' rm -rf /data/my.db /data/my.db-wal /data/my.db-shm /data/blobs && cp /backup/my-202601010000.db /data/my.db && tar xzf /backup/blobs-202601010000.tar.gz -C /data && chown -R 65532:65532 /data'docker compose up -dサーバーのイメージはユーザー 65532 として動くので、ボリュームのファイルはこのユーザーが所有している必要があります(上の chown)。
PostgreSQL
Section titled “PostgreSQL”新しいインスタンスと同じように用意した、新しい空のデータベースに復元します。ただし、スキーマは適用しません。ダンプに含まれているからです。
-
ロールとデータベースを作ります。
-
ダンプを復元します。スーパーユーザーとして復元すると、復元したテーブルは所有者を保ちます(そのロールが存在している必要があります)。データベースの所有者として復元する場合は、
--no-ownerを加えます。ターミナルウィンドウ pg_restore --exit-on-error --dbname="postgres://postgres:...@db.example/my" my-202601010000.dump -
マネージドデータベース独自のバックアップを使う場合は、代わりに事業者の方法で復元し、
database_urlを復元したインスタンスに向けます。
Compose のレイヤー compose.postgres.yaml を使っている場合は、新しいボリュームでデータベースだけを起動し、そこに復元します。ロールとデータベースはコンテナが作っています。
cd deploy/dockerdocker compose up -d --wait postgresdocker compose exec -T postgres pg_restore --exit-on-error --no-owner -U my -d my < my-202601010000.dumpdocker compose up -d代わりに既存のデータベースの上に復元する(アップグレードを取り消す)場合は、ロールバック にあるとおり pg_restore --clean --if-exists を使います。
サーバーを起動する前に、メディアのコピーを blob_fs_dir に展開し、サーバーを動かすユーザーの所有にしてください。
バケットのメディア
Section titled “バケットのメディア”サーバーを起動する前に、オブジェクトを空のバケットに復元し、blob_s3_bucket(とエンドポイント、リージョン、認証情報)または blob_gcs_bucket をそのバケットにします。
キーは同じでなければなりません。データベースは各ファイルをキーで指しているからです。
-
別のバケットのコピーからは、コピーし戻します。
ターミナルウィンドウ rclone copy --checksum backup:my-media-backup target:my-media-restored -
インスタンス自身のバケットのバージョンからは、データベースのバックアップの時点のオブジェクトを新しいバケットにコピーします。
rcloneは--s3-version-atでその時点のバージョンを読みます。ターミナルウィンドウ rclone copy --s3-version-at "2026-01-01 00:00:00" source:my-media target:my-media-restored -
レプリカからは、
blob_s3_bucketまたはblob_gcs_bucketをレプリカに向けるか、元のアカウントのバケットにコピーし戻します。
サーバーの認証情報には、復元したバケットのオブジェクトの読み取り、書き込み、削除の権限が必要です(Amazon S3 では s3:GetObject、s3:PutObject、s3:DeleteObject、
s3:AbortMultipartUpload、Google Cloud Storage ではバケットに対するロール roles/storage.objectUser)。
いつもどおりサーバーを起動します。Docker Compose では、docker compose up -d がまず my db upgrade -check、スキーマ、my db upgrade を実行します。
同じリリースのバックアップでは、これらは何も変えません。そのあと、次のことを確認します。
/readyzが200を返し、サーバーのログにunknown key-encryption keyのエラーが出ていない。my projection verifyが差分を報告しない(プロジェクションを確認して作り直す)。- サインインでき、最新の投稿とそのメディアが表示される。
- アクターの鍵が変わっていない: アクターの
publicKey.publicKeyPem(curl -H 'Accept: application/activity+json' https://<host>/ap/actors/<id>)が復元の前と同じである。 ほかのサーバーはこの鍵でインスタンスの署名を検証するので、鍵が変わっていなければ、連合は止まったところから続きます。 - 投稿、フォロー、フォロー解除がほかのサーバーに届く(ほかのインスタンスのテスト用アカウントで確認できる)。
バックアップのあとの書き込みは失われます。それ以降の投稿、フォロー、アップロードはこのインスタンスからはなくなりますが、ほかのサーバーには 受け取ったアクティビティが残っていることがあります。これはこちらからは直せません。手元でいちばん新しいバックアップから復元してください。
検索エンジンを使っている場合は、バックアップより新しい投稿がインデックスから消えるように、復元のあとに --keep を付けずに my search rebuild を実行してください(全文検索)。
正しい KEK がないとき
Section titled “正しい KEK がないとき”- KEK がない: サーバーは起動しません。
my serveと、設定を読むほかのmyのコマンドは、The required setting MY_KEK is not set.とkek: required when key_manager is localを出してそこで止まります。 - 別の KEK: サーバーは起動して
/readyzに応答しますが、古い KEK で暗号化したシークレットを読むものはすべて、unknown key-encryption keyと古い KEK のキー ID(local key manager: key "local:…" is not configured)を出して失敗します。ほかのサーバーへの配送と署名付きの取得(アクターの秘密鍵)、 2 段階認証でのサインイン、Webhook の署名、外部ログインのプロバイダーです。以前に発行したメディアプロキシの URL も動かなくなります。 パスワードと投稿は KEK で暗号化していないので、パスワードでのサインインと投稿の閲覧は動き続けます。そのため最初は問題に気づきにくいことがあります。 ログのエラーに注意してください。 - エラーが示すキー ID の KEK を見つけ、
kek(またはkek_previous)に設定して再起動します。KEK なしでシークレットを取り戻す方法はありません。 KEK を完全に失った場合はアクターの鍵を作り直す必要があり、ほかのサーバーからは、各アクターが同じアカウントの新しい鍵として見えます。
バックアップが使えるとわかるのは、一度復元してみたときだけです。インスタンスを公開する前と、バックアップの取り方を変えたあとに (少なくとも数か月ごとに)、復元を練習してください。
-
上のとおり、稼働中のインスタンスのバックアップを取ります。データベース、次にメディアです。
-
別のマシンか別の Compose プロジェクトで、保管している場所から取り出した KEK と設定(稼働中のサーバーからのコピーではなく)を使い、 アクターの URL が一致するように
hostを変えずに復元します。 -
コピーに連合させないでください。
role = webに設定します。これはジョブワーカーを動かしません。データベースと一緒に復元されたジョブには、バックアップを取った時点で実行予定だった配送が含まれており、それを実行するコピーは、本物のアクターの鍵で署名して、ほかのサーバーにもう一度送ってしまいます。 コピーをインターネットから切り離すだけでは、確実に保証するのが難しいため十分ではありません。コピーを動かし続ける場合は、下の確認が通ったらメンテナンスモードに切り替えます。 -
Compose の外で、たとえばローカルのマシンからクラウドのインスタンスに対して行う場合は、稼働中のインスタンスに何も触れないよう、コピーに次の設定をします。
設定 コピーでの値 理由 rolewebジョブを実行しないので、復元されたものが再び配送されません queuedbコピーで投入されたジョブは、稼働中のキューには届かず、コピーのデータベースに残ります streampostgresインスタンスの稼働中のイベントストリームに参加しません mailnone実際の利用者にメールを送りません blob ストア 復元したメディアを入れた新しいバケット(またはディレクトリ) 稼働中のバケットには触れません database_url復元したデータベース 稼働中のものは決して指定しません KEK( MY_KEK、またはkey_managerとkms_key)稼働中と同じ。保管している場所から取り出します これがないとコピーは起動しません host稼働中と同じ アクターの URL が一致するようにするためです -
起動と確認 を一通り行います。サインイン、投稿とメディア、そしていくつかのアクターの
publicKeyを稼働中のインスタンスと比べます。 -
KEK なしで一度、別の KEK で一度起動し、正しい KEK がないとき のとおりに失敗することを確かめます。
-
各手順にかかった時間を記録します。それが、実際の復元でインスタンスが止まる時間です。
LLM とコーディングエージェント向け:llms.txt,llms-full.txt, llms-small.txt