

Esta página é uma tradução automática da página em inglês, que é a versão de referência. Ler a página em inglês
Manutenção
Como tirar o servidor do ar para trabalhar no banco de dados, no KV ou na fila, e o que mostrar enquanto ele está fora.
Há duas ferramentas:
- O modo de manutenção (
maintenance = true,MY_MAINTENANCE=trueoumy serve -maintenance). Omy serveinicia sem abrir nenhum adaptador e responde a cada requisição com um503, umRetry-Aftere uma resposta que cada cliente entende. Use-o sempre que o própriomy servepuder rodar. - A página exportada (
my maintenance export). HTML estático do mesmo template, para um balanceador de carga, uma CDN ou um proxy reverso servir quando omy servenão consegue rodar de jeito nenhum (uma imagem sendo substituída, uma revisão que não inicia). Veja Exportando a página de manutenção.
O que o modo de manutenção responde
Seção intitulada “O que o modo de manutenção responde”O processo lê apenas o endereço de escuta, host, account_domain, web_origin, os proxies (trusted_proxies, trusted_proxy_header),
a verificação de origem (origin_secret, origin_secret_previous, origin_secret_header), status_page_url e as configurações maintenance_* (referência de configuração).
As configurações do banco de dados, da fila, do armazenamento de blobs, do KV, do e-mail e do stream não são lidas nem verificadas, então podem estar erradas ou inacessíveis nesse meio-tempo.
Qualquer que seja o role, ele serve apenas HTTP: sem jobs, sem jobs periódicos, sem broker de stream. Ele também serve HTTP simples qualquer que seja o valor de tls,
em listen ou no padrão :8080 (servindo HTTPS a partir do servidor).
my config check -maintenance verifica exatamente o que o modo de manutenção lê.
Com origin_secret definido, uma requisição que precisa do cabeçalho e não o tem recebe o 403 daquela verificação, em vez da tabela abaixo.
| Requisição | Status | Corpo |
|---|---|---|
GET /healthz, GET /readyz, GET /health/live, GET /health/ready |
200 |
{"status":"maintenance"} |
GET /api/v1/instance/health |
503 |
{"status":"maintenance"} |
O restante da API do cliente (/api/*) e os endpoints OAuth que respondem JSON |
503 |
application/problem+json do tipo /api/v1/problems/maintenance, com message, until e status_page_url quando definido |
ActivityPub (pelo caminho, Accept ou Content-Type), WebFinger, host-meta, NodeInfo, os webhooks de pagamento, as chamadas do Cloud Tasks e do Cloud Scheduler (/_internal/*) |
503 |
{"error":"maintenance"} |
| Qualquer outra coisa (páginas, o cliente web, seus recursos, envios de formulário) | 503 |
A página de manutenção, ou o problema quando Accept pede JSON |
Toda resposta tem Retry-After e Cache-Control: no-store. Retry-After conta os segundos até maintenance_until, enquanto ele estiver no futuro
(no máximo 86.400), e é maintenance_retry_after (uma duração do Go, padrão 10m) caso contrário.
A página e o problema mostram:
| Configuração | Exibido como |
|---|---|
maintenance_server_name |
O nome do servidor. O nome do host quando não definido (o nome próprio da instância fica no banco de dados) |
maintenance_message |
Um aviso em texto simples, com no máximo 2.000 caracteres, igual em todos os idiomas |
maintenance_until |
Quando o trabalho deve terminar (RFC 3339). A página mostra em UTC; o cliente web, no fuso horário do usuário |
status_page_url |
Um link para a página de status (Monitoramento) |
As configurações maintenance_* podem continuar definidas durante a operação normal: elas são usadas apenas enquanto maintenance for true.
As palavras da página seguem o Accept-Language (inglês caso contrário).
O cliente web mostra um aviso de manutenção em tela cheia quando a API responde com o problema de manutenção,
mantém o usuário conectado e tenta de novo depois do Retry-After.
Por quanto tempo
Seção intitulada “Por quanto tempo”Mantenha a manutenção dentro de algumas horas. Outros servidores tentam de novo suas entregas em caso de 503, mas nenhum deles lê o Retry-After,
e quando as tentativas se esgotam, as atividades enviadas nesse meio-tempo se perdem para este servidor.
A janela de nova tentativa mais curta entre as principais implementações é de cerca de um dia (Akkoma cerca de 1 dia, Misskey cerca de 1,5 dia, Mastodon cerca de 2 a 3 dias, Pleroma cerca de 7 dias,
pelos seus cronogramas de nova tentativa).
Os buscadores tratam um 503 curto como uma indisponibilidade temporária, mas o Google recomenda não servir 503 para o robots.txt por mais de um ou dois dias.
Uma parada mais longa que um ou dois dias não é uma manutenção: encerre o serviço em vez disso (Encerrando o serviço).
- Avise. Publique a janela na página de status (
status_page_url) e como um anúncio (Administração → Anúncios) com antecedência. Definamaintenance_messageemaintenance_untilna configuração da implantação, e atualize as páginas exportadas (my maintenance export) se o front end as servir. - Pare a fila de push (Cloud Tasks) — veja abaixo. Caso contrário, cada entrega durante a janela é um
503que consome uma das tentativas da tarefa. - Mude para o modo de manutenção: reimplante com
MY_MAINTENANCE=true(conforme o alvo abaixo). Cada réplica reinicia no modo de manutenção; o balanceador de carga as mantém porque/readyzresponde200. - Faça o trabalho.
- Volte ao normal: reimplante sem
MY_MAINTENANCE(ou comfalse), confirme que/health/readye/api/v1/instance/healthrespondem{"status":"ok"}, e então retome a fila de push e feche o anúncio.
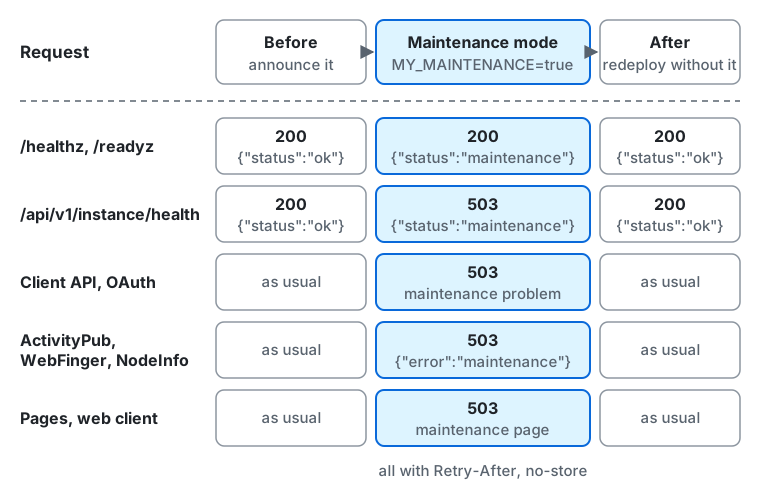
Da esquerda para a direita:
- Antes, enquanto você anuncia a manutenção, toda requisição é respondida como de costume:
/healthz,/readyze/api/v1/instance/healthrespondem200com{"status":"ok"}. - No modo de manutenção (
MY_MAINTENANCE=true):/healthz,/readyz,/health/livee/health/readyrespondem200com{"status":"maintenance"}./api/v1/instance/healthresponde503com{"status":"maintenance"}.- O restante da API do cliente e os endpoints OAuth que respondem JSON recebem
503com o problema de manutenção. - ActivityPub, WebFinger e NodeInfo respondem
503com{"error":"maintenance"}. - As páginas e o cliente web recebem
503com a página de manutenção. - Toda resposta tem
Retry-AftereCache-Control: no-store.
- Depois que você reimplanta sem
MY_MAINTENANCE, toda requisição volta a ser respondida como de costume.
Filas de push
Seção intitulada “Filas de push”-
Cloud Tasks: pause a fila, o que continua aceitando novas tarefas mas para de entregá-las, e retome-a depois do trabalho. O número de tentativas de uma tarefa é o
retryConfig.maxAttemptsda fila.Janela do terminal gcloud tasks queues pause my-jobs --location=asia-northeast1gcloud tasks queues resume my-jobs --location=asia-northeast1Pause também o job do Cloud Scheduler de
/_internal/tick(gcloud scheduler jobs pause/resume), ou deixe as suas chamadas falharem com503nesse meio-tempo. Os jobs em si estão no banco de dados: uma tarefa que esgotou as tentativas perde apenas o seu sinal, e o primeiro tick após o trabalho sinaliza de novo cada job que estiver vencido.
Por alvo
Seção intitulada “Por alvo”As páginas de erro dos front ends abaixo respondem aos erros do servidor com a página exportada. Aplique a regra apenas aos erros de um servidor que não está rodando
(502 e 504, e o 503 do próprio balanceador de carga quando ele não tem backend saudável), ou ative a regra somente enquanto o my serve não consegue rodar:
uma regra para todo 503 também substituiria as próprias respostas do modo de manutenção, como o problema que a API do cliente e o cliente web leem.
Cloud Run
Seção intitulada “Cloud Run”Implante uma nova revisão com a variável e remova-a depois:
gcloud run services update my --region=asia-northeast1 \ --update-env-vars=MY_MAINTENANCE=true,MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Zgcloud run services update my --region=asia-northeast1 --remove-env-vars=MY_MAINTENANCE,MY_MAINTENANCE_UNTILCom o módulo OpenTofu, defina-o no bloco, como settings = { maintenance = "true" }, e aplique, pois a próxima aplicação restaura
o que o bloco diz: Implantando no Cloud Run mostra isso em torno de uma atualização.
Quando o Cloud Run é exposto diretamente, sem balanceador de carga, não há nada na frente dele, então o modo de manutenção é a única ferramenta.
Quando o my serve não consegue rodar atrás de um Application Load Balancer externo global: envie o index.html exportado para um bucket do Cloud Storage
adicionado como backend bucket, e adicione uma política de resposta de erro personalizada que responda os 502 e 504 do backend com ele e overrideResponseCode: 503.
Apenas o Application Load Balancer externo global tem respostas de erro personalizadas (não os regionais nem os clássicos), e a política se aplica apenas
às respostas do backend, não às que o Google Front End gera por conta própria. Este caminho não consegue enviar Retry-After: os cabeçalhos personalizados da origem do erro não são adicionados.
# Part of the URL map (gcloud compute url-maps import).defaultCustomErrorResponsePolicy: errorService: https://www.googleapis.com/compute/v1/projects/<project>/global/backendBuckets/my-maintenance errorResponseRules: - matchResponseCodes: ["502", "504"] path: /index.html overrideResponseCode: 503AWS ECS
Seção intitulada “AWS ECS”Registre uma revisão da task definition do serviço com MY_MAINTENANCE=true no ambiente do contêiner, atualize o serviço para ela,
e faça o mesmo sem a variável depois. Com o módulo OpenTofu, defina-o no bloco, como settings = { maintenance = "true" },
e aplique, pois a próxima aplicação restaura o que o bloco diz: em torno de uma atualização, aplique o modo, depois a nova versão, depois o bloco sem ele,
como faz Implantando no Cloud Run.
Quando o my serve não consegue rodar atrás do CloudFront: envie o index.html exportado para um bucket do S3 que seja uma segunda origem
(a página de erro não pode vir da origem que está falhando), e adicione respostas de erro personalizadas para 502 e 504 (e 503 somente enquanto o my serve não consegue rodar)
com ResponsePagePath: /maintenance/index.html e ResponseCode: 503.
O CloudFront pode adicionar Retry-After por meio de uma response headers policy com um cabeçalho personalizado, mas a política se aplica a toda resposta do comportamento de cache,
então anexe-a apenas para a manutenção e desanexe-a depois.
A resposta fixa de um Application Load Balancer não consegue carregar a página exportada: o corpo tem no máximo 1.024 caracteres e não define cabeçalhos como Retry-After.
Use-a apenas para um texto curto e o status:
{ "Type": "fixed-response", "FixedResponseConfig": { "StatusCode": "503", "ContentType": "text/plain", "MessageBody": "This server is under maintenance. Please try again later. / メンテナンス中です。しばらくしてからお試しください。" }}Sem Retry-After, outros servidores tentam de novo no próprio cronograma, que a janela acima já permite.
Docker Compose
Seção intitulada “Docker Compose”deploy/docker/compose.yaml passa as configurações do .env para o servidor, e também recebe MY_MAINTENANCE, MY_MAINTENANCE_MESSAGE e MY_MAINTENANCE_UNTIL do shell.
Defina-as e recrie o serviço my, depois remova MY_MAINTENANCE e recrie-o de novo após o trabalho.
--no-deps impede que os serviços de banco de dados de execução única (upgrade-check, schema, upgrade) rodem; uma atualização os executa (Atualizando):
MY_MAINTENANCE=true MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Z docker compose up -d --no-deps --force-recreate mydocker compose up -d --no-deps --force-recreate myQuando o my serve não consegue rodar atrás do nginx: sirva as páginas exportadas a partir de um diretório, escolha uma pelo Accept-Language,
e responda os próprios 502 e 504 do nginx (o servidor está fora do ar ou não responde) com ela, como 503.
Os 503 do próprio modo de manutenção passam sem alteração, já que proxy_intercept_errors permanece desligado.
map $http_accept_language $maintenance_page {    default  en.html;    ~*^ja    ja.html;}
server {    # ...    location / {        proxy_pass http://my:8080;        error_page 502 504 =503 /maintenance/$maintenance_page;    }    location /maintenance/ {        internal;        alias /srv/maintenance/;   # the -out directory of my maintenance export        add_header Retry-After 600 always;        add_header Cache-Control no-store always;    }}
microk8s (Kubernetes)
Seção intitulada “microk8s (Kubernetes)”Defina a variável no Deployment, o que faz o rollout dos pods, e remova-a depois:
microk8s kubectl set env deployment/my MY_MAINTENANCE=true MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Zmicrok8s kubectl rollout status deployment/mymicrok8s kubectl set env deployment/my MY_MAINTENANCE- MY_MAINTENANCE_UNTIL-A readiness probe em /readyz continua passando no modo de manutenção, então o rollout termina e o Service continua roteando para os pods.
Quando o my serve não consegue rodar atrás do NGINX Ingress Controller (o add-on ingress do microk8s): sirva as páginas exportadas a partir de um pequeno
Deployment do nginx (por exemplo, a partir de um ConfigMap com index.html, en.html e ja.html) e torne-o o backend padrão personalizado,
com o controller respondendo os 502 e 504 do servidor a partir dele (adicione 503 somente enquanto o my serve não consegue rodar):
metadata: annotations: nginx.ingress.kubernetes.io/custom-http-errors: "502,504" nginx.ingress.kubernetes.io/default-backend: my-maintenance # a Service in the same namespaceMonitoramento durante a manutenção
Seção intitulada “Monitoramento durante a manutenção”/healthz,/readyz,/health/livee/health/readycontinuam em200com{"status":"maintenance"}: balanceadores de carga e o Kubernetes mantêm as instâncias./api/v1/instance/healthresponde503com{"status":"maintenance"}(Monitoramento). Monitores de disponibilidade veem o servidor como fora do ar, a menos que comparem o corpo ou tenham uma janela de manutenção; pause-os ou defina a janela.
Para LLMs e agentes de programação:llms.txt,llms-full.txt, llms-small.txt