

Esta página é uma tradução automática da página em inglês, que é a versão de referência. Ler a página em inglês
Banco de dados: inicializar, atualizar e recriar
Como os operadores criam o banco de dados, o atualizam para uma nova versão e, somente em instâncias de desenvolvimento e de teste, o apagam.
O esquema fica em schema/, um diretório por módulo com um arquivo por banco de dados (schema/<NN>-<module>/sqlite.sql e postgres.sql). O binário do servidor contém o esquema da sua versão, e
my schema apply o aplica: toda implantação o executa como um job avulso antes do servidor, com a imagem do servidor e as configurações de
banco de dados do servidor, de modo que a imagem do servidor é a única imagem de que uma instância precisa.
my serve nunca aplica o esquema. Iniciado em um banco de dados sem ele, o servidor responde 503 em /readyz (veja Iniciar o servidor).
Os dados que uma mudança de esquema precisa levar adiante (uma coluna dividida em duas, um valor movido para uma nova tabela) são reescritos pelo
próprio my db upgrade da imagem do servidor, que roda uma vez por versão depois que o esquema é aplicado. A ordem completa está em Atualizar.
Inicializar (aplicar o esquema)
Seção intitulada “Inicializar (aplicar o esquema)”my schema apply executa somente as instruções que levam o banco de dados ao esquema da sua versão: em um banco vazio, cria tudo;
em um banco já atualizado, não faz nada. É seguro executá-lo quantas vezes for preciso, e toda atualização o executa de novo.
Com my schema apply
Seção intitulada “Com my schema apply”my schema apply lê as configurações de banco de dados da configuração do servidor (database, database_url e database_dev_url,
de -config <file> ou do ambiente; ele não precisa de nenhuma outra configuração) e leva o banco de dados ao esquema da versão do binário:
my schema apply -dry-run # print the SQL statements it would run, and change nothingmy schema apply # run them- Ele imprime as instruções SQL que executa e as executa em uma única transação: quando uma falha, nenhuma permanece.
Um banco de dados que já corresponde ao esquema fica inalterado (
ok: the database matches the schema; nothing to apply). - Um plano que remove uma tabela ou uma coluna é recusado, e nada é executado, a menos que
-allow-destructiveseja informado. Use-o somente quando as notas de versão pedirem, depois de um backup. Reconstruir uma tabela do SQLite para alterá-la não conta como remoção. - No PostgreSQL, ele monta o esquema com o qual compara em um esquema temporário do mesmo banco de dados e o remove no fim,
inclusive em caso de falha; a função precisa do privilégio de criar um esquema ali. Onde ela não o tem, defina
database_dev_urlpara outro banco em que tenha (database_dev_url). As execuções contra um mesmo banco esperam umas pelas outras, então duas ao mesmo tempo terminam com sucesso. - Ele aceita
database = sqliteedatabase = postgres, e termina com1quando não aplicou nada por causa de um erro ou de uma remoção recusada.
A partir da v0.1.0, uma atualização entre versões compatíveis nunca contém uma diferença que perca dados; as versões anteriores à v0.1.0 podem remover colunas
e tabelas, e exigem -allow-destructive. Leia o SQL com -dry-run antes de toda atualização (veja Atualizar).
Por meio de um pooler de conexões
Seção intitulada “Por meio de um pooler de conexões”my schema apply precisa alcançar o banco de dados diretamente. Ele mantém um lock de sessão, que um pooler em modo de transação (o pooling de transação do PgBouncer, a string de conexão com pool do Neon) não preserva: por meio de um desses, duas execuções simultâneas travaram em vez de falhar. Informe a ele uma URL direta como database_url. pool_max_conns e os outros parâmetros pool_* podem continuar nela, e em database_dev_url e stream_postgres_url: os comandos que não abrem um pool os ignoram. my db upgrade, my db upgrade -check e o console usam a mesma URL.
my serve pode usar um pooler em modo de transação, desde que:
- o pooler trate prepared statements no nível do protocolo, que o servidor usa em toda consulta: PgBouncer 1.21 ou posterior com
max_prepared_statementsacima de 0, como a string de conexão com pool do Neon tem. Atrás de um pooler sem isso, as instruções falham aleatoriamente comprepared statement ... does not existoualready exists: adicionedefault_query_exec_mode=execà URL, o que as evita ao custo de uma ida e volta a mais por consulta. stream_postgres_urlcontenha uma URL direta quandostream = postgres, já queLISTENpertence a uma sessão. Um listener em uma URL com pool conecta e depois não recebe nada.- a URL não tenha
search_pathnem outro parâmetro que o pooler recuse na conexão: o PgBouncer fecha essa conexão, a menos queignore_startup_parameterso liste.
Docker Compose
Seção intitulada “Docker Compose”Em deploy/docker/compose.yaml, três serviços avulsos da imagem do servidor rodam nesta ordem, cada um somente
depois que o anterior teve sucesso, e o servidor (my) inicia por último:
| Serviço | Executa |
|---|---|
upgrade-check |
my db upgrade -check (passa em um banco de dados vazio) |
schema |
my schema apply, em /data/my.db ou, com a camada compose.postgres.yaml, no PostgreSQL dela (arquivos do Docker Compose) |
upgrade |
my db upgrade |
cd deploy/dockerdocker compose up -d # pulls the image of MY_VERSION; the three one-off services run in order, then my startscurl -fsS localhost:8080/readyz # ready when it answers {"status":"ok"}docker compose exec -T my my admin create -username alice -email alice@example.com < password.txt- Se qualquer um dos três falhar,
mynão inicia. Leia a saída comdocker compose logs upgrade-check(ouschema,upgrade). - A criação de administradores está em Administradores e funções.
Outras plataformas
Seção intitulada “Outras plataformas”Sem o Compose, execute my schema apply da imagem do servidor como um job avulso (um Job ou init container do Kubernetes, um job do Cloud Run e assim por diante),
com as mesmas configurações de banco de dados do servidor:
# SQLite: mount the volume that holds the database file at /datadocker run --rm -v my_data:/data -e MY_DATABASE=sqlite -e MY_DATABASE_URL=/data/my.db my schema apply
# PostgreSQLdocker run --rm -e MY_DATABASE=postgres -e MY_DATABASE_URL='postgres://my:...@db.example/my' my schema apply
O pool de conexões
Seção intitulada “O pool de conexões”O pool do PostgreSQL segue os parâmetros pool_* de database_url: pool_max_conns (por padrão o maior valor entre 4 e o número de CPUs) e pool_min_conns, as conexões que ele mantém quando nada é pedido, com pool_max_conn_idle_time (30 minutos) fechando as demais. Defina pool_min_conns para uma instância cujas requisições chegam muito espaçadas, ou cada uma abre uma conexão.
O SQLite também aceita pool_max_conns, com o mesmo padrão, e pool_max_idle_conns, o máximo de conexões ociosas que ele mantém, um teto e não um piso como pool_min_conns (por padrão, todas elas, e nenhuma é fechada por tempo, então uma instância calma responde na hora). Uma nova conexão analisa o esquema antes da primeira consulta, e é por isso que o pool mantém as suas conexões.
Atualizar
Seção intitulada “Atualizar”Uma atualização para uma nova versão sempre executa estes passos, nesta ordem, com a imagem do servidor da nova versão:
- Faça backup do banco de dados (e, com o armazenamento de blobs em sistema de arquivos, da mídia). Veja Backup.
my db upgrade -check. Ele não altera nada. Termina com1quando o novo esquema descartaria dados que o banco de dados ainda não transferiu, e nomeia a versão pela qual atualizar primeiro; então pare e siga Pular versões. Um banco de dados vazio passa.my schema apply, como em Inicializar. Verifique antes o SQL com-dry-run.my db upgrade. Ele executa cada passo de atualização de dados da versão que o banco de dados ainda não registrou, reconstrói as projeções que esses passos nomeiam e registra cada passo. Executado de novo, não faz nada. Se um passo falha, ele termina com1; os passos que foram concluídos continuam registrados, e executá-lo de novo retoma a partir do que falhou.- Inicie o novo servidor. Ele responde
503em/readyze registra no log os passos que faltam até que todo passo de atualização de dados da sua versão esteja registrado.
my serve nunca executa my db upgrade -check, my schema apply nem my db upgrade; eles são jobs avulsos. Execute apenas um deles por vez contra um banco de dados.
Executar os passos em um único job
Seção intitulada “Executar os passos em um único job”my upgrade executa os passos 2 a 4 em um único processo, depois das verificações de my config check, para que um único job avulso (uma execução de job do Cloud Run,
uma tarefa do ECS, um Job do Kubernetes) conduza toda a migração:
my config checkmy db upgrade -checkmy schema apply, com-allow-destructivequandomy upgradeo recebemy db upgrade
Ele para no primeiro passo que falha e termina com o código desse passo; os passos seguintes não são executados. Cada passo imprime uma linha que o nomeia,
como ==> my schema apply, e depois a saída desse comando, para que o log do job mostre onde ele parou. Depois de corrigir a causa, execute
my upgrade de novo: os passos que foram concluídos não encontram mais nada a fazer. -config <file> é passado a todos os passos.
my upgrade -dry-run executa my config check, my db upgrade -check e my schema apply -dry-run, e não altera nada: leia o SQL que ele
imprime antes da atualização. Faça backup do banco de dados antes de my upgrade, como no passo 1; ele não passa para o modo de manutenção nem inicia
o servidor.
A maioria das versões não acrescenta nenhum passo de atualização de dados: my db upgrade -check imprime ok: the database can be upgraded to this release e, em um
banco de dados que registrou os passos das versões anteriores, my db upgrade imprime ok: no data upgrade step to run. Um banco de dados novo registra
todos os passos da versão no seu primeiro my db upgrade, sem nada a reescrever. Execute os dois mesmo assim, para que o procedimento não dependa de ler
todas as notas de versão.
A seção Atualização das notas de versão lista os passos de cada versão.
O servidor durante uma atualização
Seção intitulada “O servidor durante uma atualização”Atualizações sem tempo de inatividade não são garantidas. O servidor anterior continua funcionando no novo esquema durante o curto intervalo entre os passos 3 e 5,
mas não pode participar dos passos de atualização de dados. Passe para o modo de manutenção durante a atualização: no modo de manutenção,
my serve não abre nenhuma conexão com o banco de dados, então o backup é consistente e nada grava enquanto os passos rodam.
Mantenha a janela de manutenção em poucas horas (quanto tempo).
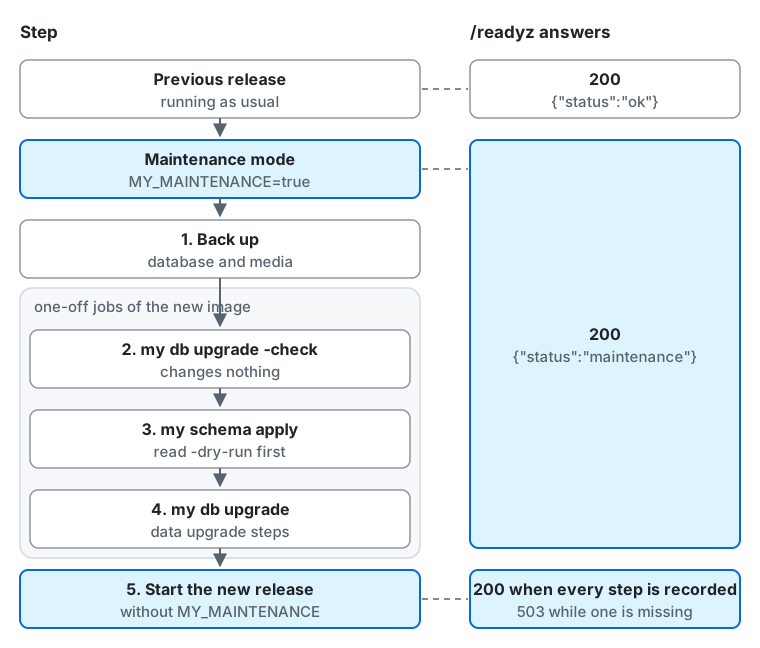
Do topo do diagrama para baixo:
- Versão anterior. O servidor roda normalmente, e
/readyzresponde200com{"status":"ok"}. - Modo de manutenção. Reimplante com
MY_MAINTENANCE=true. A partir de agora e até a nova versão iniciar,/readyzresponde200com{"status":"maintenance"}, de modo que o balanceador de carga mantém as instâncias enquanto nada alcança o banco de dados. - 1. Faça backup do banco de dados e da mídia.
- 2 a 4: os jobs avulsos da nova imagem.
my db upgrade -checknão altera nada;my schema applyroda depois que você lê o-dry-rundele;my db upgradeexecuta os passos de atualização de dados. - 5. Inicie a nova versão sem
MY_MAINTENANCE./readyzresponde200com{"status":"ok"}quando todos os passos de atualização de dados da versão estão registrados, e503enquanto algum falta (ou o esquema não foi aplicado).
Com o Docker Compose, docker compose up substitui o contêiner do modo de manutenção antes de os jobs avulsos rodarem, então nada responde
em /readyz durante os passos 2 a 4 (Docker Compose).
Verificar o SQL com -dry-run
Seção intitulada “Verificar o SQL com -dry-run”Antes de o passo 3 aplicar qualquer coisa, execute my schema apply -dry-run e leia o que ele executaria.
Adições (CREATE TABLE, ADD COLUMN, CREATE INDEX) são o que a maioria das versões contém. Uma tabela de projeção também pode ser reconstruída,
e my db upgrade a preenche de novo a partir dos eventos. Um DROP de qualquer outra coisa, ou uma mudança de tipo, deve constar na seção
Breaking changes das notas de versão; se não constar, pare e relate o problema antes de aplicar. my schema apply recusa um plano que remove uma tabela
ou uma coluna, a menos que -allow-destructive seja informado.
Docker Compose
Seção intitulada “Docker Compose”docker compose up -d executa os passos 2 a 5 sozinho, em ordem (veja a tabela em Inicializar). Se qualquer um deles falhar, o novo servidor não inicia.
cd deploy/docker
# 1. Switch to the maintenance mode. --no-deps keeps the one-off services from running.MY_MAINTENANCE=true docker compose up -d --no-deps --force-recreate my
# 2. Back up the volume (database and media) while the maintenance mode holds no connection.docker run --rm -v my_data:/data -v "$PWD":/backup busybox tar czf /backup/my-data-$(date +%Y%m%d%H%M).tar.gz -C /data .
# 3. Set MY_VERSION in .env to the new version (0.2.0, or its digest form 0.2.0@sha256:... from the notes), and pull it.docker compose pull
# 4. Check the SQL that the schema service will run.docker compose run --rm --no-deps upgrade-checkdocker compose run --rm --no-deps schema schema apply -dry-run
# 5. Upgrade: upgrade-check, schema, upgrade, then my starts again without the maintenance mode.docker compose up -dcurl -fsS localhost:8080/readyz
docker compose up substitui o contêiner my antes de os serviços avulsos rodarem e só inicia o novo depois que os três tiveram sucesso.
Se um falhar, docker compose up informa e o servidor continua parado: coloque à frente, enquanto isso, a página de manutenção exportada.
Leia docker compose logs <service> e então corrija a causa e execute docker compose up -d de novo, ou faça o rollback.
O nome do volume my_data é o nome do projeto do Compose (my) seguido do nome do volume (data).
MY_VERSION é a única coisa que uma atualização altera, e nada a altera por você: não existe tag latest, e 0.1 só se move dentro da v0.1. Com MY_VERSION=0.1, o passo 3 é apenas docker compose pull, que pega o patch mais recente.
Para compilar a partir do código-fonte, faça checkout da tag da nova versão e use docker compose -f compose.yaml -f compose.build.yaml build no passo 3, e as mesmas opções -f nos outros passos.
Kubernetes
Seção intitulada “Kubernetes”Execute os passos 2 a 4 como um único Job antes de distribuir a nova imagem. Os init containers rodam um após o outro, cada um somente depois que o anterior teve sucesso, e o contêiner principal roda por último, então uma falha interrompe o Job antes do próximo passo. Dê aos contêineres a mesma configuração do Deployment.
apiVersion: batch/v1kind: Jobmetadata: name: my-upgrade-v0-2-0spec: backoffLimit: 0 template: spec: restartPolicy: Never initContainers: - name: upgrade-check image: ghcr.io/mycroblog/my:0.2.0 args: [db, upgrade, -check] envFrom: [{ secretRef: { name: my-config } }] # the Deployment's settings - name: schema image: ghcr.io/mycroblog/my:0.2.0 args: [schema, apply] envFrom: [{ secretRef: { name: my-config } }] containers: - name: upgrade image: ghcr.io/mycroblog/my:0.2.0 args: [db, upgrade] envFrom: [{ secretRef: { name: my-config } }]kubectl set env deployment/my MY_MAINTENANCE=true && kubectl rollout status deployment/my# back up, and check the SQL with a one-off Pod of the new image: my schema apply -dry-runkubectl apply -f my-upgrade-v0-2-0.yamlkubectl wait --for=condition=complete --timeout=30m job/my-upgrade-v0-2-0kubectl set image deployment/my my=ghcr.io/mycroblog/my:0.2.0kubectl set env deployment/my MY_MAINTENANCE-kubectl rollout status deployment/mySe o Job falhar, kubectl logs job/my-upgrade-v0-2-0 -c upgrade-check (ou -c schema, -c upgrade) mostra o motivo, e o Deployment continua na imagem anterior.
Com SQLite em um volume, monte o mesmo volume no Job e pare antes os pods do Deployment: o SQLite aceita um único escritor.
Cloud Run
Seção intitulada “Cloud Run”Com o módulo OpenTofu, uma atualização é um apply da nova versão, que executa my upgrade no job de migração antes de os serviços adotarem
a nova imagem, e para ali quando ele falha: veja Implantação no Cloud Run. Manualmente:
Os jobs do Cloud Run executam um contêiner cada, então crie um job por passo e execute-os em ordem com --wait, que falha quando o job falha.
Dê aos jobs as mesmas variáveis de ambiente e os mesmos segredos do serviço.
gcloud run services update my --region=asia-northeast1 --update-env-vars=MY_MAINTENANCE=true# back up (see below)
gcloud run jobs deploy my-upgrade-check --region=asia-northeast1 --image=ghcr.io/mycroblog/my:0.2.0 \  --args=db,upgrade,-check --set-env-vars=... --set-secrets=...gcloud run jobs deploy my-schema --region=asia-northeast1 --image=ghcr.io/mycroblog/my:0.2.0 \  --args=schema,apply --set-env-vars=... --set-secrets=...gcloud run jobs deploy my-upgrade --region=asia-northeast1 --image=ghcr.io/mycroblog/my:0.2.0 \  --args=db,upgrade --set-env-vars=... --set-secrets=...
gcloud run jobs execute my-upgrade-check --region=asia-northeast1 --wait &&  gcloud run jobs execute my-schema --region=asia-northeast1 --wait &&  gcloud run jobs execute my-upgrade --region=asia-northeast1 --wait &&  gcloud run deploy my --region=asia-northeast1 --image=ghcr.io/mycroblog/my:0.2.0 --remove-env-vars=MY_MAINTENANCE
Para verificar antes o SQL, implante o job do esquema com --args=schema,apply,-dry-run, execute-o e leia os logs dele antes de reimplantá-lo para o apply.
Faça o backup depois que o servidor parou de gravar (no modo de manutenção, ou parado) e antes de qualquer passo da atualização. Backup e restauração trata cada parte em detalhe; para uma atualização:
-
SQLite: copie o arquivo do banco de dados junto com os arquivos
-wale-shm, enquanto nenhum processo o mantém aberto. Com o Compose, otardo volume acima também cobre a mídia em/data/blobs. -
PostgreSQL:
pg_dumpno formato custom, que opg_restorelê.Janela do terminal pg_dump --format=custom --file=my-$(date +%Y%m%d%H%M).dump "postgres://my:...@db.example/my"O backup próprio de um banco de dados gerenciado (um backup sob demanda do Cloud SQL, um snapshot do RDS) também serve; faça-o no mesmo ponto.
-
Mídia: o armazenamento de blobs em sistema de arquivos é um diretório a copiar junto com o banco de dados.
-
A KEK não está no banco de dados. Mantenha-a onde já está; um banco de dados restaurado precisa da mesma KEK.
Rollback
Seção intitulada “Rollback”Não há migrações reversas. Para voltar, restaure o backup feito antes da atualização e então inicie a versão anterior:
- Pare o novo servidor (ou passe-o para o modo de manutenção).
- Restaure o backup: com o Compose, extraia o arquivo para o volume esvaziado
(
docker run --rm -v my_data:/data -v "$PWD":/backup busybox sh -c 'rm -rf /data/* && tar xzf /backup/<archive> -C /data'); com o PostgreSQL,pg_restore --clean --if-exists --dbname=<url> <dump>. - Inicie a imagem da versão anterior (com o Compose, volte
MY_VERSIONpara a versão anterior e então executedocker compose up -d).
Tudo o que a nova versão gravou depois da atualização se perde, então faça o rollback logo após a atualização, antes que a instância federe muito.
Pular versões
Seção intitulada “Pular versões”Cada versão aceita atualizações da mesma versão menor (por exemplo, v0.2.1 para v0.2.4) e do último patch da versão menor anterior
(o último v0.1.x para v0.2.y). Os patches nunca removem colunas nem tabelas, então dentro de uma versão menor qualquer ordem funciona.
Para atravessar mais de uma versão menor, atualize passando pelo último patch de cada versão menor em sequência, executando o procedimento inteiro a cada vez.
De v0.1.3 para v0.4.0, por exemplo: o último v0.1.x, depois o último v0.2.x, depois o último v0.3.x e então v0.4.0.
my db upgrade -check interrompe um salto que perderia dados e nomeia a versão por onde passar; nesse ponto, nada foi alterado.
Verificar e reconstruir projeções
Seção intitulada “Verificar e reconstruir projeções”Algumas tabelas são projeções: o servidor as deriva dos eventos e dos recursos do módulo delas (as restrições de uma conta a partir das suas ações de moderação, por exemplo). O worker verifica todas as projeções uma vez por dia e corrige qualquer diferença que encontrar. Para verificar ou corrigir uma manualmente:
my projection list # each projection with its module and tablesmy projection verify [<name>] # derive every projection, or the one named, and print the rows that differ; changes nothingmy projection rebuild [<name>] # derive them the same way and write the difference<name>é uma projeção ou uma das suas tabelas.verifyimprime as linhas que as tabelas contêm mas as fontes não derivam (-) e as linhas que as fontes derivam mas as tabelas não têm (+), e termina com1quando alguma difere.rebuildgrava no máximo 500 linhas por transação, de modo que os leitores nunca veem uma projeção esvaziada. Execute-o enquanto a instância está calma: uma linha que muda durante a reconstrução mantém o novo valor, e umverifyposterior relata qualquer diferença restante.
Recriar (apagar todas as linhas)
Seção intitulada “Recriar (apagar todas as linhas)”Recriar significa esvaziar o banco de dados e aplicar o esquema de novo. A partir da v0.1.0, recriar é só para instâncias de desenvolvimento e de teste.
Nunca recrie uma instância pública que federa com outros servidores.
Todas as linhas se perdem e não podem ser recuperadas. As chaves de conta protegidas com a chave de criptografia de chaves (KEK) também se perdem, então uma conta recriada com o mesmo nome de host recebe uma chave diferente e é outro Actor para os demais servidores, e as relações de seguimento remotas dela não voltam. Uma instância pública que não consegue aplicar uma mudança de esquema faz o rollback a partir do backup.
Não existe um comando my que apague um banco de dados: remova-o com as ferramentas do próprio banco e depois aplique o esquema de novo.
O banco de dados vazio não tem host nem account_domain registrados, então a próxima inicialização registra os valores configurados.
Docker Compose
Seção intitulada “Docker Compose”cd deploy/dockerdocker compose stop my # stop the serverdocker run --rm -v my_data:/data busybox rm -f /data/my.db /data/my.db-wal /data/my.db-shmdocker compose up -d # the one-off services apply the schema to the empty database, then my starts- A mídia enviada e processada (
/data/blobs) permanece. Para apagá-la junto com o banco de dados, remova o volume nomeado comdocker compose down -ve então executedocker compose up -d. Sem-v, o volume é mantido. - Para guardar uma cópia antes, pare o servidor e copie
my.db(com os arquivos-wale-shm) do volume.
PostgreSQL
Seção intitulada “PostgreSQL”Remova o banco de dados e crie-o de novo, vazio, com o mesmo proprietário (ou pelo console do banco de dados gerenciado), e então execute my schema apply:
# stop every server and job that uses the database firstdropdb --maintenance-db="postgres://postgres:...@db.example/postgres" mycreatedb --maintenance-db="postgres://postgres:...@db.example/postgres" --owner=my mymy schema applyPara LLMs e agentes de programação:llms.txt,llms-full.txt, llms-small.txt