

Esta página é uma tradução automática da página em inglês, que é a versão de referência. Ler a página em inglês
Visão geral de um servidor da mycroblog
A primeira página a ler antes de rodar um servidor. A mycroblog é um microblog que se federa com o restante do fediverso
por meio do ActivityPub; o my é o software do servidor, um único binário que reúne o servidor, o worker de jobs, o
cliente web e os comandos que cuidam deles. Esta página mostra do que um servidor é feito, o que você escolhe por
configuração, como um servidor pequeno cresce até ficar grande, e onde ler em seguida.
Do que um servidor é feito
Seção intitulada “Do que um servidor é feito”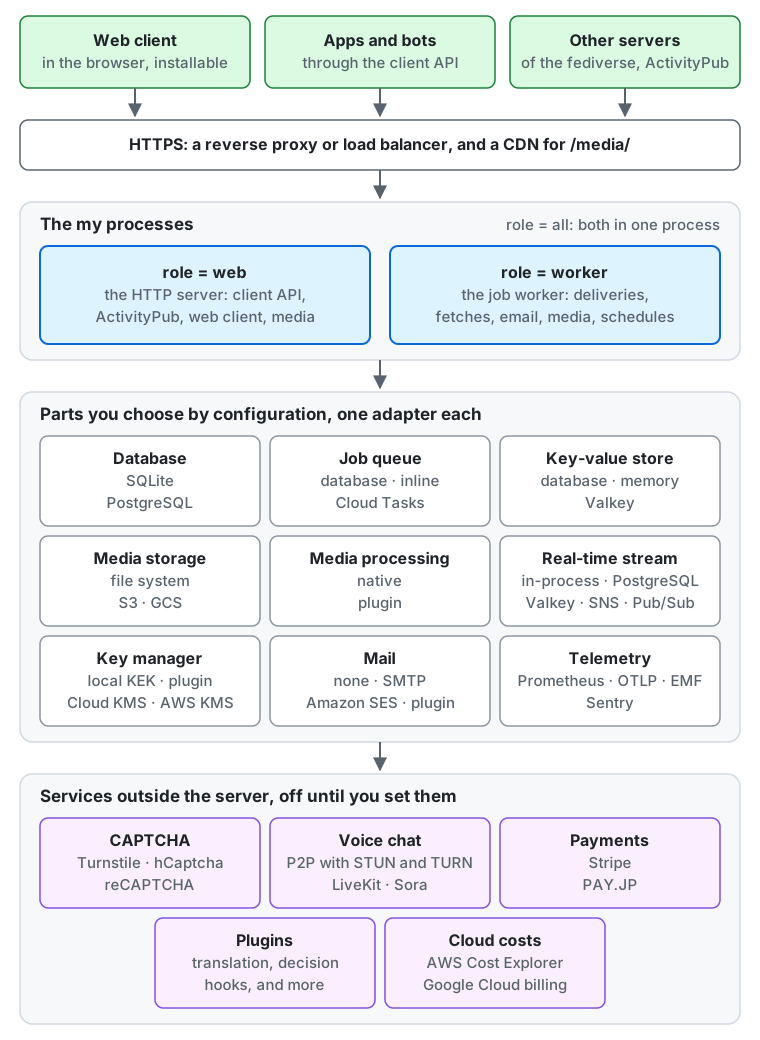
De cima para baixo no diagrama:
- Quem se conecta. As pessoas usam o cliente web no navegador (ele pode ser instalado como app), apps e bots usam a API do cliente, e outros servidores do fediverso entregam e buscam publicações por ActivityPub. Todos alcançam o servidor por HTTPS.
- Na frente do servidor. Por padrão o
myfala HTTP simples, então um proxy reverso ou balanceador de carga termina o HTTPS na frente dele. Em uma única máquina, omypode servir HTTPS por conta própria (servindo HTTPS pelo servidor). Uma CDN na frente dos arquivos de mídia é opcional. - Os processos
my. Cada processo executamy serve, e oroledele diz o que ele executa:webo servidor HTTP,workero worker de jobs, que entrega publicações, busca em outros servidores, envia e-mail, processa mídia e executa os jobs periódicos, eall, o padrão, os dois em um só processo. - As partes que você escolhe. Cada parte no meio do diagrama tem uma configuração que escolhe o adaptador dela, listadas na próxima seção.
- Serviços fora do servidor. CAPTCHA, chat de voz, pagamentos, plugins e a importação de custos de nuvem ficam desativados até você configurá-los, e o servidor então chama o serviço que você indicar.
Partes que você escolhe por configuração
Seção intitulada “Partes que você escolhe por configuração”Cada parte é uma configuração da referência de configuração, definida em um arquivo TOML ou como
variável de ambiente (MY_ e a chave em maiúsculas, como MY_DATABASE). A primeira opção de cada lista é o padrão.
Onde uma parte guarda dados, escolha-a antes da primeira inicialização: os dados não se movem sozinhos quando a configuração muda.
| Parte | Configuração | Opções | Leia a seguir |
|---|---|---|---|
| Banco de dados | database |
sqlite (um arquivo), postgres (PostgreSQL e serviços compatíveis) |
Banco de dados, backup |
| Fila de jobs | queue |
db (uma tabela no banco de dados), inline (executa cada job na hora no mesmo processo, para testes e desenvolvimento), cloudtasks (o Google Cloud Tasks acorda o servidor para cada job; exige PostgreSQL) |
A fila de jobs |
| Armazenamento chave-valor, para caches, limites de taxa e as respostas guardadas por um dia para escritas reenviadas | kv |
db (uma tabela no banco de dados), memory (cada processo por si), valkey (Valkey ou outro servidor com protocolo Redis, compartilhado por todos os processos) |
kv |
| Armazenamento de mídia | blob |
fs (um diretório), s3 (Amazon S3, Cloudflare R2, MinIO, Garage e outros armazenamentos compatíveis com S3), gcs (Google Cloud Storage) |
Arquivos do Docker Compose, backup da mídia |
| Processamento de mídia | media_image, media_video, media_audio, um para cada tipo de arquivo |
native (no servidor), plugin (um plugin seu converte os arquivos desse tipo) |
Convertendo mídia |
| Fluxo em tempo real entre processos | stream |
hub (dentro de um processo), postgres (LISTEN / NOTIFY), valkey, sns (Amazon SNS e SQS), pubsub (Google Cloud Pub/Sub) |
stream |
| Gerenciador de chaves, que criptografa as chaves privadas das contas | key_manager |
local (uma chave de criptografia de chaves que você guarda), gcpkms (Google Cloud KMS), awskms (AWS KMS), plugin |
Gerenciando a chave |
mail |
none, smtp, ses (Amazon SES), plugin |
Enviando e-mail | |
| CAPTCHA | captcha |
none, turnstile (Cloudflare Turnstile), hcaptcha, recaptcha (Google reCAPTCHA v2) |
CAPTCHA |
| Chat de voz | voice |
off, p2p (de navegador para navegador, com TURN de voice_turn: none, coturn ou cloudflare), livekit, sora |
Chat de voz |
| Pagamentos de apoiadores | payments |
none, stripe, payjp (PAY.JP) |
Apoiadores, Stripe, PAY.JP |
| Plugins | plugin_<kind>_address |
nenhum por padrão; um endereço para cada tipo: translator, search, billing, mailer, media_image, media_video, media_audio, key_manager e os ganchos de decisão inbound.status, local.status, inbound.follow, signup.check, media.check, inbound.actor, local.profile |
Plugins, ganchos de decisão |
| Tradução de publicações | translator_<provider>_*, plugin_translator_address |
nenhum (apenas a tradução do próprio navegador); libretranslate, deepl, google (Google Cloud Translation), aws (Amazon Translate) ou um plugin seu na frente do serviço que você escolher |
Traduzindo publicações, um plugin tradutor |
| Busca de texto completo das publicações | search |
none; ou elasticsearch, opensearch ou meilisearch (mecanismos de busca); ou plugin, um plugin seu na frente de outro mecanismo |
Busca de texto completo, um plugin de busca |
| CDN para mídia | media_origin |
não definido (o servidor serve a mídia a partir da própria origem) ou a origem da sua CDN | Servindo mídia por uma CDN |
| Custos de nuvem | billing_sources |
nenhum, ou qualquer um de aws (AWS Cost Explorer), gcp (exportação de cobrança ou orçamento do Google Cloud), cloudflare (cobranças de uso da Cloudflare), plugin |
Importando custos de nuvem |
| Métricas | metrics_exporter |
none, prometheus, otlp (OpenTelemetry), emf (CloudWatch) |
Métricas, alertas |
| Traces | traces_exporter |
none, otlp |
Traces |
| Relatórios de erros | errors_exporter |
none (apenas a linha de log e os grupos de erros), sentry (Sentry, GlitchTip, Datadog), otlp |
Relatório de erros |
O binário e a imagem de contêiner publicados trazem todos os adaptadores da tabela.
my config check relata todos os problemas da configuração de uma vez, antes de você iniciar o servidor
(lista de verificação de produção).
De um servidor pequeno a um grande
Seção intitulada “De um servidor pequeno a um grande”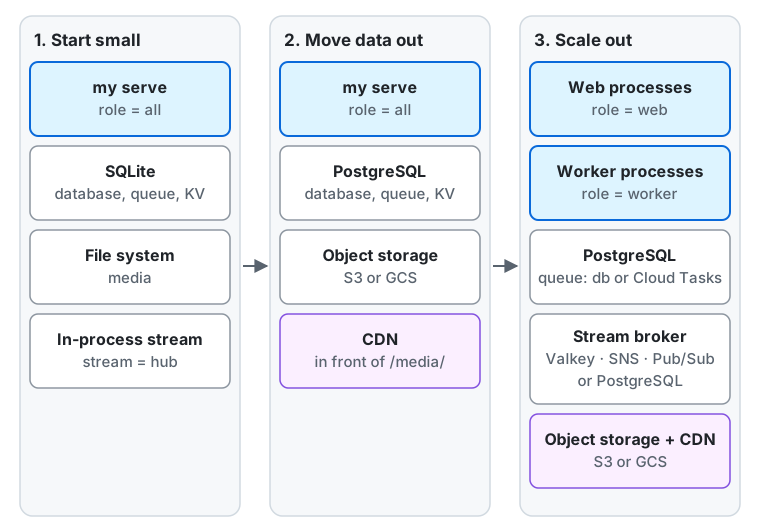
- Comece pequeno. Um processo com
role = all, em SQLite, com a mídia no sistema de arquivos e os padrões para o restante: a fila e o armazenamento chave-valor no banco de dados, e o fluxo em tempo real dentro do processo. Os arquivos do Docker Compose emdeploy/dockeriniciam essa configuração em uma máquina (implantando com Docker Compose). Ela serve a um servidor pessoal ou pequeno.stream = hubalcança apenas o processo em que roda, então essa configuração fica em um processo. - Tire os dados de lá. PostgreSQL para o banco de dados, um bucket compatível com S3 ou o Google Cloud Storage para a mídia e uma CDN na frente da mídia. O servidor ainda é um processo, mas não depende mais de um disco, e os processos da etapa seguinte podem compartilhar os dados. Decida isso antes da primeira inicialização, se puder: mover os dados do SQLite e do sistema de arquivos depois é um trabalho à parte (o que incluir no backup lista o que precisa ser movido).
- Escale. Execute processos com
role = webpara as requisições erole = workerpara os jobs, quantos cada um precisar, e divida os workers por tipo de job (dividindo workers). Com mais de um processo, o fluxo em tempo real precisa de um broker que alcance todos os processos (postgres,valkey,snsoupubsub), e o armazenamento chave-valor deve ser compartilhado (dbouvalkey), já quememorymantém os limites de taxa e as respostas a escritas reenviadas de cada processo separados. A fila de jobs continua no PostgreSQL, ou passa para o Google Cloud Tasks (Cloud Tasks).
A implantação no Cloud Run é um exemplo de configuração entre a segunda e a terceira etapa:
role = all no Cloud Run, PostgreSQL no Neon, mídia no Cloud Storage, Cloud Tasks para os jobs e Pub/Sub para o
fluxo, sem nenhuma instância em execução enquanto ninguém usa o servidor.
Onde ir em seguida
Seção intitulada “Onde ir em seguida”Leia os guias do operador nesta ordem:
- Começar: rode o servidor ou implante no Cloud Run, e depois passe pelo checklist de produção antes de abri-lo para os usuários.
- Configurar a instância: suas configurações, o cadastro, os provedores de login externos, o e-mail, o CAPTCHA, o CDN, as pré-visualizações de links e mecanismos de busca e rastreadores de IA.
- Ativar recursos: a moderação, os relays, os webhooks, os plugins e os ganchos de decisão, o chat de voz, a busca de texto completo, os apoiadores e seus pagamentos, e a importação de custos de nuvem.
- Operar no dia a dia: o monitoramento, os alertas, os relatórios de erro, a manutenção, o backup, o banco de dados, a chave de cifragem de chaves e administradores e funções.
- Jurídico e encerramento: os modelos de política de privacidade e de registro de tratamento, e encerrando o serviço.
A referência de configuração lista cada configuração, e a referência de jobs lista cada job que os workers executam.
Para LLMs e agentes de programação:llms.txt,llms-full.txt, llms-small.txt