

Esta página é uma tradução automática da página em inglês, que é a versão de referência. Ler a página em inglês
Backup e restauração
O que incluir no backup, como fazer cada backup enquanto a instância continua em execução, como restaurar uma instância a partir deles e como ensaiar uma restauração antes de precisar de uma. As atualizações também fazem um backup; Atualização cobre os passos ao redor dele.
O que incluir no backup
Seção intitulada “O que incluir no backup”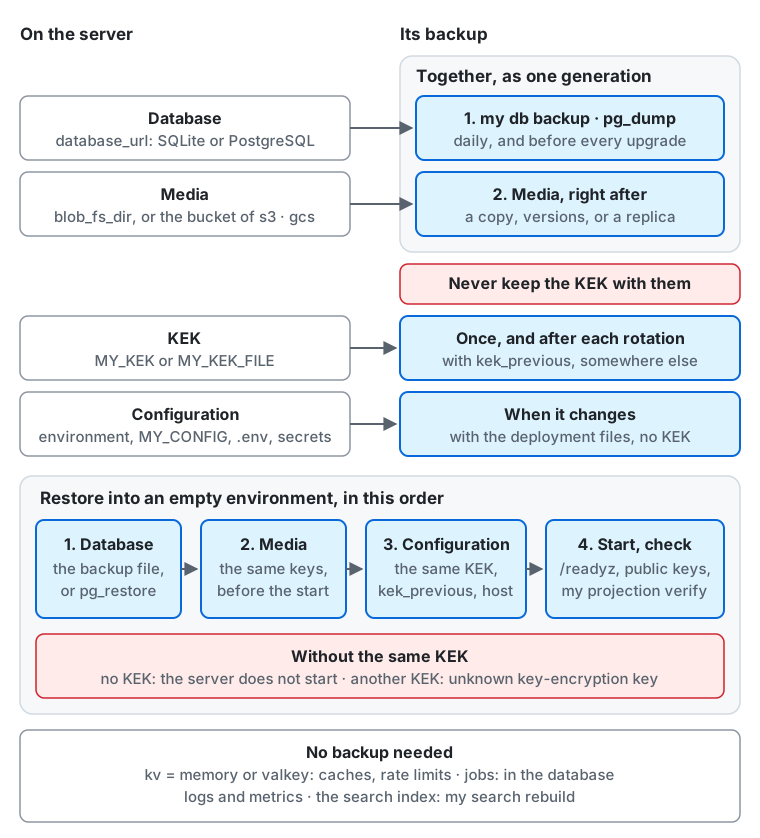
Do topo do diagrama para baixo:
- O banco de dados (
database_url: SQLite ou PostgreSQL) entra primeiro no backup, commy db backupoupg_dump, todos os dias e antes de cada atualização. - A mídia (
blob_fs_dir, ou o bucket do blob stores3ougcs) entra no backup logo depois, como uma cópia, as versões do bucket ou uma réplica. Os dois backups formam uma geração, mantidos juntos, longe do servidor e criptografados. - A KEK (
MY_KEKouMY_KEK_FILE) entra no backup uma vez e depois de cada rotação, comkek_previous, e nunca no mesmo lugar que os backups do banco de dados. Comkey_manager = gcpkmsouawskms, a KEK fica no KMS: mantenha a chave dekms_keyhabilitada enquanto você mantiver backups que dependam dela (Retirar uma chave do AWS KMS). - A configuração (o ambiente,
MY_CONFIG,.enve os segredos) é copiada junto com os arquivos de implantação quando muda, sem a KEK. - Uma restauração vai para um ambiente vazio, nesta ordem: o banco de dados, depois a mídia com as mesmas chaves antes de o servidor iniciar,
depois a configuração com a mesma KEK,
kek_previousehost; então o servidor inicia e você verifica/readyz,my projection verifye as chaves públicas dos atores (Restaurando). Sem a KEK, o servidor não inicia, e com outra KEK a leitura de um segredo falha comunknown key-encryption key(Sem a KEK correta). - Não é necessário backup do armazenamento chave-valor com
kv = memoryouvalkey(caches e limites de taxa), dos jobs (eles estão no banco de dados), dos logs e métricas, nem do índice de um mecanismo de busca, quemy search rebuildrecria.
| O quê | Onde fica | Backup | O que se perde sem backup |
|---|---|---|---|
| O banco de dados | o arquivo SQLite (database_url) ou o banco de dados PostgreSQL |
SQLite ou PostgreSQL | tudo: contas, publicações, seguidores, configurações |
| A mídia | o diretório blob_fs_dir do blob store fs, ou o bucket blob_s3_bucket do blob store s3 ou blob_gcs_bucket do blob store gcs |
Mídia ou Mídia em um bucket | as imagens, vídeos e arquivos de áudio enviados, e os arquivos remotos em cache |
| A KEK | onde quer que você guarde MY_KEK ou o arquivo de MY_KEK_FILE (secrets/kek com Compose; nunca no banco de dados) |
A KEK, separadamente do banco de dados | a chave privada de cada ator e, com ela, a identidade do ator no fediverso, além dos outros segredos que o banco de dados armazena |
| A configuração | as variáveis de ambiente, o arquivo de configuração (MY_CONFIG), os segredos (MY_VAPID_PRIVATE_KEY, chaves de e-mail e de pagamento), .env com Compose |
copie-os junto com seus arquivos de implantação | nada nos dados, mas a instância não consegue iniciar da mesma forma; alterar host quebra todas as URLs federadas |
O que não precisa de backup:
- O armazenamento chave-valor (
kv). Comkv = db, ele faz parte do banco de dados. Comkv = memoryoukv = valkey, ele guarda caches, contadores de limite de taxa e estados de curta duração, como um login aguardando o segundo fator. Depois de uma restauração com um Valkey vazio, os caches são preenchidos novamente, os limites de taxa recomeçam, e um login ou uma chamada de voz em andamento precisa recomeçar. - A fila de jobs (
queue). Comqueue = dbequeue = cloudtasks, os jobs fazem parte do banco de dados e voltam com ele. As tarefas do Cloud Tasks carregam apenas um sinal para um job do banco de dados; depois de uma restauração, o servidor sinaliza novamente os jobs vencidos em poucos minutos. - Logs e métricas, que o servidor não lê de volta.
- O índice de um mecanismo de busca, se você tiver um.
my search rebuildo recria a partir do banco de dados. Se você fizer snapshots do mecanismo, eles contêm o texto das publicações, inclusive das publicações excluídas depois do snapshot, então trate-os como backups do banco de dados (Busca de texto completo).
A chave VAPID do Web Push é um segredo da configuração. Uma nova chave interrompe as notificações push para todas as assinaturas existentes (Chave VAPID do Web Push), então guarde-a junto com a configuração.
Com que frequência e onde
Seção intitulada “Com que frequência e onde”- Banco de dados: pelo menos uma vez por dia e antes de cada atualização. Mantenha várias gerações, por exemplo 7 backups diários, 4 semanais e 3 mensais, para que um erro percebido tarde ainda possa ser desfeito. Um PostgreSQL gerenciado com recuperação para um ponto no tempo cobre os dias que a retenção dele mantém.
- Mídia: junto com o banco de dados, todas as vezes (veja A ordem do banco de dados e da mídia).
- KEK e configuração: quando mudam. Uma rotação de KEK é uma mudança: faça o backup da nova KEK antes de usá-la e mantenha a anterior
enquanto
kek_previousa listar. - Onde: longe do servidor e do disco dele, em outro domínio de falha (outra máquina, outra região, outro provedor ou conta). Um backup no próprio disco do servidor não sobrevive à perda desse disco.
- Criptografia: o backup do banco de dados contém endereços de e-mail, hashes de senha e mensagens diretas; criptografe-o em repouso
(um bucket criptografado, ou criptografe o arquivo com
ageougpgantes de enviar). Os segredos nele, como as chaves privadas dos atores, são criptografados com a KEK, então nunca guarde a KEK no mesmo lugar que os backups do banco de dados: quem obtiver os dois consegue ler todos os segredos. - Retenção: um backup mantém dados que os usuários excluíram ou que você apagou a pedido. Exclua gerações antigas em um cronograma que a sua política de privacidade declare.
Fazendo o backup
Seção intitulada “Fazendo o backup”O servidor pode continuar em execução durante um backup. Para fazer um que corresponda exatamente a um ponto no tempo, por exemplo antes de uma atualização,
ative antes o modo de manutenção: no modo de manutenção, my serve não abre nenhuma conexão com o banco de dados e não grava nada.
my db backup <file> grava uma cópia consistente do banco de dados SQLite em um novo arquivo enquanto o servidor continua em execução.
A cópia contém toda gravação confirmada antes de o comando começar, inclusive as que ainda estão no arquivo -wal, e nenhuma posterior.
É um único arquivo, menor que o original porque as páginas livres ficam de fora. O comando recusa um arquivo que já exista
e funciona apenas com database = sqlite.
my db backup /backup/my-$(date +%Y%m%d%H%M).dbCom Docker Compose, execute-o no contêiner do servidor. A cópia é gravada dentro do contêiner, então grave-a no volume de dados e mova-a para fora a partir dele:
cd deploy/dockerdocker compose exec -T my my db backup /data/backup.dbdocker run --rm -v my_data:/data -v "$PWD":/backup busybox sh -c 'mv /data/backup.db /backup/my-$(date +%Y%m%d%H%M).db'Não copie o arquivo do banco de dados com cp ou tar enquanto o servidor estiver em execução: o arquivo sozinho não tem as gravações ainda presentes no arquivo -wal,
e uma cópia feita no meio de uma gravação pode estar corrompida. Uma cópia simples é aceitável quando nenhum processo tem o banco de dados aberto
(o servidor parado ou em modo de manutenção); nesse caso, copie junto os arquivos -wal e -shm.
PostgreSQL
Seção intitulada “PostgreSQL”Use pg_dump no formato custom, que o pg_restore lê. Ele lê um único snapshot, então o servidor pode continuar em execução.
pg_dump --format=custom --file=my-$(date +%Y%m%d%H%M).dump "postgres://my:...@db.example/my"Com a camada Compose compose.postgres.yaml, execute-o no contêiner do banco de dados (indique a camada com -f ou em COMPOSE_FILE):
cd deploy/dockerdocker compose exec -T postgres pg_dump --format=custom -U my my > my-$(date +%Y%m%d%H%M).dumpUse o pg_dump da mesma versão principal do servidor ou de uma mais recente.
Um PostgreSQL gerenciado tem seus próprios backups, que são a melhor escolha para um banco de dados grande:
- Cloud SQL e Amazon RDS fazem backups diários automáticos e, com a recuperação para um ponto no tempo ativada, restauram para qualquer segundo dentro do período de retenção. Ative ambos, defina a retenção para cobrir as gerações que você quer e faça um backup sob demanda (um backup sob demanda do Cloud SQL, um snapshot do RDS) antes de cada atualização.
- A restauração deles cria uma nova instância (ou sobrescreve uma): depois, aponte
database_urlpara ela. - Esses backups ficam dentro da conta do provedor. Exporte também um
pg_dumpde tempos em tempos para algum lugar fora dela, para que perder a conta não signifique perder os dados.
O blob store fs guarda todos os arquivos em blob_fs_dir (/data/blobs com Compose): os envios em objects/ e os arquivos em gravação em tmp/.
Copie o diretório, exceto tmp/, com qualquer ferramenta que copie arquivos (tar, rsync, um snapshot do volume ou do disco).
Um arquivo é gravado em tmp/ e depois renomeado para objects/ em uma única etapa, então uma cópia feita com o servidor em execução nunca contém meio arquivo em objects/.
docker run --rm -v my_data:/data -v "$PWD":/backup busybox \ tar czf /backup/blobs-$(date +%Y%m%d%H%M).tar.gz -C /data --exclude=blobs/tmp blobsrsync para o host de backup mantém a cópia pequena depois da primeira vez, já que os arquivos de mídia nunca mudam depois de gravados.
Mídia em um bucket
Seção intitulada “Mídia em um bucket”Os blob stores s3 e gcs guardam cada arquivo como um objeto do bucket blob_s3_bucket ou blob_gcs_bucket, identificado por sua chave: a mídia processada em media/,
os envios como foram recebidos em uploads/ e os arquivos remotos em cache em remote/. O bucket permanece privado: o servidor lê os
arquivos e os serve em /media/. Um objeto só aparece depois de gravado por inteiro, então uma cópia feita com o servidor em execução nunca contém
meio arquivo. Proteja o bucket em três camadas, da mais barata à mais segura.
Versionamento. Ative o versionamento de objetos do bucket onde o serviço o oferecer (Amazon S3, Google Cloud Storage, MinIO e outros). Um objeto excluído ou sobrescrito permanece como uma versão não atual, e o bucket pode voltar ao momento de um backup do banco de dados.
aws s3api put-bucket-versioning --bucket my-media --versioning-configuration Status=EnabledCom os módulos OpenTofu do Amazon S3 e do Google Cloud Storage, defina versioning = true: isso ativa o versionamento e adiciona a regra das versões não atuais
abaixo, cuja idade é noncurrent_version_days (35 por padrão). O Cloudflare R2 não tem versionamento de objetos, e o módulo de outro armazenamento compatível com S3
não cria o bucket, então, nesses dois casos, use uma cópia (abaixo).
Regras de ciclo de vida. Com o versionamento, cada arquivo excluído mantém seu custo de armazenamento até que uma regra o remova. Adicione uma regra que exclua as versões não atuais depois da idade do seu backup de banco de dados mais antigo (35 dias para as gerações de Com que frequência e onde, sem as mensais), para que todo backup do banco de dados que você mantém ainda encontre seus arquivos e um arquivo que um usuário excluiu não permaneça por mais tempo do que a sua política de privacidade diz. Adicione uma regra que cancele os envios multipart incompletos após um dia: o servidor cancela por conta própria o envio malsucedido de um arquivo grande, mas um processo que para no meio de um deixa as partes para trás.
{ "Rules": [ { "ID": "noncurrent-versions", "Status": "Enabled", "Filter": {}, "NoncurrentVersionExpiration": { "NoncurrentDays": 35 }, "AbortIncompleteMultipartUpload": { "DaysAfterInitiation": 1 } } ]}aws s3api put-bucket-lifecycle-configuration --bucket my-media --lifecycle-configuration file://lifecycle.jsonUma cópia em outra conta ou região. O versionamento protege contra um erro, não contra a perda do bucket ou da conta que o possui, e as credenciais do próprio servidor podem excluir objetos. Mantenha uma cópia que essas credenciais não alcancem:
-
Replicação. O Amazon S3 replica um bucket versionado para um bucket em outra região ou outra conta (Cross-Region ou Same-Region Replication, com o destino pertencendo à outra conta). Ative o versionamento também no destino e não replique exclusões (deixe a replicação de marcadores de exclusão desativada), para que uma exclusão na instância não chegue à cópia. Outros serviços têm sua própria replicação, como os buckets dual-region do Cloud Storage e a replicação de buckets do MinIO.
-
Uma cópia agendada. Onde não há replicação, ou para copiar para outro provedor, copie o bucket no cronograma do backup do banco de dados, logo depois dele, com credenciais que só possam ler o bucket da instância e só gravar no bucket de backup:
Janela do terminal rclone copy --checksum source:my-media backup:my-media-backuprclone copyeaws s3 syncsem--deleteadicionam objetos novos e nunca removem um da cópia. Os arquivos nunca mudam depois de gravados, então, após a primeira execução, cada cópia transfere apenas os novos. Exclua objetos antigos da cópia no cronograma da sua política de retenção, ou ative o versionamento e uma regra de ciclo de vida lá também.
As credenciais ficam fora da cópia: o bucket não contém nenhum segredo, mas a configuração nomeia a chave em blob_s3_access_key_id
e blob_s3_secret_access_key, que pertencem à configuração. O blob store gcs não guarda nenhuma chave: ele usa a conta de serviço
da máquina ou do Cloud Run.
A ordem do banco de dados e da mídia
Seção intitulada “A ordem do banco de dados e da mídia”Faça o backup primeiro do banco de dados, depois da mídia, e mantenha os dois juntos como uma geração. Para um bucket, a cópia ou a replicação que roda depois do backup do banco de dados é o backup da mídia; com o versionamento, são as versões vigentes no momento do backup do banco de dados.
O banco de dados nomeia os arquivos de mídia que usa, e a cópia da mídia é feita um instante depois. Nesse instante:
- Novos envios podem chegar à cópia da mídia sem uma linha na cópia do banco de dados. São arquivos que nada usa; ocupam espaço e não causam dano.
- Um arquivo excluído depois do backup do banco de dados (a mídia de uma publicação excluída, um envio que nunca foi anexado) está na cópia do banco de dados, mas não na cópia da mídia.
Depois de uma restauração, esse arquivo responde
404, e a publicação que o exibia mostra uma imagem ausente.
A outra ordem é pior: todo arquivo enviado entre o backup da mídia e o backup do banco de dados estaria ausente depois de uma restauração, inclusive a mídia das publicações novas. Fazer ambos em modo de manutenção evita qualquer das duas lacunas.
Nos alvos OpenTofu
Seção intitulada “Nos alvos OpenTofu”Os módulos não mantêm nenhum backup próprio além do que o provedor oferece: o PostgreSQL gerenciado do Cloud SQL e do RDS tem backups automáticos com uma retenção que você define, enquanto um banco de dados com apenas o histórico do provedor (Neon) só pode voltar até onde esse histórico alcança. Agende o seguinte por conta própria, com credenciais que a instância não tem:
- O banco de dados, todos os dias. Execute
pg_dumpno PostgreSQL da instância a partir de uma máquina ou de um job agendado fora do provedor que hospeda o banco de dados (veja PostgreSQL), criptografe o dump e grave-o em um bucket de outra conta ou de outro provedor. Mantenha as gerações de Com que frequência e onde. O job precisa dadatabase_urle de nada mais; ele não pode ter a KEK. - A mídia, logo depois. Com
versioning = trueno módulo do bucket, as versões são a cópia durante os últimosnoncurrent_version_days; para o caso de perder a conta, execute tambémrclone copydo bucket da instância para um bucket em outro lugar, como em Mídia em um bucket, no cronograma do dump do banco de dados. - A KEK e a configuração não fazem parte do cronograma: faça o backup delas quando mudarem (A KEK e a configuração).
A KEK e a configuração
Seção intitulada “A KEK e a configuração”A KEK não está no banco de dados. Faça o backup dela uma vez, separadamente dos backups do banco de dados, como descreve Gerenciamento da chave de criptografia de chaves,
e de novo após cada rotação. Mantenha uma cópia da configuração (o ambiente, o arquivo de configuração, .env e os arquivos de segredos)
junto com seus arquivos de implantação, sem a KEK.
Restaurando
Seção intitulada “Restaurando”Um backup contém o host e o account_domain da sua instância. Inicie o banco de dados restaurado com os mesmos valores: com outros, o servidor se recusa a iniciar.
Restaure em um ambiente vazio (uma máquina nova, volumes novos ou um banco de dados novo), nesta ordem: o banco de dados, a mídia (o diretório ou o bucket),
depois a configuração com a mesma KEK (e o mesmo kek_previous) que estava em uso quando o backup foi feito. Em seguida, inicie o servidor normalmente.
Pare o servidor, coloque o arquivo de backup no lugar do arquivo do banco de dados e remova os antigos arquivos -wal e -shm, se restar algum.
Com Docker Compose, no volume my_data (um existente ou um novo em outra máquina):
cd deploy/dockerdocker compose down # keeps the volume; on a new machine, `docker compose up --no-start` creates itdocker run --rm -v my_data:/data -v "$PWD":/backup busybox sh -c ' rm -rf /data/my.db /data/my.db-wal /data/my.db-shm /data/blobs && cp /backup/my-202601010000.db /data/my.db && tar xzf /backup/blobs-202601010000.tar.gz -C /data && chown -R 65532:65532 /data'docker compose up -dA imagem do servidor é executada como o usuário 65532, que deve ser o dono dos arquivos do volume (o chown acima).
PostgreSQL
Seção intitulada “PostgreSQL”Restaure em um banco de dados novo e vazio, preparado como para uma nova instância, mas sem aplicar o esquema: o dump já o contém.
-
Crie a role e o banco de dados.
-
Restaure o dump. Como superusuário, as tabelas restauradas mantêm seu dono (a role precisa existir); como dono do banco de dados, adicione
--no-owner.Janela do terminal pg_restore --exit-on-error --dbname="postgres://postgres:...@db.example/my" my-202601010000.dump -
Com o backup próprio de um banco de dados gerenciado, restaure-o do jeito do provedor e aponte
database_urlpara a instância restaurada.
Com a camada Compose compose.postgres.yaml, inicie apenas o banco de dados, em um volume novo, e restaure nele. O contêiner já criou a role e o banco de dados:
cd deploy/dockerdocker compose up -d --wait postgresdocker compose exec -T postgres pg_restore --exit-on-error --no-owner -U my -d my < my-202601010000.dumpdocker compose up -dPara restaurar sobre um banco de dados existente (revertendo uma atualização), use pg_restore --clean --if-exists, como mostra Revertendo.
Extraia a cópia da mídia em blob_fs_dir antes de o servidor iniciar, pertencente ao usuário com o qual o servidor é executado.
Mídia em um bucket
Seção intitulada “Mídia em um bucket”Restaure os objetos em um bucket vazio antes de o servidor iniciar e então aponte blob_s3_bucket (e o endpoint, a região e as credenciais) ou blob_gcs_bucket para ele.
As chaves devem permanecer as mesmas: o banco de dados nomeia cada arquivo por sua chave.
-
A partir de uma cópia em outro bucket, copie de volta:
Janela do terminal rclone copy --checksum backup:my-media-backup target:my-media-restored -
A partir das versões do próprio bucket da instância, copie os objetos como estavam no momento do backup do banco de dados para um novo bucket. O
rclonelê as versões desse momento com--s3-version-at:Janela do terminal rclone copy --s3-version-at "2026-01-01 00:00:00" source:my-media target:my-media-restored -
A partir de uma réplica, aponte
blob_s3_bucketoublob_gcs_bucketpara a réplica, ou copie-a de volta para um bucket na conta original.
As credenciais do servidor precisam ler, gravar e excluir objetos do bucket restaurado (s3:GetObject, s3:PutObject, s3:DeleteObject
e s3:AbortMultipartUpload no Amazon S3; a role roles/storage.objectUser no bucket do Google Cloud Storage).
Iniciando e verificando
Seção intitulada “Iniciando e verificando”Inicie o servidor da forma habitual. Com Docker Compose, docker compose up -d executa antes my db upgrade -check, o esquema e my db upgrade;
em um backup da mesma versão, eles não mudam nada. Depois, verifique:
/readyzresponde200, e o servidor não registra nenhum errounknown key-encryption key.my projection verifynão relata diferenças (Verificando e recriando projeções).- Você consegue entrar, e as publicações mais recentes e a mídia delas aparecem.
- As chaves dos atores não mudaram: o
publicKey.publicKeyPemde um ator (curl -H 'Accept: application/activity+json' https://<host>/ap/actors/<id>) é o mesmo de antes da restauração. Outros servidores verificam as assinaturas da instância com essa chave, então uma chave inalterada significa que a federação continua de onde parou. - Uma publicação, um seguir ou um deixar de seguir chega a outro servidor (uma conta de teste em outra instância o vê).
As gravações feitas depois do backup são perdidas: publicações, seguidores e envios desde então desaparecem desta instância, enquanto outros servidores ainda podem ter as atividades que receberam. Isso não pode ser reparado daqui; restaure a partir do backup mais recente que você tiver.
Com um mecanismo de busca, execute my search rebuild após a restauração, sem --keep, para que as publicações mais novas que o backup saiam do índice (Busca de texto completo).
Sem a KEK correta
Seção intitulada “Sem a KEK correta”- Sem KEK: o servidor não inicia.
my servee os outros comandosmyque leem a configuração param nesse ponto comThe required setting MY_KEK is not set.ekek: required when key_manager is local. - Outra KEK: o servidor inicia e responde
/readyz, mas tudo que lê um segredo criptografado com a KEK antiga falha comunknown key-encryption keye o ID da chave da KEK antiga (local key manager: key "local:…" is not configured): entregas a outros servidores e buscas assinadas (as chaves privadas dos atores), logins com autenticação de dois fatores, assinaturas de webhook e os provedores de login externos. As URLs do proxy de mídia emitidas antes também deixam de funcionar. Senhas e publicações não são criptografadas com a KEK, então o login com senha e a leitura de publicações continuam funcionando, o que pode esconder o problema no início: fique de olho no log para ver o erro. - Encontre a KEK cujo ID de chave o erro nomeia, defina-a como
kek(ou emkek_previous) e reinicie. Não há como recuperar um segredo sem a sua KEK; se a KEK for perdida de vez, as chaves dos atores precisam ser geradas novamente, e outros servidores veem cada ator como uma nova chave para a mesma conta.
Simulação de recuperação
Seção intitulada “Simulação de recuperação”Só se sabe que um backup funciona depois de restaurá-lo. Ensaie uma restauração antes de a instância se tornar pública e de novo após uma mudança na forma como os backups são feitos (pelo menos a cada poucos meses):
-
Faça um backup da instância em produção como acima: o banco de dados, depois a mídia.
-
Em outra máquina ou em outro projeto Compose, restaure-o com a KEK e a configuração de onde você as guarda (não copiadas do servidor em produção) e com
hostinalterado, para que as URLs dos atores coincidam. -
Não deixe a cópia federar. Defina
role = web, que não executa nenhum worker de jobs: os jobs restaurados com o banco de dados incluem entregas que estavam pendentes quando o backup foi feito, e uma cópia que as executa as assina com as chaves dos atores reais e as envia de novo a outros servidores. Manter a cópia fora da internet não basta, pois é difícil garanti-lo. Ative o modo de manutenção assim que as verificações abaixo passarem, se você a mantiver em execução. -
Fora do Compose, por exemplo em uma máquina local apontando para uma instância na nuvem, dê à cópia estas configurações para que ela não toque em nada da instância em produção:
Configuração Valor na cópia Por quê rolewebNão executa nenhum job, então nada do que foi restaurado é entregue de novo queuedbOs jobs enfileirados na cópia ficam no banco de dados dela em vez de chegar à fila em produção streampostgresNão entra no stream de eventos em produção da instância mailnoneNão envia e-mails a usuários reais o blob store um bucket (ou diretório) novo com a mídia restaurada Deixa o bucket em produção intocado database_urlo banco de dados restaurado Nunca o de produção a KEK ( MY_KEK, oukey_managerekms_key)como em produção, de onde você a guarda Sem ela a cópia não inicia hostcomo em produção Para que as URLs dos atores coincidam -
Percorra Iniciando e verificando: entrar, publicações e mídia, e o
publicKeyde alguns atores comparado com o da instância em produção. -
Inicie-a uma vez sem a KEK e outra com uma diferente, e verifique se ela falha como Sem a KEK correta descreve.
-
Anote quanto tempo cada etapa levou: é por esse tempo que uma restauração real mantém a instância fora do ar.
Para LLMs e agentes de programação:llms.txt,llms-full.txt, llms-small.txt