

Esta página es una traducción automática de la página en inglés, que es la versión de referencia. Leer la página en inglés
Visión general de un servidor de mycroblog
La primera página que conviene leer antes de poner en marcha un servidor. mycroblog es un microblog que federa con el
resto del fediverso mediante ActivityPub; my es su software de servidor, un único binario que contiene el servidor, el
procesador de trabajos, el cliente web y los comandos que se ocupan de ellos. Esta página muestra de qué se compone un
servidor, qué eliges mediante la configuración, cómo un servidor pequeño crece hasta uno grande y qué leer a
continuación.
De qué se compone un servidor
Sección titulada «De qué se compone un servidor»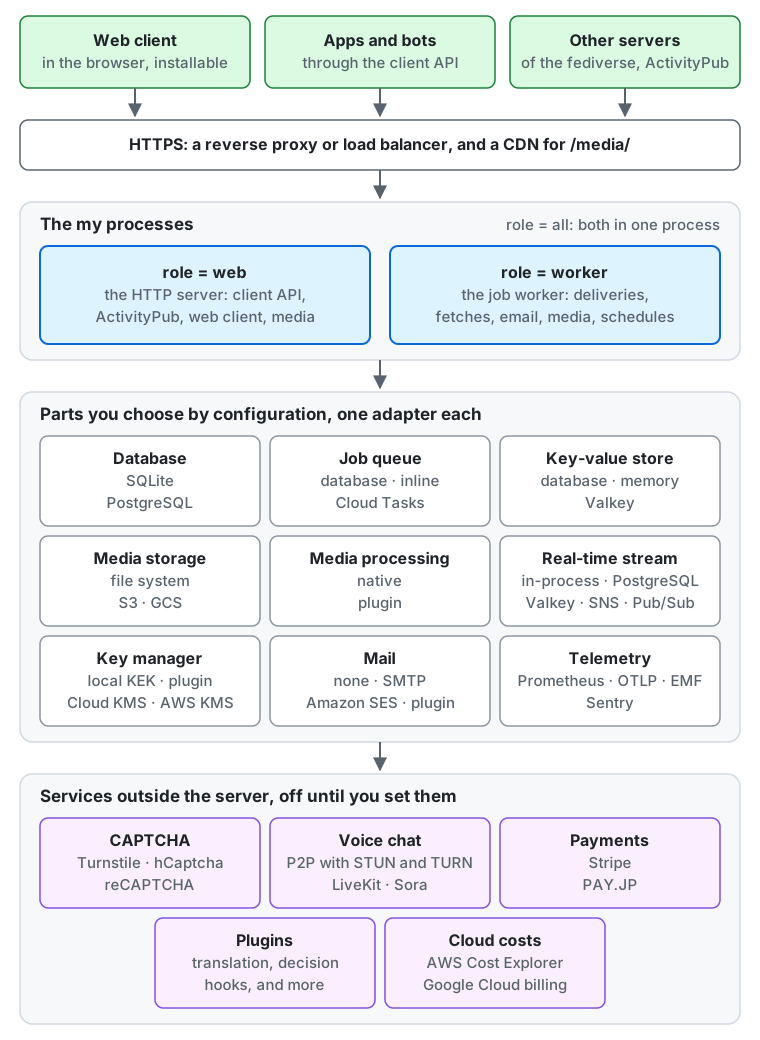
De arriba abajo en el diagrama:
- Quién se conecta. Las personas usan el cliente web en su navegador (puede instalarse como aplicación), las aplicaciones y los bots usan la API de cliente, y otros servidores del fediverso entregan y obtienen publicaciones por ActivityPub. Todos llegan al servidor por HTTPS.
- Delante del servidor. Por defecto
myhabla HTTP sin cifrar, así que un proxy inverso o un balanceador de carga termina HTTPS delante de él. En una sola máquina,mypuede servir HTTPS por sí mismo en su lugar (servir HTTPS desde el servidor). Una CDN delante de los archivos multimedia es opcional. - Los procesos
my. Cada proceso ejecutamy serve, y suroledice lo que ejecuta:webel servidor HTTP,workerel worker de jobs, que entrega publicaciones, obtiene de otros servidores, envía correo, procesa multimedia y ejecuta los jobs periódicos, yall, el valor predeterminado, ambos en un solo proceso. - Las partes que eliges. Cada parte en el centro del diagrama tiene un ajuste que elige su adaptador, enumerado en la sección siguiente.
- Servicios externos al servidor. El CAPTCHA, el chat de voz, los pagos, los plugins y la importación de costes de la nube permanecen desactivados hasta que los configuras, y el servidor llama entonces al servicio que nombras.
Partes que eliges por configuración
Sección titulada «Partes que eliges por configuración»Cada parte es un ajuste de la referencia de configuración, definido en un archivo TOML o como
variable de entorno (MY_ y la clave en mayúsculas, como MY_DATABASE). La primera opción de cada lista es el valor predeterminado.
Donde una parte guarda datos, elígela antes del primer arranque: los datos no se mueven solos cuando cambia el ajuste.
| Parte | Ajuste | Opciones | Sigue leyendo |
|---|---|---|---|
| Base de datos | database |
sqlite (un archivo), postgres (PostgreSQL y servicios compatibles) |
Base de datos, copia de seguridad |
| Cola de jobs | queue |
db (una tabla en la base de datos), inline (ejecuta cada job de inmediato en el mismo proceso, para pruebas y desarrollo), cloudtasks (Google Cloud Tasks despierta al servidor para cada job; necesita PostgreSQL) |
La cola de jobs |
| Almacén clave-valor, para cachés, límites de tasa y las respuestas guardadas durante un día para escrituras reenviadas | kv |
db (una tabla en la base de datos), memory (cada proceso por su cuenta), valkey (Valkey u otro servidor con protocolo Redis, compartido por todos los procesos) |
kv |
| Almacenamiento de multimedia | blob |
fs (un directorio), s3 (Amazon S3, Cloudflare R2, MinIO, Garage y otros almacenes compatibles con S3), gcs (Google Cloud Storage) |
Archivos de Docker Compose, copia de seguridad de la multimedia |
| Procesamiento de multimedia | media_image, media_video, media_audio, uno para cada tipo de archivo |
native (en el servidor), plugin (un plugin tuyo convierte los archivos de ese tipo) |
Convertir multimedia |
| Stream en tiempo real entre procesos | stream |
hub (dentro de un proceso), postgres (LISTEN / NOTIFY), valkey, sns (Amazon SNS y SQS), pubsub (Google Cloud Pub/Sub) |
stream |
| Gestor de claves, que cifra las claves privadas de las cuentas | key_manager |
local (una clave de cifrado de claves que guardas tú), gcpkms (Google Cloud KMS), awskms (AWS KMS), plugin |
Gestionar la clave |
| Correo | mail |
none, smtp, ses (Amazon SES), plugin |
Enviar correo |
| CAPTCHA | captcha |
none, turnstile (Cloudflare Turnstile), hcaptcha, recaptcha (Google reCAPTCHA v2) |
CAPTCHA |
| Chat de voz | voice |
off, p2p (de navegador a navegador, con TURN de voice_turn: none, coturn o cloudflare), livekit, sora |
Chat de voz |
| Pagos de mecenas | payments |
none, stripe, payjp (PAY.JP) |
Mecenas, Stripe, PAY.JP |
| Plugins | plugin_<kind>_address |
ninguno por defecto; una dirección para cada tipo: translator, search, billing, mailer, media_image, media_video, media_audio, key_manager y los hooks de decisión inbound.status, local.status, inbound.follow, signup.check, media.check, inbound.actor, local.profile |
Plugins, hooks de decisión |
| Traducción de publicaciones | translator_<provider>_*, plugin_translator_address |
ninguno (solo la traducción del propio navegador); libretranslate, deepl, google (Google Cloud Translation), aws (Amazon Translate) o un plugin tuyo delante del servicio que elijas |
Traducir publicaciones, un plugin traductor |
| Búsqueda de texto completo de publicaciones | search |
none; o elasticsearch, opensearch o meilisearch (motores de búsqueda); o plugin, un plugin tuyo delante de otro motor |
Búsqueda de texto completo, un plugin de búsqueda |
| CDN para multimedia | media_origin |
sin definir (el servidor sirve la multimedia desde su propio origen), o el origen de tu CDN | Servir multimedia mediante una CDN |
| Costes de la nube | billing_sources |
ninguno, o cualquiera de aws (AWS Cost Explorer), gcp (la exportación de facturación o el presupuesto de Google Cloud), cloudflare (los cargos de uso de Cloudflare), plugin |
Importar los costes de la nube |
| Métricas | metrics_exporter |
none, prometheus, otlp (OpenTelemetry), emf (CloudWatch) |
Métricas, alertas |
| Trazas | traces_exporter |
none, otlp |
Trazas |
| Informes de errores | errors_exporter |
none (solo la línea de registro y los grupos de errores), sentry (Sentry, GlitchTip, Datadog), otlp |
Informe de errores |
El binario publicado y la imagen de contenedor contienen todos los adaptadores de la tabla.
my config check informa de todos los problemas de la configuración a la vez, antes de que inicies el servidor
(lista de comprobación de producción).
De un servidor pequeño a uno grande
Sección titulada «De un servidor pequeño a uno grande»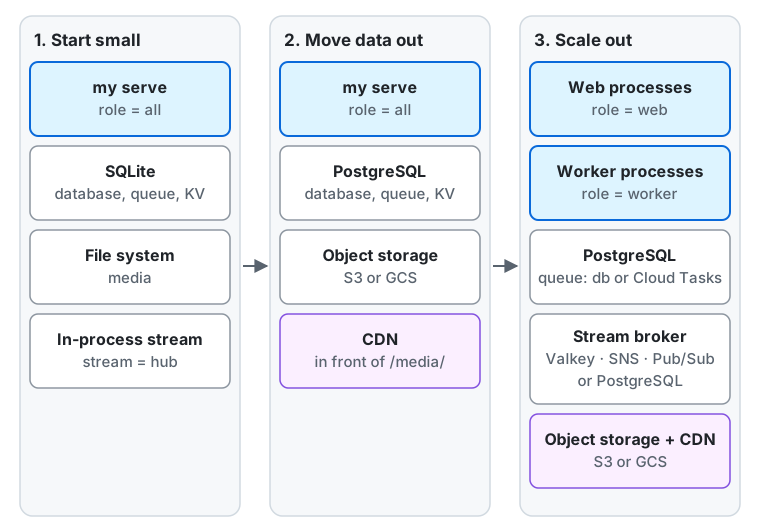
- Empieza pequeño. Un proceso con
role = all, con SQLite, con la multimedia en el sistema de archivos y los valores predeterminados para el resto: la cola y el almacén clave-valor en la base de datos, y el stream en tiempo real dentro del proceso. Los archivos de Docker Compose dedeploy/dockerinician esta configuración en una máquina (desplegar con Docker Compose). Sirve para un servidor personal o pequeño.stream = hubllega solo al proceso en el que se ejecuta, así que esta configuración se queda en un proceso. - Saca los datos. PostgreSQL para la base de datos, un bucket compatible con S3 o Google Cloud Storage para la multimedia, y una CDN delante de la multimedia. El servidor sigue siendo un proceso, pero ya no depende de un disco, y los procesos del paso siguiente pueden compartir los datos. Decide esto antes del primer arranque si puedes: mover los datos desde SQLite y el sistema de archivos después es un trabajo aparte (qué copiar enumera lo que hay que mover).
- Escala horizontalmente. Ejecuta procesos con
role = webpara las solicitudes yrole = workerpara los jobs, tantos como necesite cada uno, y divide los workers por tipo de job (dividir los workers). Con más de un proceso, el stream en tiempo real necesita un broker que llegue a todos los procesos (postgres,valkey,snsopubsub), y el almacén clave-valor debería compartirse (dbovalkey), ya quememorymantiene separados los límites de tasa y las respuestas a escrituras reenviadas de cada proceso. La cola de jobs permanece en PostgreSQL, o pasa a Google Cloud Tasks (Cloud Tasks).
El despliegue en Cloud Run es un ejemplo de una configuración entre el segundo y el tercer paso:
role = all en Cloud Run, PostgreSQL en Neon, multimedia en Cloud Storage, Cloud Tasks para los jobs y Pub/Sub para el
stream, sin ninguna instancia en ejecución mientras nadie usa el servidor.
A dónde ir a continuación
Sección titulada «A dónde ir a continuación»Lee las guías para operadores en este orden:
- Primeros pasos: ejecuta el servidor o despliégalo en Cloud Run, y repasa después la lista de comprobación para producción antes de abrirlo a los usuarios.
- Configura la instancia: sus configuraciones, el registro, los proveedores de inicio de sesión externos, el correo electrónico, CAPTCHA, la CDN, las vistas previas de enlaces y los motores de búsqueda y rastreadores de IA.
- Activa funciones: la moderación, los relés, los webhooks, los complementos y los ganchos de decisión, el chat de voz, la búsqueda de texto completo, los mecenas y sus pagos, y la importación de costos de la nube.
- Mantenlo en el día a día: la monitorización, las alertas, los informes de errores, el mantenimiento, la copia de seguridad, la base de datos, la clave de cifrado de claves y los administradores y roles.
- Aspectos legales y cierre: las plantillas de política de privacidad y de registro de tratamiento, y cerrar el servicio.
La referencia de configuración enumera todos las configuraciones, y la referencia de trabajos todos los trabajos que ejecutan los procesos de trabajo.
Para LLM y agentes de programación:llms.txt,llms-full.txt, llms-small.txt