

Esta página es una traducción automática de la página en inglés, que es la versión de referencia. Leer la página en inglés
Mantenimiento
Cómo poner el servidor fuera de servicio para trabajar en la base de datos, el KV o la cola, y qué mostrar mientras está caído.
Hay dos herramientas:
- El modo de mantenimiento (
maintenance = true,MY_MAINTENANCE=trueomy serve -maintenance).my servearranca sin abrir ningún adaptador y responde a cada solicitud con un503, unRetry-Aftery una respuesta que entiende cada cliente. Úsalo siempre quemy servepueda ejecutarse. - La página exportada (
my maintenance export). HTML estático de la misma plantilla, para que la sirva un balanceador de carga, una CDN o un proxy inverso cuandomy serveno puede ejecutarse en absoluto (una imagen que se está reemplazando, una revisión que no arranca). Consulta Exportar la página de mantenimiento.
Qué responde el modo de mantenimiento
Sección titulada «Qué responde el modo de mantenimiento»El proceso lee solo la dirección de escucha, host, account_domain, web_origin, los proxies (trusted_proxies, trusted_proxy_header),
la comprobación de origen (origin_secret, origin_secret_previous, origin_secret_header), status_page_url y los ajustes maintenance_* (referencia de configuración).
Los ajustes de la base de datos, la cola, el almacén de blobs, el KV, el correo y el stream no se leen ni se comprueban, así que pueden ser incorrectos o inaccesibles mientras tanto.
Sea cual sea el role, sirve solo HTTP: sin jobs, sin jobs periódicos, sin broker de streams. También sirve HTTP sin cifrar diga lo que diga tls,
en listen o en su valor predeterminado :8080 (servir HTTPS desde el servidor).
my config check -maintenance comprueba exactamente lo que lee el modo de mantenimiento.
Con origin_secret definido, una solicitud que necesita la cabecera y no la tiene recibe el 403 de esa comprobación en lugar de lo de la tabla de abajo.
| Solicitud | Estado | Cuerpo |
|---|---|---|
GET /healthz, GET /readyz, GET /health/live, GET /health/ready |
200 |
{"status":"maintenance"} |
GET /api/v1/instance/health |
503 |
{"status":"maintenance"} |
El resto de la API de cliente (/api/*) y los endpoints OAuth que responden JSON |
503 |
application/problem+json del tipo /api/v1/problems/maintenance, con message, until y status_page_url cuando están definidos |
ActivityPub (por ruta, Accept o Content-Type), WebFinger, host-meta, NodeInfo, los webhooks de pago, las llamadas de Cloud Tasks y Cloud Scheduler (/_internal/*) |
503 |
{"error":"maintenance"} |
| Cualquier otra cosa (páginas, el cliente web, sus recursos, envíos de formularios) | 503 |
La página de mantenimiento, o el problema cuando Accept pide JSON |
Toda respuesta tiene Retry-After y Cache-Control: no-store. Retry-After cuenta los segundos hasta maintenance_until mientras está por delante
(como máximo 86 400), y es maintenance_retry_after (una duración de Go, 10m por defecto) en otro caso.
La página y el problema muestran:
| Ajuste | Se muestra como |
|---|---|
maintenance_server_name |
El nombre del servidor. El nombre de host cuando no está definido (el nombre propio de la instancia está en la base de datos) |
maintenance_message |
Un aviso en texto plano, de como máximo 2000 caracteres, igual en todos los idiomas |
maintenance_until |
Cuándo se espera que termine el trabajo (RFC 3339). La página lo muestra en UTC; el cliente web en la zona horaria del usuario |
status_page_url |
Un enlace a la página de estado (Monitorización) |
Los ajustes maintenance_* pueden quedar definidos durante el funcionamiento normal: solo se usan mientras maintenance es true.
Las palabras de la página siguen Accept-Language (inglés en otro caso).
El cliente web muestra un aviso de mantenimiento a pantalla completa cuando la API responde con el problema de mantenimiento,
mantiene la sesión del usuario iniciada y reintenta tras Retry-After.
Cuánto tiempo
Sección titulada «Cuánto tiempo»Mantén un mantenimiento en unas pocas horas. Otros servidores reintentan sus entregas ante un 503, pero ninguno lee Retry-After,
y cuando se agotan sus reintentos las actividades enviadas entretanto se pierden para este servidor.
La ventana de reintentos más corta entre las principales implementaciones es de aproximadamente un día (Akkoma, cerca de 1 día; Misskey, cerca de 1,5 días; Mastodon, cerca de 2 a 3 días; Pleroma, cerca de 7 días,
según sus calendarios de reintentos).
Los motores de búsqueda tratan un 503 breve como una interrupción temporal, pero Google desaconseja servir 503 para robots.txt durante más de un día o dos.
Una parada de más de un día o dos no es un mantenimiento: cierra el servicio (Cerrar el servicio).
- Anúncialo. Publica la ventana en la página de estado (
status_page_url) y como anuncio (Administración → Anuncios) con algo de antelación. Definemaintenance_messageymaintenance_untilen la configuración del despliegue, y actualiza las páginas exportadas (my maintenance export) si el front end las sirve. - Detén la cola push (Cloud Tasks): consulta más abajo. De lo contrario, cada entrega durante la ventana
es un
503que consume uno de los intentos de la tarea. - Cambia al modo de mantenimiento: vuelve a desplegar con
MY_MAINTENANCE=true(según el destino, más abajo). Cada réplica se reinicia en el modo de mantenimiento; el balanceador de carga las conserva porque/readyzresponde200. - Haz el trabajo.
- Vuelve atrás: vuelve a desplegar sin
MY_MAINTENANCE(o confalse), comprueba que/health/readyy/api/v1/instance/healthresponden{"status":"ok"}, y después reanuda la cola push y cierra el anuncio.
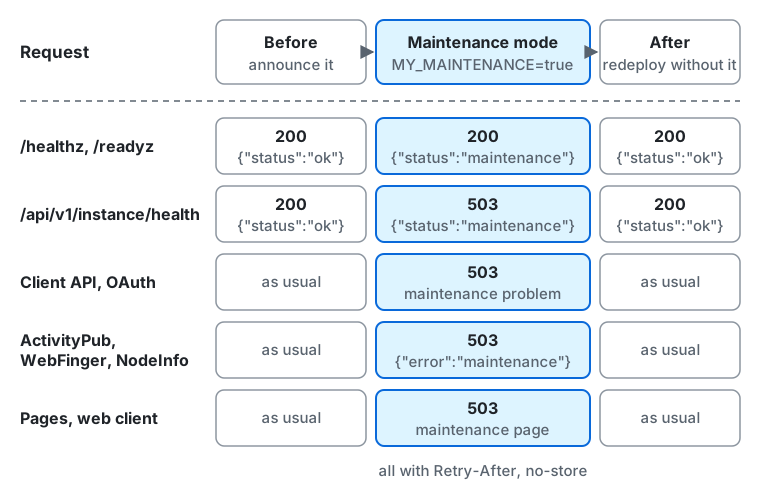
De izquierda a derecha:
- Antes, mientras anuncias el mantenimiento, cada solicitud se responde como de costumbre:
/healthz,/readyzy/api/v1/instance/healthresponden200con{"status":"ok"}. - En el modo de mantenimiento (
MY_MAINTENANCE=true):/healthz,/readyz,/health/livey/health/readyresponden200con{"status":"maintenance"}./api/v1/instance/healthresponde503con{"status":"maintenance"}.- El resto de la API de cliente y los endpoints de OAuth que responden JSON reciben
503con el problema de mantenimiento. - ActivityPub, WebFinger y NodeInfo responden
503con{"error":"maintenance"}. - Las páginas y el cliente web reciben
503con la página de mantenimiento. - Cada respuesta lleva
Retry-AfteryCache-Control: no-store.
- Después de volver a desplegar sin
MY_MAINTENANCE, cada solicitud se responde de nuevo como de costumbre.
Colas push
Sección titulada «Colas push»-
Cloud Tasks: pausa la cola, que sigue aceptando tareas nuevas pero deja de entregarlas, y reanúdala después del trabajo. Cuántos intentos tiene una tarea lo define
retryConfig.maxAttemptsde la cola.Ventana de terminal gcloud tasks queues pause my-jobs --location=asia-northeast1gcloud tasks queues resume my-jobs --location=asia-northeast1Pausa también el trabajo de Cloud Scheduler de
/_internal/tick(gcloud scheduler jobs pause/resume), o deja que sus llamadas fallen con503mientras tanto. Los trabajos en sí están en la base de datos: una tarea que agotó sus intentos pierde solo su señal, y el primer tick tras el trabajo señala de nuevo todos los trabajos pendientes.
Según el destino
Sección titulada «Según el destino»Las páginas de error de los front ends que siguen responden a los errores del servidor con la página exportada. Haz coincidir solo los errores de un servidor que no se está ejecutando
(502 y 504, y el 503 propio del balanceador de carga donde no hay ningún backend sano), o activa la regla solo mientras my serve no pueda ejecutarse:
una regla sobre cada 503 también reemplazaría las respuestas propias del modo de mantenimiento, como el problema que leen la API de cliente y el cliente web.
Cloud Run
Sección titulada «Cloud Run»Despliega una revisión nueva con la variable, y quítala después:
gcloud run services update my --region=asia-northeast1 \ --update-env-vars=MY_MAINTENANCE=true,MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Zgcloud run services update my --region=asia-northeast1 --remove-env-vars=MY_MAINTENANCE,MY_MAINTENANCE_UNTILCon el módulo de OpenTofu, defínelo en su lugar en el bloque, como settings = { maintenance = "true" }, y aplica, ya que el siguiente apply restablece
lo que dice el bloque: Desplegar en Cloud Run lo explica en torno a una actualización.
Cuando Cloud Run está expuesto directamente, sin balanceador de carga, no hay nada delante de él, así que el modo de mantenimiento es la única herramienta.
Cuando my serve no puede ejecutarse detrás de un Application Load Balancer externo global: sube el index.html exportado a un bucket de Cloud Storage
añadido como backend bucket, y añade una política de respuesta de error personalizada que responda con él a los 502 y 504 del backend y con overrideResponseCode: 503.
Solo el Application Load Balancer externo global tiene respuestas de error personalizadas (no los regionales ni los clásicos), y la política se aplica solo
a las respuestas del backend, no a las que Google Front End genera por sí mismo. Esta ruta no puede enviar Retry-After: las cabeceras personalizadas de la fuente del error no se añaden.
# Part of the URL map (gcloud compute url-maps import).defaultCustomErrorResponsePolicy: errorService: https://www.googleapis.com/compute/v1/projects/<project>/global/backendBuckets/my-maintenance errorResponseRules: - matchResponseCodes: ["502", "504"] path: /index.html overrideResponseCode: 503AWS ECS
Sección titulada «AWS ECS»Registra una revisión de la definición de tarea del servicio con MY_MAINTENANCE=true en el entorno del contenedor, actualiza el servicio a ella
y haz lo mismo sin la variable después. Con el módulo de OpenTofu, defínelo en su lugar en el bloque, como settings = { maintenance = "true" },
y aplica, ya que el siguiente apply restablece lo que dice el bloque: en torno a una actualización, aplica el modo, luego la versión nueva y luego el bloque sin él,
como hace Desplegar en Cloud Run.
Cuando my serve no puede ejecutarse detrás de CloudFront: sube el index.html exportado a un bucket de S3 que sea un segundo origen
(la página de error no puede venir del origen que falla), y añade respuestas de error personalizadas para 502 y 504 (y 503 solo mientras my serve no puede ejecutarse)
con ResponsePagePath: /maintenance/index.html y ResponseCode: 503.
CloudFront puede añadir Retry-After mediante una política de cabeceras de respuesta con una cabecera personalizada, pero la política se aplica a todas las respuestas del comportamiento de caché,
así que adjúntala solo para el mantenimiento y sepárala después.
La respuesta fija de un Application Load Balancer no puede llevar la página exportada: su cuerpo tiene como máximo 1024 caracteres y no define cabeceras como Retry-After.
Úsala solo para un texto breve y el estado:
{ "Type": "fixed-response", "FixedResponseConfig": { "StatusCode": "503", "ContentType": "text/plain", "MessageBody": "This server is under maintenance. Please try again later. / メンテナンス中です。しばらくしてからお試しください。" }}Sin Retry-After, otros servidores reintentan según su propio calendario, que la ventana de arriba ya contempla.
Docker Compose
Sección titulada «Docker Compose»deploy/docker/compose.yaml pasa las configuraciones de .env al servidor, y toma también MY_MAINTENANCE, MY_MAINTENANCE_MESSAGE y MY_MAINTENANCE_UNTIL del shell.
Defínelos y recrea el servicio my; después quita MY_MAINTENANCE y recréalo de nuevo tras el trabajo.
--no-deps evita que se ejecuten los servicios de base de datos de una sola vez (upgrade-check, schema, upgrade); una actualización sí los ejecuta (Actualizar):
MY_MAINTENANCE=true MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Z docker compose up -d --no-deps --force-recreate mydocker compose up -d --no-deps --force-recreate myCuando my serve no puede ejecutarse detrás de nginx: sirve las páginas exportadas desde un directorio, elige una según Accept-Language,
y responde con ella, como un 503, a los propios 502 y 504 de nginx (el servidor está caído o no responde).
Los 503 propios del modo de mantenimiento pasan sin cambios, ya que proxy_intercept_errors sigue desactivado.
map $http_accept_language $maintenance_page {    default  en.html;    ~*^ja    ja.html;}
server {    # ...    location / {        proxy_pass http://my:8080;        error_page 502 504 =503 /maintenance/$maintenance_page;    }    location /maintenance/ {        internal;        alias /srv/maintenance/;   # the -out directory of my maintenance export        add_header Retry-After 600 always;        add_header Cache-Control no-store always;    }}
microk8s (Kubernetes)
Sección titulada «microk8s (Kubernetes)»Define la variable en el Deployment, lo que despliega los pods de nuevo, y quítala después:
microk8s kubectl set env deployment/my MY_MAINTENANCE=true MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Zmicrok8s kubectl rollout status deployment/mymicrok8s kubectl set env deployment/my MY_MAINTENANCE- MY_MAINTENANCE_UNTIL-La sonda de disponibilidad en /readyz sigue pasando en el modo de mantenimiento, así que el despliegue se completa y el Service sigue dirigiendo el tráfico a los pods.
Cuando my serve no puede ejecutarse detrás del NGINX Ingress Controller (el complemento ingress de microk8s): sirve las páginas exportadas desde un pequeño
Deployment de nginx (por ejemplo desde un ConfigMap con index.html, en.html y ja.html) y conviértelo en el backend predeterminado personalizado,
de modo que el controlador responda desde él a los 502 y 504 del servidor (añade 503 solo mientras my serve no pueda ejecutarse):
metadata: annotations: nginx.ingress.kubernetes.io/custom-http-errors: "502,504" nginx.ingress.kubernetes.io/default-backend: my-maintenance # a Service in the same namespaceMonitorización durante el mantenimiento
Sección titulada «Monitorización durante el mantenimiento»/healthz,/readyz,/health/livey/health/readysiguen en200con{"status":"maintenance"}: los balanceadores de carga y Kubernetes conservan las instancias./api/v1/instance/healthresponde503con{"status":"maintenance"}(Monitorización). Los monitores de disponibilidad ven el servidor como caído a menos que comprueben el cuerpo o tengan una ventana de mantenimiento; páusalos o define la ventana.
Para LLM y agentes de programación:llms.txt,llms-full.txt, llms-small.txt