

Esta página es una traducción automática de la página en inglés, que es la versión de referencia. Leer la página en inglés
Copia de seguridad y restauración
Qué copiar, cómo hacer cada copia mientras la instancia sigue funcionando, cómo restaurar una instancia a partir de ellas y cómo ensayar una restauración antes de necesitarla. Las actualizaciones también hacen una copia; Actualizar explica los pasos que la rodean.
Qué copiar
Sección titulada «Qué copiar»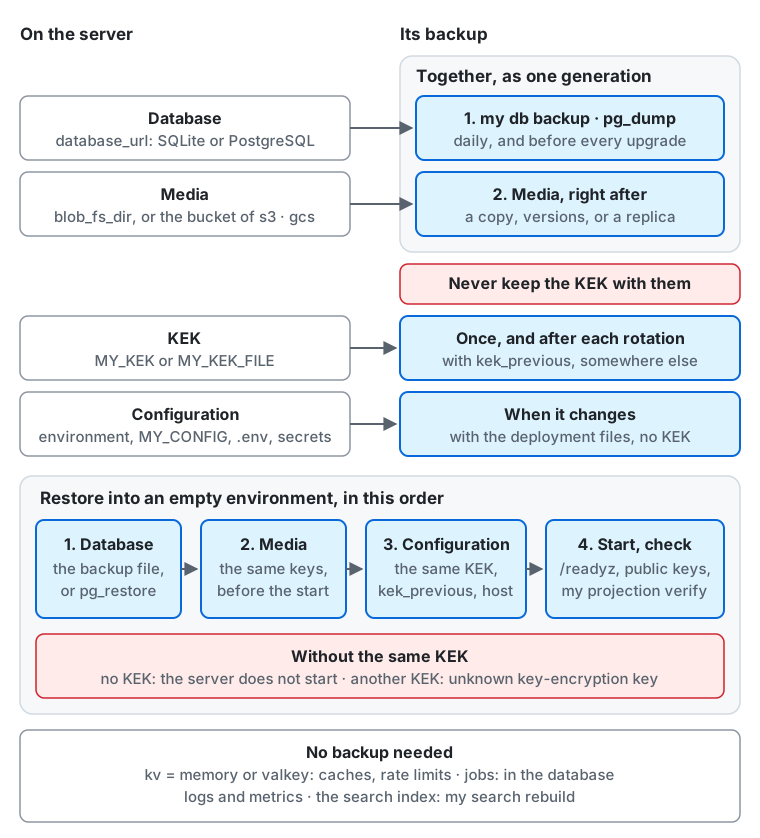
De arriba abajo en el diagrama:
- La base de datos (
database_url: SQLite o PostgreSQL) se copia primero, conmy db backupopg_dump, cada día y antes de cada actualización. - Los archivos multimedia (
blob_fs_dir, o el bucket del almacén de blobss3ogcs) se copian justo después, como una copia, las versiones del bucket o una réplica. Las dos copias son una misma generación, se guardan juntas, lejos del servidor y cifradas. - La KEK (
MY_KEKoMY_KEK_FILE) se copia una vez y después de cada rotación, conkek_previous, y nunca en el mismo lugar que las copias de la base de datos. Conkey_manager = gcpkmsoawskmsla KEK permanece en el KMS: mantén habilitada la clave dekms_keymientras conserves copias que la necesiten (Retirar una clave de AWS KMS). - La configuración (el entorno,
MY_CONFIG,.envy los secretos) se copia con los archivos de despliegue cuando cambia, sin la KEK. - Una restauración se hace en un entorno vacío, en este orden: la base de datos, después los archivos multimedia con las mismas claves antes de que arranque el servidor,
después la configuración con la misma KEK,
kek_previousyhost; entonces arranca el servidor y compruebas/readyz,my projection verifyy las claves públicas de los actores (Restaurar). Sin la KEK el servidor no arranca, y con otra distinta la lectura de un secreto falla conunknown key-encryption key(Sin la KEK correcta). - No hace falta copia del almacén de clave-valor con
kv = memoryovalkey(cachés y límites de frecuencia), de los trabajos (están en la base de datos), de los registros y las métricas, ni del índice de un motor de búsqueda, quemy search rebuildvuelve a crear.
| Qué | Dónde está | Copiar | Qué se pierde sin copia |
|---|---|---|---|
| La base de datos | el archivo SQLite (database_url) o la base de datos PostgreSQL |
SQLite o PostgreSQL | todo: cuentas, publicaciones, seguimientos, configuración |
| Los archivos multimedia | el directorio blob_fs_dir del almacén de blobs fs, o el bucket blob_s3_bucket del almacén de blobs s3 o blob_gcs_bucket del almacén de blobs gcs |
Archivos multimedia o Archivos multimedia en un bucket | las imágenes, los videos y los archivos de audio subidos, y los archivos remotos en caché |
| La KEK | donde guardes MY_KEK o el archivo de MY_KEK_FILE (secrets/kek con Compose; nunca en la base de datos) |
La KEK, por separado de la base de datos | la clave privada de cada actor y con ella la identidad del actor en el fediverso, y los demás secretos que guarda la base de datos |
| La configuración | las variables de entorno, el archivo de configuración (MY_CONFIG), los secretos (MY_VAPID_PRIVATE_KEY, claves de correo y de pagos), .env con Compose |
cópialos con tus archivos de despliegue | nada de los datos, pero la instancia no puede arrancar igual; cambiar host rompe todas las URL federadas |
Lo que no necesita copia:
- El almacén de clave-valor (
kv). Conkv = dbforma parte de la base de datos. Conkv = memoryokv = valkeycontiene cachés, contadores de límite de frecuencia y estado de corta duración, como un inicio de sesión que espera su segundo factor. Tras una restauración con un Valkey vacío, las cachés se vuelven a llenar, los límites de frecuencia empiezan de cero y un inicio de sesión o una llamada de voz en curso tienen que empezar de nuevo. - La cola de trabajos (
queue). Conqueue = dbyqueue = cloudtaskslos trabajos forman parte de la base de datos y vuelven con ella. Las tareas de Cloud Tasks solo llevan una señal para un trabajo de la base de datos; tras una restauración, el servidor vuelve a señalar los trabajos pendientes en pocos minutos. - Los registros y las métricas, que el servidor no vuelve a leer.
- El índice de un motor de búsqueda, si tienes uno.
my search rebuildlo vuelve a crear a partir de la base de datos. Si haces instantáneas del motor, contienen el texto de las publicaciones, incluidas las publicaciones eliminadas después de la instantánea, así que trátalas como copias de la base de datos (Búsqueda de texto completo).
La clave VAPID de Web Push es un secreto de la configuración. Una clave nueva detiene las notificaciones push a todas las suscripciones existentes (Clave VAPID de Web Push), así que guárdala con la configuración.
Con qué frecuencia y dónde
Sección titulada «Con qué frecuencia y dónde»- Base de datos: al menos una vez al día, y antes de cada actualización. Conserva varias generaciones, por ejemplo 7 copias diarias, 4 semanales y 3 mensuales, para que un error detectado tarde aún se pueda deshacer. Un PostgreSQL administrado con recuperación a un momento dado cubre los días que abarca su retención.
- Archivos multimedia: junto con la base de datos, cada vez (consulta El orden de la base de datos y los archivos multimedia).
- KEK y configuración: cuando cambian. Una rotación de la KEK es un cambio: copia la KEK nueva antes de usarla y conserva la anterior
mientras
kek_previousla liste. - Dónde: lejos del servidor y de su disco, en otro dominio de fallo (otra máquina, otra región, otro proveedor u otra cuenta). Una copia en el disco del propio servidor no sobrevive a la pérdida de ese disco.
- Cifrado: la copia de la base de datos contiene direcciones de correo electrónico, hashes de contraseñas y mensajes directos; cífrala en reposo
(un bucket cifrado, o cifra el archivo con
ageogpgantes de subirlo). Los secretos que contiene, como las claves privadas de los actores, están cifrados con la KEK, así que nunca guardes la KEK en el mismo lugar que las copias de la base de datos: quien obtenga ambas puede leer todos los secretos. - Retención: una copia conserva datos que los usuarios eliminaron o que borraste a petición suya. Elimina las generaciones antiguas con un calendario que indique tu política de privacidad.
Hacer la copia
Sección titulada «Hacer la copia»El servidor puede seguir funcionando durante una copia. Para hacer una que corresponda exactamente a un momento dado, por ejemplo antes de una actualización,
cambia antes al modo de mantenimiento: en el modo de mantenimiento my serve no abre ninguna conexión con la base de datos y no escribe nada.
my db backup <file> escribe una copia consistente de la base de datos SQLite en un archivo nuevo mientras el servidor sigue funcionando.
La copia contiene todas las escrituras confirmadas antes de que empezara el comando, incluidas las que aún están en el archivo -wal, y ninguna posterior.
Es un único archivo, más pequeño que el original porque se omiten las páginas libres. El comando rechaza un archivo que ya existe
y solo funciona con database = sqlite.
my db backup /backup/my-$(date +%Y%m%d%H%M).dbCon Docker Compose, ejecútalo en el contenedor del servidor. La copia se escribe dentro del contenedor, así que escríbela en el volumen de datos y sácala de allí:
cd deploy/dockerdocker compose exec -T my my db backup /data/backup.dbdocker run --rm -v my_data:/data -v "$PWD":/backup busybox sh -c 'mv /data/backup.db /backup/my-$(date +%Y%m%d%H%M).db'No copies el archivo de la base de datos con cp o tar mientras el servidor funciona: el archivo por sí solo no incluye las escrituras que aún están en el archivo -wal,
y una copia hecha en medio de una escritura puede estar dañada. Una copia simple es válida cuando ningún proceso tiene abierta la base de datos
(el servidor detenido, o en el modo de mantenimiento); entonces copia con él los archivos -wal y -shm.
PostgreSQL
Sección titulada «PostgreSQL»Usa pg_dump en el formato personalizado, que lee pg_restore. Lee una sola instantánea, así que el servidor puede seguir funcionando.
pg_dump --format=custom --file=my-$(date +%Y%m%d%H%M).dump "postgres://my:...@db.example/my"Con la capa de Compose compose.postgres.yaml, ejecútalo en el contenedor de la base de datos (indica la capa con -f o en COMPOSE_FILE):
cd deploy/dockerdocker compose exec -T postgres pg_dump --format=custom -U my my > my-$(date +%Y%m%d%H%M).dumpUsa el pg_dump de la misma versión mayor que el servidor o de una más reciente.
Un PostgreSQL administrado tiene sus propias copias, que son la mejor opción para una base de datos grande:
- Cloud SQL y Amazon RDS hacen copias diarias automáticas y, con la recuperación a un momento dado activada, restauran a cualquier segundo dentro del periodo de retención. Activa ambas, fija la retención para que cubra las generaciones que quieras y haz una copia bajo demanda (una copia bajo demanda de Cloud SQL, una instantánea de RDS) antes de cada actualización.
- Su restauración crea una instancia nueva (o sobrescribe una): después apunta
database_urla ella. - Estas copias permanecen dentro de la cuenta del proveedor. Exporta de vez en cuando un
pg_dumpa algún lugar fuera de ella también, para que perder la cuenta no suponga perder los datos.
Archivos multimedia
Sección titulada «Archivos multimedia»El almacén de blobs fs guarda todos los archivos bajo blob_fs_dir (/data/blobs con Compose): las subidas en objects/ y los archivos que se están escribiendo en tmp/.
Copia el directorio, salvo tmp/, con cualquier herramienta que copie archivos (tar, rsync, una instantánea del volumen o del disco).
Un archivo se escribe en tmp/ y luego se renombra a objects/ en un solo paso, así que una copia hecha mientras el servidor funciona nunca contiene medio archivo en objects/.
docker run --rm -v my_data:/data -v "$PWD":/backup busybox \ tar czf /backup/blobs-$(date +%Y%m%d%H%M).tar.gz -C /data --exclude=blobs/tmp blobsrsync al host de copias mantiene pequeña la copia a partir de la segunda vez, ya que los archivos multimedia nunca cambian una vez escritos.
Contenido multimedia en un bucket
Sección titulada «Contenido multimedia en un bucket»Los almacenes de blobs s3 y gcs guardan cada archivo como un objeto del bucket blob_s3_bucket o blob_gcs_bucket, con su clave como nombre: el contenido multimedia procesado bajo media/,
las subidas tal como se recibieron bajo uploads/, y los archivos remotos en caché bajo remote/. El bucket permanece privado: el servidor lee los
archivos y los sirve bajo /media/. Un objeto aparece solo cuando se ha escrito entero, así que una copia tomada mientras el servidor funciona nunca contiene
medio archivo. Protege el bucket en tres capas, de la más barata a la más segura.
Control de versiones. Activa el control de versiones de objetos del bucket donde el servicio lo ofrezca (Amazon S3, Google Cloud Storage, MinIO y otros). Un objeto eliminado o sobrescrito permanece entonces como una versión no actual, y el bucket puede volver al momento de una copia de seguridad de la base de datos.
aws s3api put-bucket-versioning --bucket my-media --versioning-configuration Status=EnabledCon los módulos de OpenTofu de Amazon S3 y Google Cloud Storage, define versioning = true: activa el control de versiones y añade la regla para las versiones no actuales
que se describe a continuación, cuya antigüedad es noncurrent_version_days (35 de forma predeterminada). Cloudflare R2 no tiene control de versiones de objetos, y el módulo para otro almacén compatible con S3
no crea el bucket, así que para esos dos usa una copia (más abajo).
Reglas de ciclo de vida. Con el control de versiones, cada archivo eliminado conserva su costo de almacenamiento hasta que una regla lo elimina. Añade una regla que elimine las versiones no actuales tras la antigüedad de tu copia de seguridad de la base de datos más antigua (35 días para las generaciones de Con qué frecuencia y dónde sin las mensuales), de modo que cada copia de seguridad de la base de datos que conserves siga encontrando sus archivos y un archivo que un usuario eliminó no permanezca más tiempo del que dice tu política de privacidad. Añade una regla que anule las subidas multiparte incompletas tras un día: el servidor anula por sí mismo una subida fallida de un archivo grande, pero un proceso que se detiene a mitad de una deja sus partes atrás.
{ "Rules": [ { "ID": "noncurrent-versions", "Status": "Enabled", "Filter": {}, "NoncurrentVersionExpiration": { "NoncurrentDays": 35 }, "AbortIncompleteMultipartUpload": { "DaysAfterInitiation": 1 } } ]}aws s3api put-bucket-lifecycle-configuration --bucket my-media --lifecycle-configuration file://lifecycle.jsonUna copia en otra cuenta o región. El control de versiones protege frente a un error, no frente a la pérdida del bucket o de la cuenta que lo posee, y las propias credenciales del servidor pueden eliminar objetos. Mantén una copia a la que esas credenciales no lleguen:
-
Replicación. Amazon S3 replica un bucket con versiones a un bucket de otra región o de otra cuenta (replicación entre regiones o en la misma región, con el destino perteneciente a la otra cuenta). Activa también el control de versiones en el destino y no repliques las eliminaciones (deja desactivada la replicación de marcadores de eliminación), para que una eliminación en la instancia no llegue a la copia. Otros servicios tienen su propia replicación, como los buckets de doble región de Cloud Storage y la replicación de buckets de MinIO.
-
Una copia programada. Donde no hay replicación, o para copiar a otro proveedor, copia el bucket según la programación de la copia de seguridad de la base de datos, justo después de ella, con credenciales que solo puedan leer el bucket de la instancia y solo escribir en el bucket de copia de seguridad:
Ventana de terminal rclone copy --checksum source:my-media backup:my-media-backuprclone copyyaws s3 syncsin--deleteañaden objetos nuevos y nunca eliminan uno de la copia. Los archivos nunca cambian una vez escritos, así que tras la primera ejecución cada copia transfiere solo los nuevos. Elimina los objetos antiguos de la copia según la programación de tu política de retención, o activa también allí el control de versiones y una regla de ciclo de vida.
Las credenciales se quedan fuera de la copia: el bucket no contiene ningún secreto, pero la configuración nombra la clave en blob_s3_access_key_id
y blob_s3_secret_access_key, que van con la configuración. El almacén de blobs gcs no guarda ninguna clave: usa la cuenta de servicio
de la máquina o de Cloud Run.
El orden de la base de datos y los archivos multimedia
Sección titulada «El orden de la base de datos y los archivos multimedia»Copia primero la base de datos y después los archivos multimedia, y mantén las dos juntas como una generación. En un bucket, la copia o la replicación que se ejecuta después de la copia de la base de datos es la copia de los archivos multimedia; con el control de versiones, lo son las versiones del momento de la copia de la base de datos.
La base de datos nombra los archivos multimedia que usa, y la copia de los archivos multimedia se hace un instante después. En ese instante:
- Pueden llegar subidas nuevas a la copia multimedia sin una fila en la copia de la base de datos. Son archivos que nada usa; ocupan espacio y no hacen daño.
- Un archivo eliminado después de la copia de la base de datos (los archivos multimedia de una publicación eliminada, una subida que nunca se adjuntó) está en la copia de la base de datos pero no en la copia multimedia.
Tras una restauración, ese archivo responde
404, y la publicación que lo mostraba muestra una imagen que falta.
El otro orden es peor: todos los archivos subidos entre la copia multimedia y la copia de la base de datos faltarían tras una restauración, incluidos los archivos multimedia de las publicaciones nuevas. Hacer ambas copias en el modo de mantenimiento evita cualquiera de los dos desfases.
En los destinos de OpenTofu
Sección titulada «En los destinos de OpenTofu»Los módulos no guardan ninguna copia de seguridad propia más allá de lo que ofrece el proveedor: el PostgreSQL gestionado de Cloud SQL y RDS tiene copias de seguridad automáticas con una retención que tú defines, mientras que una base de datos con solo el historial del proveedor (Neon) solo puede retroceder hasta donde llegue ese historial. Programa esto tú mismo, con credenciales que la instancia no tenga:
- La base de datos, cada día. Ejecuta
pg_dumpcontra el PostgreSQL de la instancia desde una máquina o un trabajo programado fuera del proveedor que aloja la base de datos (consulta PostgreSQL), cifra el volcado y escríbelo en un bucket de otra cuenta o proveedor. Conserva las generaciones de Con qué frecuencia y dónde. El trabajo necesita eldatabase_urly nada más; no debe tener la KEK. - El contenido multimedia, justo después. Con
versioning = trueen el módulo del bucket, las versiones son la copia durante los últimosnoncurrent_version_days; para la pérdida de la cuenta, ejecuta tambiénrclone copydesde el bucket de la instancia a un bucket en otro lugar, como en Contenido multimedia en un bucket, según la programación del volcado de la base de datos. - La KEK y la configuración no forman parte de la programación: haz una copia de ellas cuando cambien (La KEK y la configuración).
La KEK y la configuración
Sección titulada «La KEK y la configuración»La KEK no está en la base de datos. Cópiala una vez, por separado de las copias de la base de datos, como describe Administrar la clave de cifrado de claves,
y de nuevo después de cada rotación. Guarda una copia de la configuración (el entorno, el archivo de configuración, .env y los archivos de secretos)
con tus archivos de despliegue, sin la KEK.
Restaurar
Sección titulada «Restaurar»Una copia contiene el host y el account_domain de su instancia. Inicia la base de datos restaurada con los mismos valores: con otros, el servidor se niega a arrancar.
Restaura en un entorno vacío (una máquina nueva, volúmenes nuevos o una base de datos nueva), en este orden: la base de datos, los archivos multimedia (el directorio o el bucket)
y después la configuración con la misma KEK (y el mismo kek_previous) que estaba en uso cuando se hizo la copia. Después arranca el servidor como de costumbre.
Detén el servidor, pon el archivo de copia en lugar del archivo de la base de datos y elimina los antiguos archivos -wal y -shm si queda alguno.
Con Docker Compose, en el volumen my_data (uno existente, o uno nuevo en otra máquina):
cd deploy/dockerdocker compose down # keeps the volume; on a new machine, `docker compose up --no-start` creates itdocker run --rm -v my_data:/data -v "$PWD":/backup busybox sh -c ' rm -rf /data/my.db /data/my.db-wal /data/my.db-shm /data/blobs && cp /backup/my-202601010000.db /data/my.db && tar xzf /backup/blobs-202601010000.tar.gz -C /data && chown -R 65532:65532 /data'docker compose up -dLa imagen del servidor se ejecuta como el usuario 65532, que debe ser propietario de los archivos del volumen (el chown de arriba).
PostgreSQL
Sección titulada «PostgreSQL»Restaura en una base de datos nueva y vacía, preparada como para una instancia nueva, pero sin aplicar el esquema: el volcado ya lo contiene.
-
Crea el rol y la base de datos.
-
Restaura el volcado. Como superusuario, las tablas restauradas conservan su propietario (el rol debe existir); como propietario de la base de datos, añade
--no-owner.Ventana de terminal pg_restore --exit-on-error --dbname="postgres://postgres:...@db.example/my" my-202601010000.dump -
Con la copia propia de una base de datos administrada, restáurala a la manera del proveedor y apunta
database_urla la instancia restaurada.
Con la capa de Compose compose.postgres.yaml, inicia solo la base de datos, en un volumen nuevo, y restaura en ella. El contenedor ya ha creado el rol y la base de datos:
cd deploy/dockerdocker compose up -d --wait postgresdocker compose exec -T postgres pg_restore --exit-on-error --no-owner -U my -d my < my-202601010000.dumpdocker compose up -dPara restaurar sobre una base de datos existente (revertir una actualización), usa pg_restore --clean --if-exists, como muestra Revertir.
Archivos multimedia
Sección titulada «Archivos multimedia»Extrae la copia multimedia en blob_fs_dir antes de que arranque el servidor, con el usuario con el que se ejecuta el servidor como propietario.
Archivos multimedia en un bucket
Sección titulada «Archivos multimedia en un bucket»Restaura los objetos en un bucket vacío antes de que arranque el servidor y luego apunta blob_s3_bucket (y el endpoint, la región y las credenciales) o blob_gcs_bucket a él.
Las claves deben seguir siendo las mismas: la base de datos nombra cada archivo por su clave.
-
Desde una copia en otro bucket, cópiala de vuelta:
Ventana de terminal rclone copy --checksum backup:my-media-backup target:my-media-restored -
Desde las versiones del propio bucket de la instancia, copia los objetos tal como estaban en el momento de la copia de la base de datos a un bucket nuevo.
rclonelee las versiones de ese momento con--s3-version-at:Ventana de terminal rclone copy --s3-version-at "2026-01-01 00:00:00" source:my-media target:my-media-restored -
Desde una réplica, apunta
blob_s3_bucketoblob_gcs_bucketa la réplica, o cópiala de vuelta a un bucket de la cuenta original.
Las credenciales del servidor necesitan leer, escribir y eliminar objetos del bucket restaurado (s3:GetObject, s3:PutObject, s3:DeleteObject
y s3:AbortMultipartUpload en Amazon S3; el rol roles/storage.objectUser en el bucket en Google Cloud Storage).
Arrancar y comprobar
Sección titulada «Arrancar y comprobar»Arranca el servidor de la forma habitual. Con Docker Compose, docker compose up -d ejecuta primero my db upgrade -check, el esquema y my db upgrade;
con una copia de la misma versión no cambian nada. Después comprueba:
/readyzresponde200y el servidor no registra ningún errorunknown key-encryption key.my projection verifyno informa de ninguna diferencia (Comprobar y reconstruir proyecciones).- Puedes iniciar sesión y se muestran las últimas publicaciones y sus archivos multimedia.
- Las claves de los actores no han cambiado: el
publicKey.publicKeyPemde un actor (curl -H 'Accept: application/activity+json' https://<host>/ap/actors/<id>) es el mismo que antes de la restauración. Otros servidores verifican las firmas de la instancia con esa clave, así que una clave sin cambios significa que la federación continúa donde se detuvo. - Una publicación, un seguimiento o un dejar de seguir llega a otro servidor (una cuenta de prueba en otra instancia lo ve).
Las escrituras hechas después de la copia se pierden: las publicaciones, los seguimientos y las subidas desde entonces desaparecen en esta instancia, mientras que otros servidores aún pueden tener las actividades que recibieron. Eso no se puede reparar desde aquí; restaura desde la copia más reciente que tengas.
Con un motor de búsqueda, ejecuta my search rebuild después de la restauración, sin --keep, para que las publicaciones más recientes que la copia salgan del índice (Búsqueda de texto completo).
Sin la KEK correcta
Sección titulada «Sin la KEK correcta»- Sin KEK: el servidor no arranca.
my servey los demás comandosmyque leen la configuración se detienen ahí conThe required setting MY_KEK is not set.ykek: required when key_manager is local. - Otra KEK: el servidor arranca y responde
/readyz, pero todo lo que lee un secreto cifrado con la KEK antigua falla conunknown key-encryption keyy el ID de clave de la KEK antigua (local key manager: key "local:…" is not configured): las entregas a otros servidores y las obtenciones firmadas (las claves privadas de los actores), los inicios de sesión con autenticación de dos factores, las firmas de webhooks y los proveedores de inicio de sesión externos. Las URL del proxy de archivos multimedia emitidas antes también dejan de funcionar. Las contraseñas y las publicaciones no se cifran con la KEK, así que el inicio de sesión con contraseña y la lectura de publicaciones siguen funcionando, lo que puede ocultar el problema al principio: vigila el registro por si aparece el error. - Busca la KEK cuyo ID de clave nombra el error, ponla como
kek(o enkek_previous) y reinicia. No hay forma de recuperar un secreto sin su KEK; si la KEK se pierde para siempre, hay que regenerar las claves de los actores, y otros servidores ven cada actor como una clave nueva para la misma cuenta.
Simulacro de recuperación
Sección titulada «Simulacro de recuperación»Solo se sabe que una copia de seguridad funciona cuando se ha restaurado. Ensaya una restauración antes de que la instancia sea pública, y de nuevo tras un cambio en cómo se hacen las copias de seguridad (al menos cada pocos meses):
-
Haz una copia de seguridad de la instancia en producción como se indicó antes: la base de datos y después el contenido multimedia.
-
En otra máquina o en otro proyecto de Compose, restáurala con la KEK y la configuración de donde las guardes (no copiadas del servidor en producción), y con
hostsin cambios para que las URL de los actores coincidan. -
No dejes que la copia federe. Define
role = web, que no ejecuta ningún worker de trabajos: los trabajos restaurados con la base de datos incluyen entregas que estaban pendientes cuando se hizo la copia de seguridad, y una copia que los ejecuta los firma con las claves de los actores reales y los envía de nuevo a otros servidores. Mantener la copia fuera de internet no basta, ya que es difícil garantizarlo. Activa el modo de mantenimiento cuando pasen las comprobaciones de abajo si la mantienes en funcionamiento. -
Fuera de Compose, por ejemplo en una máquina local contra una instancia en la nube, da a la copia estos ajustes para que no toque nada de la instancia en producción:
Ajuste Valor en la copia Por qué rolewebNo ejecuta ningún trabajo, así que nada de lo restaurado se entrega de nuevo queuedbLos trabajos encolados en la copia se quedan en su base de datos en lugar de llegar a la cola en producción streampostgresNo se une al flujo de eventos en producción de la instancia mailnoneNo envía correo a usuarios reales el almacén de blobs un bucket nuevo (o directorio) con el contenido multimedia restaurado Deja intacto el bucket en producción database_urlla base de datos restaurada Nunca la de producción la KEK ( MY_KEK, okey_managerykms_key)como en producción, desde donde la guardes Sin ella la copia no arranca hostcomo en producción Para que las URL de los actores coincidan -
Repasa Arranque y comprobación: inicia sesión, publicaciones y contenido multimedia, y la
publicKeyde unos pocos actores comparada con la instancia en producción. -
Arráncala una vez sin la KEK y otra con una distinta, y comprueba que falla como describe Sin la KEK correcta.
-
Anota cuánto tardó cada paso: es lo que mantiene caída la instancia en una restauración real.
Para LLM y agentes de programación:llms.txt,llms-full.txt, llms-small.txt