

Diese Seite ist eine maschinelle Übersetzung der englischen Seite, die maßgeblich ist. Englische Seite lesen
Wartung
Wie du den Server für Arbeiten an der Datenbank, am KV oder an der Queue herunterfährst und was du anzeigst, solange er nicht läuft.
Es gibt zwei Werkzeuge:
- Der Wartungsmodus (
maintenance = true,MY_MAINTENANCE=trueodermy serve -maintenance).my servestartet, ohne einen Adapter zu öffnen, und beantwortet jede Anfrage mit einem503, einemRetry-Afterund einer Antwort, die jeder Client versteht. Nutze ihn immer, wennmy serveselbst laufen kann. - Die exportierte Seite (
my maintenance export). Statisches HTML aus demselben Template, das ein Load Balancer, CDN oder Reverse-Proxy ausliefert, wennmy servegar nicht laufen kann (ein Image wird ersetzt, eine Revision startet nicht). Siehe Die Wartungsseite exportieren.
Was der Wartungsmodus antwortet
Abschnitt betitelt „Was der Wartungsmodus antwortet“Der Prozess liest nur die Listen-Adresse, host, account_domain, web_origin, die Proxys (trusted_proxies, trusted_proxy_header),
die Origin-Prüfung (origin_secret, origin_secret_previous, origin_secret_header), status_page_url und die Einstellungen maintenance_* (Konfigurationsreferenz).
Die Einstellungen von Datenbank, Queue, Blob-Store, KV, Mail und Stream werden nicht gelesen oder geprüft, sodass sie in der Zwischenzeit falsch oder nicht erreichbar sein dürfen.
Was auch immer die role ist, er bedient nur HTTP: keine Jobs, keine periodischen Jobs, keinen Stream-Broker. Er bedient außerdem unabhängig von tls einfaches HTTP,
auf listen oder seinem Standard :8080 (HTTPS vom Server aus ausliefern).
my config check -maintenance prüft genau das, was der Wartungsmodus liest.
Ist origin_secret gesetzt, erhält eine Anfrage, die den Header braucht und ihn nicht hat, das 403 dieser Prüfung statt der folgenden Tabelle.
| Anfrage | Status | Body |
|---|---|---|
GET /healthz, GET /readyz, GET /health/live, GET /health/ready |
200 |
{"status":"maintenance"} |
GET /api/v1/instance/health |
503 |
{"status":"maintenance"} |
Der Rest der Client-API (/api/*) und die OAuth-Endpunkte, die JSON antworten |
503 |
application/problem+json vom Typ /api/v1/problems/maintenance, mit message, until und, wenn gesetzt, status_page_url |
ActivityPub (nach Pfad, Accept oder Content-Type), WebFinger, host-meta, NodeInfo, die Zahlungs-Webhooks, die Aufrufe von Cloud Tasks und Cloud Scheduler (/_internal/*) |
503 |
{"error":"maintenance"} |
| Alles andere (Seiten, der Webclient, seine Assets, Formular-Posts) | 503 |
Die Wartungsseite oder das Problem, wenn Accept JSON verlangt |
Jede Antwort hat Retry-After und Cache-Control: no-store. Retry-After zählt die Sekunden bis maintenance_until, solange es in der Zukunft liegt
(höchstens 86.400), und ist sonst maintenance_retry_after (eine Go-Dauer, Standard 10m).
Die Seite und das Problem zeigen:
| Einstellung | Angezeigt als |
|---|---|
maintenance_server_name |
Der Name des Servers. Der Hostname, wenn nicht gesetzt (der eigene Name der Instanz steht in der Datenbank) |
maintenance_message |
Ein Hinweis als reiner Text, höchstens 2.000 Zeichen, in jeder Sprache derselbe |
maintenance_until |
Wann das Ende der Arbeiten erwartet wird (RFC 3339). Die Seite zeigt es in UTC; der Webclient in der Zeitzone des Benutzers |
status_page_url |
Ein Link zur Statusseite (Monitoring) |
Die Einstellungen maintenance_* dürfen im Normalbetrieb gesetzt bleiben: Sie werden nur verwendet, solange maintenance wahr ist.
Die Texte der Seite folgen Accept-Language (sonst Englisch).
Der Webclient zeigt einen Wartungshinweis im Vollbild, wenn die API mit dem Wartungsproblem antwortet,
hält den Benutzer angemeldet und versucht es nach Retry-After erneut.
Wie lange
Abschnitt betitelt „Wie lange“Halte eine Wartung auf wenige Stunden begrenzt. Andere Server wiederholen ihre Zustellungen bei 503, aber keiner von ihnen liest Retry-After,
und wenn ihre Wiederholungen aufgebraucht sind, gehen die in der Zwischenzeit gesendeten Aktivitäten für diesen Server verloren.
Das kürzeste Wiederholungsfenster unter den großen Implementierungen beträgt etwa einen Tag (Akkoma etwa 1 Tag, Misskey etwa 1,5 Tage, Mastodon etwa 2–3 Tage, Pleroma etwa 7 Tage,
nach ihren Wiederholungsplänen).
Suchmaschinen behandeln ein kurzes 503 als vorübergehenden Ausfall, aber Google rät davon ab, für robots.txt länger als ein oder zwei Tage 503 auszuliefern.
Ein Stillstand von mehr als ein oder zwei Tagen ist keine Wartung: Schließe stattdessen den Dienst (Den Dienst schließen).
Schritte
Abschnitt betitelt „Schritte“- Kündige es an. Veröffentliche das Zeitfenster eine Weile im Voraus auf der Statusseite (
status_page_url) und als Ankündigung (Administration → Ankündigungen). Setzemaintenance_messageundmaintenance_untilin der Konfiguration der Bereitstellung und aktualisiere die exportierten Seiten (my maintenance export), wenn das Frontend sie ausliefert. - Stoppe die Push-Queue (Cloud Tasks) — siehe unten. Sonst ist jede Zustellung während des Zeitfensters
ein
503, das einen der Versuche der Task aufbraucht. - Schalte in den Wartungsmodus: Stelle mit
MY_MAINTENANCE=trueneu bereit (je Ziel unten). Jedes Replikat startet im Wartungsmodus neu; der Load Balancer behält sie, weil/readyzmit200antwortet. - Erledige die Arbeit.
- Schalte zurück: Stelle ohne
MY_MAINTENANCE(oder mitfalse) neu bereit, prüfe, dass/health/readyund/api/v1/instance/healthmit{"status":"ok"}antworten, setze dann die Push-Queue fort und schließe die Ankündigung.
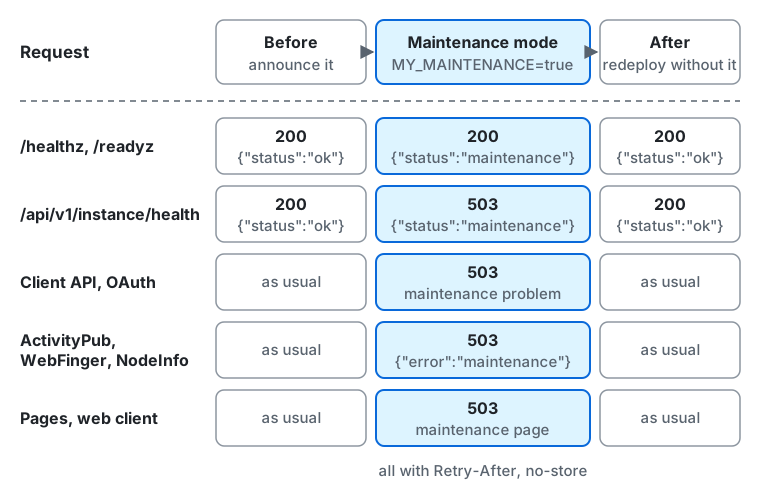
Von links nach rechts:
- Davor, während du die Wartung ankündigst, wird jede Anfrage wie gewohnt beantwortet:
/healthz,/readyzund/api/v1/instance/healthantworten mit200und{"status":"ok"}. - Im Wartungsmodus (
MY_MAINTENANCE=true):/healthz,/readyz,/health/liveund/health/readyantworten mit200und{"status":"maintenance"}./api/v1/instance/healthantwortet mit503und{"status":"maintenance"}.- Der Rest der Client-API und die OAuth-Endpunkte, die JSON antworten, erhalten
503mit dem Wartungsproblem. - ActivityPub, WebFinger und NodeInfo antworten mit
503und{"error":"maintenance"}. - Seiten und der Webclient erhalten
503mit der Wartungsseite. - Jede Antwort hat
Retry-AfterundCache-Control: no-store.
- Danach, wenn du ohne
MY_MAINTENANCEneu bereitstellst, wird jede Anfrage wieder wie gewohnt beantwortet.
Push-Queues
Abschnitt betitelt „Push-Queues“-
Cloud Tasks: Pausiere die Queue, die weiterhin neue Aufgaben annimmt, sie aber nicht mehr zustellt, und setze sie nach der Arbeit fort. Wie viele Versuche eine Aufgabe hat, bestimmt das
retryConfig.maxAttemptsder Queue.Terminal-Fenster gcloud tasks queues pause my-jobs --location=asia-northeast1gcloud tasks queues resume my-jobs --location=asia-northeast1Pausiere auch den Cloud-Scheduler-Job von
/_internal/tick(gcloud scheduler jobs pause/resume) oder lass seine Aufrufe in der Zwischenzeit mit503fehlschlagen. Die Jobs selbst liegen in der Datenbank: Eine Aufgabe, die ihre Versuche aufgebraucht hat, verliert nur ihr Signal, und der erste Tick nach der Arbeit signalisiert jeden Job, der fällig ist, erneut.
Je Ziel
Abschnitt betitelt „Je Ziel“Die Fehlerseiten der Frontends unten beantworten die Fehler des Servers mit der exportierten Seite. Greife nur die Fehler eines Servers ab, der nicht läuft
(502 und 504 sowie das eigene 503 des Load Balancers, wo er kein gesundes Backend hat), oder schalte die Regel nur ein, solange my serve nicht laufen kann:
Eine Regel auf jedes 503 würde auch die eigenen Antworten des Wartungsmodus ersetzen, etwa das Problem, das die Client-API und der Web-Client lesen.
Cloud Run
Abschnitt betitelt „Cloud Run“Deploye eine neue Revision mit der Variable und entferne sie danach:
gcloud run services update my --region=asia-northeast1 \ --update-env-vars=MY_MAINTENANCE=true,MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Zgcloud run services update my --region=asia-northeast1 --remove-env-vars=MY_MAINTENANCE,MY_MAINTENANCE_UNTILSetze es mit dem OpenTofu-Modul stattdessen im Block, als settings = { maintenance = "true" }, und wende es an, denn das nächste Apply stellt
wieder her, was der Block sagt: Auf Cloud Run bereitstellen beschreibt es rund um ein Upgrade.
Wenn Cloud Run direkt ohne Load Balancer erreichbar ist, steht nichts davor, daher ist der Wartungsmodus das einzige Werkzeug.
Wenn my serve nicht laufen kann, hinter einem globalen externen Application Load Balancer: Lade das exportierte index.html in einen Cloud-Storage-Bucket hoch,
der als Backend-Bucket hinzugefügt ist, und füge eine Richtlinie für benutzerdefinierte Fehlerantworten hinzu, die das 502 und 504 des Backends damit beantwortet, mit overrideResponseCode: 503.
Nur der globale externe Application Load Balancer hat benutzerdefinierte Fehlerantworten (nicht die regionalen oder klassischen), und die Richtlinie gilt nur
für Antworten des Backends, nicht für solche, die Google Front End selbst erzeugt. Dieser Weg kann kein Retry-After senden: Die benutzerdefinierten Header der Fehlerquelle werden nicht hinzugefügt.
# Part of the URL map (gcloud compute url-maps import).defaultCustomErrorResponsePolicy: errorService: https://www.googleapis.com/compute/v1/projects/<project>/global/backendBuckets/my-maintenance errorResponseRules: - matchResponseCodes: ["502", "504"] path: /index.html overrideResponseCode: 503AWS ECS
Abschnitt betitelt „AWS ECS“Registriere eine Revision der Task-Definition des Dienstes mit MY_MAINTENANCE=true in der Umgebung des Containers, aktualisiere den Dienst darauf
und tue danach dasselbe ohne die Variable. Setze es mit dem OpenTofu-Modul stattdessen im Block, als settings = { maintenance = "true" },
und wende es an, denn das nächste Apply stellt wieder her, was der Block sagt: Wende rund um ein Upgrade zuerst den Modus an, dann das neue Release, dann den Block ohne ihn,
wie es Auf Cloud Run bereitstellen tut.
Wenn my serve nicht laufen kann, hinter CloudFront: Lade das exportierte index.html in einen S3-Bucket hoch, der eine zweite Origin ist
(die Fehlerseite kann nicht von der ausfallenden Origin kommen), und füge benutzerdefinierte Fehlerantworten für 502 und 504 hinzu (und 503 nur, solange my serve nicht laufen kann)
mit ResponsePagePath: /maintenance/index.html und ResponseCode: 503.
CloudFront kann Retry-After über eine Response Headers Policy mit einem benutzerdefinierten Header hinzufügen, aber die Richtlinie gilt für jede Antwort des Cache-Behaviors,
also hänge sie nur für die Wartung an und löse sie danach wieder.
Die feste Antwort eines Application Load Balancers kann die exportierte Seite nicht tragen: Ihr Body ist höchstens 1.024 Zeichen lang, und sie setzt keine Header wie Retry-After.
Nutze sie nur für einen kurzen Text und den Status:
{ "Type": "fixed-response", "FixedResponseConfig": { "StatusCode": "503", "ContentType": "text/plain", "MessageBody": "This server is under maintenance. Please try again later. / メンテナンス中です。しばらくしてからお試しください。" }}Ohne Retry-After wiederholen andere Server nach ihrem eigenen Zeitplan, den das Fenster oben bereits berücksichtigt.
Docker Compose
Abschnitt betitelt „Docker Compose“deploy/docker/compose.yaml reicht die Einstellungen aus .env an den Server weiter und übernimmt MY_MAINTENANCE, MY_MAINTENANCE_MESSAGE und MY_MAINTENANCE_UNTIL auch aus der Shell.
Setze sie und erzeuge den Dienst my neu, entferne dann nach der Arbeit MY_MAINTENANCE und erzeuge ihn erneut.
--no-deps verhindert, dass die einmaligen Datenbankdienste (upgrade-check, schema, upgrade) laufen; ein Upgrade führt sie aus (Upgrade):
MY_MAINTENANCE=true MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Z docker compose up -d --no-deps --force-recreate mydocker compose up -d --no-deps --force-recreate myWenn my serve nicht laufen kann, hinter nginx: Liefere die exportierten Seiten aus einem Verzeichnis aus, wähle eine nach Accept-Language
und beantworte das eigene 502 und 504 von nginx (der Server ist ausgefallen oder antwortet nicht) damit als 503.
Die eigenen 503 des Wartungsmodus laufen unverändert durch, da proxy_intercept_errors aus bleibt.
map $http_accept_language $maintenance_page {    default  en.html;    ~*^ja    ja.html;}
server {    # ...    location / {        proxy_pass http://my:8080;        error_page 502 504 =503 /maintenance/$maintenance_page;    }    location /maintenance/ {        internal;        alias /srv/maintenance/;   # the -out directory of my maintenance export        add_header Retry-After 600 always;        add_header Cache-Control no-store always;    }}
microk8s (Kubernetes)
Abschnitt betitelt „microk8s (Kubernetes)“Setze die Variable am Deployment, was die Pods neu ausrollt, und entferne sie danach:
microk8s kubectl set env deployment/my MY_MAINTENANCE=true MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Zmicrok8s kubectl rollout status deployment/mymicrok8s kubectl set env deployment/my MY_MAINTENANCE- MY_MAINTENANCE_UNTIL-Die Readiness-Probe auf /readyz besteht im Wartungsmodus weiter, sodass der Rollout abgeschlossen wird und der Service weiter auf die Pods routet.
Wenn my serve nicht laufen kann, hinter dem NGINX Ingress Controller (das microk8s-Add-on ingress): Liefere die exportierten Seiten aus einem kleinen
nginx-Deployment aus (zum Beispiel aus einer ConfigMap mit index.html, en.html und ja.html) und mache es zum benutzerdefinierten Default-Backend,
wobei der Controller das 502 und 504 des Servers daraus beantwortet (füge 503 nur hinzu, solange my serve nicht laufen kann):
metadata: annotations: nginx.ingress.kubernetes.io/custom-http-errors: "502,504" nginx.ingress.kubernetes.io/default-backend: my-maintenance # a Service in the same namespaceMonitoring während der Wartung
Abschnitt betitelt „Monitoring während der Wartung“/healthz,/readyz,/health/liveund/health/readybleiben200mit{"status":"maintenance"}: Load Balancer und Kubernetes behalten die Instanzen./api/v1/instance/healthantwortet mit503und{"status":"maintenance"}(Monitoring). Uptime-Monitore sehen den Server als ausgefallen, es sei denn, sie gleichen den Body ab oder haben ein Wartungsfenster; pausiere sie oder setze das Fenster.
Für LLMs und Coding-Agenten:llms.txt,llms-full.txt, llms-small.txt