

Diese Seite ist eine maschinelle Übersetzung der englischen Seite, die maßgeblich ist. Englische Seite lesen
Backup und Wiederherstellung
Was du sichern solltest, wie du jedes Backup erstellst, während der Server weiterläuft, wie du einen Server daraus wiederherstellst und wie du eine Wiederherstellung übst, bevor du sie brauchst. Auch Upgrades erstellen ein Backup; Upgrade beschreibt die Schritte drumherum.
Was gesichert werden sollte
Abschnitt betitelt „Was gesichert werden sollte“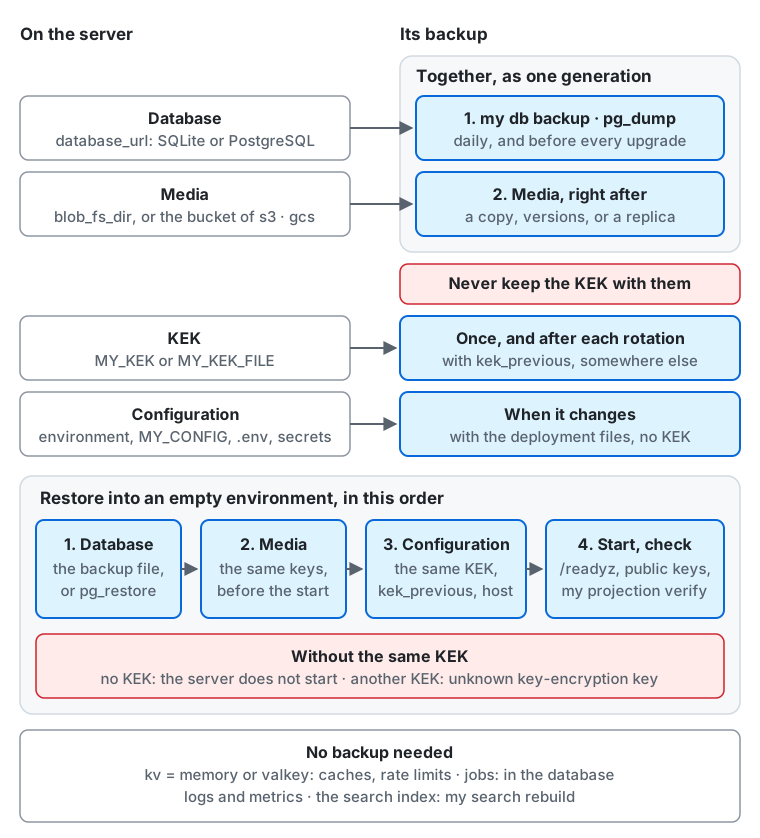
Im Diagramm von oben nach unten:
- Die Datenbank (
database_url: SQLite oder PostgreSQL) wird zuerst gesichert, mitmy db backupoderpg_dump, jeden Tag und vor jedem Upgrade. - Die Medien (
blob_fs_diroder der Bucket des Blob-Storess3odergcs) werden direkt danach gesichert, als Kopie, über die Versionen des Buckets oder über ein Replikat. Die beiden Backups sind eine Generation, werden zusammen aufbewahrt, getrennt vom Server und verschlüsselt. - Der KEK (
MY_KEKoderMY_KEK_FILE) wird einmal und nach jeder Rotation gesichert, zusammen mitkek_previous, und nie am selben Ort wie die Datenbank-Backups. Mitkey_manager = gcpkmsoderawskmsbleibt der KEK im KMS: Lass den Schlüssel vonkms_keyaktiviert, solange du Backups aufbewahrst, die ihn brauchen (Einen AWS-KMS-Schlüssel außer Betrieb nehmen). - Die Konfiguration (die Umgebung,
MY_CONFIG,.envund die Secrets) wird mit den Deployment-Dateien kopiert, wenn sie sich ändert, ohne den KEK. - Eine Wiederherstellung erfolgt in eine leere Umgebung, in dieser Reihenfolge: zuerst die Datenbank, dann die Medien mit denselben Schlüsseln, bevor der Server startet,
dann die Konfiguration mit demselben KEK,
kek_previousundhost; danach startet der Server, und du prüfst/readyz,my projection verifyund die öffentlichen Schlüssel der Actors (Wiederherstellen). Ohne den KEK startet der Server nicht, und mit einem anderen schlägt das Lesen eines Secrets mitunknown key-encryption keyfehl (Ohne den richtigen KEK). - Kein Backup nötig ist für den Key-Value-Store mit
kv = memoryodervalkey(Caches und Rate Limits), die Jobs (sie liegen in der Datenbank), Logs und Metriken sowie den Index einer Suchmaschine, denmy search rebuildneu erzeugt.
| Was | Wo es liegt | Sichern | Ohne Backup verloren |
|---|---|---|---|
| Die Datenbank | die SQLite-Datei (database_url) oder die PostgreSQL-Datenbank |
SQLite oder PostgreSQL | alles: Konten, Beiträge, Follows, Einstellungen |
| Die Medien | das Verzeichnis blob_fs_dir des Blob-Stores fs, oder der Bucket blob_s3_bucket des Blob-Stores s3 bzw. blob_gcs_bucket des Blob-Stores gcs |
Medien oder Medien in einem Bucket | die hochgeladenen Bilder-, Video- und Audiodateien sowie die zwischengespeicherten entfernten Dateien |
| Der KEK | dort, wo du MY_KEK oder die Datei von MY_KEK_FILE aufbewahrst (secrets/kek mit Compose; nie in der Datenbank) |
Der KEK, getrennt von der Datenbank | der private Schlüssel jedes Actors und damit die Identität des Actors im Fediverse sowie die anderen Secrets, die die Datenbank speichert |
| Die Konfiguration | die Umgebungsvariablen, die Konfigurationsdatei (MY_CONFIG), die Secrets (MY_VAPID_PRIVATE_KEY, Mail- und Zahlungsschlüssel), .env mit Compose |
kopiere sie mit deinen Deployment-Dateien | nichts in den Daten, aber der Server kann nicht auf dieselbe Weise starten; eine Änderung von host macht jede föderierte URL ungültig |
Was kein Backup braucht:
- Der Key-Value-Store (
kv). Mitkv = dbist er Teil der Datenbank. Mitkv = memoryoderkv = valkeyenthält er Caches, Rate-Limit-Zähler und kurzlebigen Zustand, etwa eine Anmeldung, die auf ihren zweiten Faktor wartet. Nach einer Wiederherstellung mit leerem Valkey füllen sich die Caches wieder, die Rate Limits beginnen von vorn, und eine laufende Anmeldung oder ein laufender Sprachanruf muss neu beginnen. - Die Job-Queue (
queue). Mitqueue = dbundqueue = cloudtaskssind die Jobs Teil der Datenbank und kommen mit ihr zurück. Die Tasks von Cloud Tasks tragen nur ein Signal für einen Job der Datenbank; nach einer Wiederherstellung signalisiert der Server die fälligen Jobs innerhalb weniger Minuten erneut. - Logs und Metriken, die der Server nicht zurückliest.
- Der Index einer Suchmaschine, falls du eine hast.
my search rebuilderzeugt ihn aus der Datenbank neu. Wenn du Snapshots der Suchmaschine erstellst, enthalten sie den Text von Beiträgen, auch von Beiträgen, die nach dem Snapshot gelöscht wurden, behandle sie also wie Datenbank-Backups (Volltextsuche).
Der VAPID-Schlüssel von Web Push ist ein Secret der Konfiguration. Ein neuer Schlüssel beendet Push-Benachrichtigungen an jedes bestehende Abo (VAPID-Schlüssel für Web Push), bewahre ihn also mit der Konfiguration auf.
Wie oft und wo
Abschnitt betitelt „Wie oft und wo“- Datenbank: mindestens einmal am Tag und vor jedem Upgrade. Bewahre mehrere Generationen auf, zum Beispiel 7 tägliche, 4 wöchentliche und 3 monatliche Backups, damit sich ein spät bemerkter Fehler noch rückgängig machen lässt. Ein verwaltetes PostgreSQL mit Point-in-Time-Recovery deckt die Tage ab, die seine Aufbewahrung umfasst.
- Medien: jedes Mal zusammen mit der Datenbank (siehe Die Reihenfolge von Datenbank und Medien).
- KEK und Konfiguration: wenn sie sich ändern. Eine KEK-Rotation ist eine Änderung: Sichere den neuen KEK, bevor du ihn verwendest, und bewahre den vorherigen
auf, solange
kek_previousihn aufführt. - Wo: getrennt vom Server und seiner Festplatte, in einer anderen Ausfalldomäne (anderer Rechner, andere Region, anderer Anbieter oder anderes Konto). Ein Backup auf der eigenen Festplatte des Servers überlebt den Verlust dieser Festplatte nicht.
- Verschlüsselung: Das Datenbank-Backup enthält E-Mail-Adressen, Passwort-Hashes und Direktnachrichten; verschlüssle es im Ruhezustand
(ein verschlüsselter Bucket, oder verschlüssle die Datei vor dem Hochladen mit
ageodergpg). Die darin enthaltenen Secrets, etwa die privaten Schlüssel der Actors, sind mit dem KEK verschlüsselt, bewahre den KEK also nie am selben Ort wie die Datenbank-Backups auf: Wer beides erhält, kann jedes Secret lesen. - Aufbewahrung: Ein Backup enthält Daten, die Nutzer gelöscht haben oder die du auf Anfrage gelöscht hast. Lösche alte Generationen nach einem Zeitplan, den deine Datenschutzerklärung nennt.
Sichern
Abschnitt betitelt „Sichern“Der Server kann während eines Backups weiterlaufen. Um ein Backup zu erstellen, das genau einem Zeitpunkt entspricht, zum Beispiel vor einem Upgrade,
wechsle zuerst in den Wartungsmodus: Im Wartungsmodus öffnet my serve keine Datenbankverbindung und schreibt nichts.
my db backup <file> schreibt eine konsistente Kopie der SQLite-Datenbank in eine neue Datei, während der Server weiterläuft.
Die Kopie enthält jeden Schreibvorgang, der vor dem Start des Befehls committet wurde, auch die noch in der -wal-Datei, und keinen danach.
Es ist eine einzelne Datei, kleiner als das Original, weil freie Seiten weggelassen werden. Der Befehl lehnt eine bereits vorhandene Datei ab
und funktioniert nur mit database = sqlite.
my db backup /backup/my-$(date +%Y%m%d%H%M).dbMit Docker Compose führst du ihn im Container des Servers aus. Die Kopie wird innerhalb des Containers geschrieben, schreibe sie also auf das Daten-Volume und verschiebe sie von dort nach draußen:
cd deploy/dockerdocker compose exec -T my my db backup /data/backup.dbdocker run --rm -v my_data:/data -v "$PWD":/backup busybox sh -c 'mv /data/backup.db /backup/my-$(date +%Y%m%d%H%M).db'Kopiere die Datenbankdatei nicht mit cp oder tar, während der Server läuft: Der Datei allein fehlen die Schreibvorgänge, die noch in der -wal-Datei stehen,
und eine Kopie, die mitten in einem Schreibvorgang entsteht, kann beschädigt sein. Eine einfache Kopie ist in Ordnung, wenn kein Prozess die Datenbank geöffnet hat
(der Server ist gestoppt oder im Wartungsmodus); kopiere dann die Dateien -wal und -shm mit.
PostgreSQL
Abschnitt betitelt „PostgreSQL“Verwende pg_dump im Custom-Format, das pg_restore liest. Es liest einen einzelnen Snapshot, der Server kann also weiterlaufen.
pg_dump --format=custom --file=my-$(date +%Y%m%d%H%M).dump "postgres://my:...@db.example/my"Mit dem Compose-Layer compose.postgres.yaml führst du es im Container der Datenbank aus (gib den Layer mit -f oder in COMPOSE_FILE an):
cd deploy/dockerdocker compose exec -T postgres pg_dump --format=custom -U my my > my-$(date +%Y%m%d%H%M).dumpVerwende das pg_dump derselben Hauptversion wie der Server oder einer neueren.
Ein verwaltetes PostgreSQL hat eigene Backups, die für eine große Datenbank die bessere Wahl sind:
- Cloud SQL und Amazon RDS erstellen automatische tägliche Backups und stellen mit aktivierter Point-in-Time-Recovery jede Sekunde innerhalb der Aufbewahrungsdauer wieder her. Aktiviere beides, stelle die Aufbewahrung so ein, dass sie die gewünschten Generationen abdeckt, und erstelle vor jedem Upgrade ein On-Demand-Backup (ein On-Demand-Backup bei Cloud SQL, einen Snapshot bei RDS).
- Ihre Wiederherstellung erzeugt einen neuen Server (oder überschreibt einen): Richte danach
database_urldarauf. - Diese Backups bleiben innerhalb des Kontos des Anbieters. Exportiere hin und wieder zusätzlich ein
pg_dumpan einen Ort außerhalb, damit der Verlust des Kontos nicht die Daten kostet.
Der Blob-Store fs legt jede Datei unter blob_fs_dir ab (/data/blobs mit Compose): die Uploads in objects/ und Dateien, die gerade geschrieben werden, in tmp/.
Kopiere das Verzeichnis, außer tmp/, mit einem beliebigen Werkzeug, das Dateien kopiert (tar, rsync, ein Snapshot des Volumes oder der Festplatte).
Eine Datei wird unter tmp/ geschrieben und dann in einem Schritt nach objects/ umbenannt, daher enthält eine Kopie, die während des Serverbetriebs entsteht, nie eine halbe Datei in objects/.
docker run --rm -v my_data:/data -v "$PWD":/backup busybox \ tar czf /backup/blobs-$(date +%Y%m%d%H%M).tar.gz -C /data --exclude=blobs/tmp blobsrsync auf den Backup-Host hält die Kopie nach dem ersten Mal klein, da sich Mediendateien nach dem Schreiben nie ändern.
Medien in einem Bucket
Abschnitt betitelt „Medien in einem Bucket“Die Blob-Stores s3 und gcs speichern jede Datei als Objekt des Buckets blob_s3_bucket oder blob_gcs_bucket, benannt nach ihrem Schlüssel: die verarbeiteten Medien unter media/,
die Uploads, wie sie empfangen wurden, unter uploads/ und die zwischengespeicherten entfernten Dateien unter remote/. Der Bucket bleibt privat: Der Server liest die
Dateien und liefert sie unter /media/ aus. Ein Objekt erscheint erst, wenn es vollständig geschrieben ist, sodass eine Kopie, die während des Laufs des Servers entsteht, nie
eine halbe Datei enthält. Schütze den Bucket in drei Schichten, von der günstigsten zur sichersten.
Versionierung. Schalte die Objektversionierung des Buckets ein, wo der Dienst sie anbietet (Amazon S3, Google Cloud Storage, MinIO und andere). Ein gelöschtes oder überschriebenes Objekt bleibt dann als nicht aktuelle Version erhalten, und der Bucket kann auf den Zeitpunkt eines Datenbank-Backups zurückgehen.
aws s3api put-bucket-versioning --bucket my-media --versioning-configuration Status=EnabledSetze bei den OpenTofu-Modulen für Amazon S3 und Google Cloud Storage versioning = true: Das schaltet die Versionierung ein und fügt die Regel für nicht aktuelle Versionen
unten hinzu, deren Alter noncurrent_version_days ist (standardmäßig 35). Cloudflare R2 hat keine Objektversionierung, und das Modul für einen anderen S3-kompatiblen Store
erstellt den Bucket nicht, nutze also für diese beiden eine Kopie (unten).
Lifecycle-Regeln. Mit Versionierung behält jede gelöschte Datei ihre Speicherkosten, bis eine Regel sie entfernt. Füge eine Regel hinzu, die nicht aktuelle Versionen nach dem Alter deines ältesten Datenbank-Backups löscht (35 Tage für die Generationen aus Wie oft und wo ohne die monatlichen), sodass jedes Datenbank-Backup, das du behältst, seine Dateien noch findet und eine Datei, die ein Benutzer gelöscht hat, nicht länger bleibt, als deine Datenschutzerklärung sagt. Füge eine Regel hinzu, die unvollständige Multipart-Uploads nach einem Tag abbricht: Der Server bricht einen fehlgeschlagenen Upload einer großen Datei selbst ab, aber ein Prozess, der mittendrin stoppt, hinterlässt seine Teile.
{ "Rules": [ { "ID": "noncurrent-versions", "Status": "Enabled", "Filter": {}, "NoncurrentVersionExpiration": { "NoncurrentDays": 35 }, "AbortIncompleteMultipartUpload": { "DaysAfterInitiation": 1 } } ]}aws s3api put-bucket-lifecycle-configuration --bucket my-media --lifecycle-configuration file://lifecycle.jsonEine Kopie in einem anderen Konto oder einer anderen Region. Versionierung schützt vor einem Versehen, nicht davor, den Bucket oder das Konto zu verlieren, dem er gehört, und die eigenen Zugangsdaten des Servers können Objekte löschen. Bewahre eine Kopie auf, die diese Zugangsdaten nicht erreichen:
-
Replikation. Amazon S3 repliziert einen versionierten Bucket in einen Bucket in einer anderen Region oder einem anderen Konto (Cross-Region oder Same-Region Replication, wobei das Ziel dem anderen Konto gehört). Schalte die Versionierung auch für das Ziel ein und repliziere keine Löschungen (lass die Replikation von Löschmarkierungen aus), damit eine Löschung auf der Instanz die Kopie nicht erreicht. Andere Dienste haben ihre eigene Replikation, etwa die Dual-Region-Buckets von Cloud Storage und die Bucket-Replikation von MinIO.
-
Eine geplante Kopie. Wo es keine Replikation gibt oder um zu einem anderen Anbieter zu kopieren, kopiere den Bucket nach dem Zeitplan des Datenbank-Backups, direkt danach, mit Zugangsdaten, die den Bucket der Instanz nur lesen und nur den Backup-Bucket schreiben können:
Terminal-Fenster rclone copy --checksum source:my-media backup:my-media-backuprclone copyundaws s3 syncohne--deletefügen neue Objekte hinzu und entfernen nie eines aus der Kopie. Dateien ändern sich nie, nachdem sie geschrieben wurden, sodass nach dem ersten Lauf jede Kopie nur die neuen überträgt. Lösche alte Objekte aus der Kopie nach dem Zeitplan deiner Aufbewahrungsrichtlinie oder schalte dort ebenfalls Versionierung und eine Lifecycle-Regel ein.
Zugangsdaten bleiben außerhalb der Kopie: Der Bucket enthält kein Geheimnis, aber die Konfiguration nennt den Schlüssel in blob_s3_access_key_id
und blob_s3_secret_access_key, die zur Konfiguration gehören. Der Blob-Store gcs hält keinen Schlüssel: Er nutzt das Dienstkonto
der Maschine oder von Cloud Run.
Die Reihenfolge von Datenbank und Medien
Abschnitt betitelt „Die Reihenfolge von Datenbank und Medien“Sichere zuerst die Datenbank, dann die Medien, und bewahre beides zusammen als eine Generation auf. Bei einem Bucket ist die Kopie oder die Replikation, die nach dem Datenbank-Backup läuft, das Medien-Backup; mit Versionierung sind es die Versionen zum Zeitpunkt des Datenbank-Backups.
Die Datenbank nennt die Mediendateien, die sie verwendet, und die Medienkopie entsteht einen Moment später. In diesem Moment:
- Neue Uploads können in der Medienkopie landen, ohne dass es eine Zeile in der Datenbankkopie gibt. Das sind Dateien, die niemand verwendet; sie belegen Platz und schaden nicht.
- Eine Datei, die nach dem Datenbank-Backup gelöscht wurde (die Medien eines gelöschten Beitrags, ein Upload, der nie angehängt wurde), steht in der Datenbankkopie, aber nicht in der Medienkopie.
Nach einer Wiederherstellung antwortet diese Datei mit
404, und der Beitrag, der sie zeigte, zeigt ein fehlendes Bild.
Die andere Reihenfolge ist schlimmer: Jede Datei, die zwischen dem Medien-Backup und dem Datenbank-Backup hochgeladen wurde, würde nach einer Wiederherstellung fehlen, auch die Medien neuer Beiträge. Beides im Wartungsmodus zu sichern vermeidet jede der Lücken.
Auf den OpenTofu-Zielen
Abschnitt betitelt „Auf den OpenTofu-Zielen“Die Module halten kein eigenes Backup über das hinaus, was der Anbieter bietet: Das verwaltete PostgreSQL von Cloud SQL und RDS hat automatische Backups mit einer Aufbewahrung, die du festlegst, während eine Datenbank mit nur der Historie des Anbieters (Neon) nur so weit zurückgehen kann, wie diese Historie reicht. Plane diese selbst, mit Zugangsdaten, die die Instanz nicht besitzt:
- Die Datenbank, jeden Tag. Führe
pg_dumpgegen das PostgreSQL der Instanz von einer Maschine oder einem geplanten Job außerhalb des Anbieters aus, der die Datenbank hostet (siehe PostgreSQL), verschlüssele den Dump und schreibe ihn in einen Bucket eines anderen Kontos oder Anbieters. Behalte die Generationen aus Wie oft und wo. Der Job braucht diedatabase_urlund sonst nichts; er darf den KEK nicht besitzen. - Die Medien, direkt danach. Mit
versioning = trueam Bucket-Modul sind die Versionen die Kopie für die letztennoncurrent_version_days; führe für den Verlust des Kontos außerdemrclone copyvom Bucket der Instanz in einen Bucket an anderer Stelle aus, wie unter Medien in einem Bucket, nach dem Zeitplan des Datenbank-Dumps. - Der KEK und die Konfiguration gehören nicht zum Zeitplan: Sichere sie, wenn sie sich ändern (Der KEK und die Konfiguration).
Der KEK und die Konfiguration
Abschnitt betitelt „Der KEK und die Konfiguration“Der KEK liegt nicht in der Datenbank. Sichere ihn einmal, getrennt von den Datenbank-Backups, wie Den Key-Encryption-Key verwalten
beschreibt, und erneut nach jeder Rotation. Bewahre eine Kopie der Konfiguration (die Umgebung, die Konfigurationsdatei, .env und die Secret-Dateien)
mit deinen Deployment-Dateien auf, ohne den KEK.
Wiederherstellen
Abschnitt betitelt „Wiederherstellen“Ein Backup enthält host und account_domain seines Servers. Starte die wiederhergestellte Datenbank mit denselben Werten: Bei anderen weigert sich der Server zu starten.
Stelle in eine leere Umgebung wieder her (ein neuer Rechner, neue Volumes oder eine neue Datenbank), in dieser Reihenfolge: die Datenbank, die Medien (das Verzeichnis oder der Bucket),
dann die Konfiguration mit demselben KEK (und demselben kek_previous), der beim Erstellen des Backups in Verwendung war. Starte dann den Server wie üblich.
Stoppe den Server, lege die Backup-Datei anstelle der Datenbankdatei ab und entferne die alten -wal- und -shm-Dateien, falls welche übrig sind.
Mit Docker Compose in das Volume my_data (ein vorhandenes oder ein neues auf einem anderen Rechner):
cd deploy/dockerdocker compose down # keeps the volume; on a new machine, `docker compose up --no-start` creates itdocker run --rm -v my_data:/data -v "$PWD":/backup busybox sh -c ' rm -rf /data/my.db /data/my.db-wal /data/my.db-shm /data/blobs && cp /backup/my-202601010000.db /data/my.db && tar xzf /backup/blobs-202601010000.tar.gz -C /data && chown -R 65532:65532 /data'docker compose up -dDas Server-Image läuft als Benutzer 65532, dem die Dateien des Volumes gehören müssen (das chown oben).
PostgreSQL
Abschnitt betitelt „PostgreSQL“Stelle in eine neue, leere Datenbank wieder her, die wie für einen neuen Server vorbereitet ist, aber ohne das Schema anzuwenden: Der Dump enthält es.
-
Erstelle die Rolle und die Datenbank.
-
Stelle den Dump wieder her. Als Superuser behalten die wiederhergestellten Tabellen ihren Eigentümer (die Rolle muss existieren); als Datenbankeigentümer füge
--no-ownerhinzu.Terminal-Fenster pg_restore --exit-on-error --dbname="postgres://postgres:...@db.example/my" my-202601010000.dump -
Mit dem eigenen Backup einer verwalteten Datenbank stellst du stattdessen auf die Weise des Anbieters wieder her und richtest
database_urlauf die wiederhergestellten Server.
Mit dem Compose-Layer compose.postgres.yaml startest du nur die Datenbank, auf einem neuen Volume, und stellst darin wieder her. Der Container hat die Rolle und die Datenbank erstellt:
cd deploy/dockerdocker compose up -d --wait postgresdocker compose exec -T postgres pg_restore --exit-on-error --no-owner -U my -d my < my-202601010000.dumpdocker compose up -dUm stattdessen über eine bestehende Datenbank wiederherzustellen (ein Upgrade zurückrollen), verwende pg_restore --clean --if-exists, wie Zurückrollen zeigt.
Entpacke die Medienkopie nach blob_fs_dir, bevor der Server startet, mit dem Benutzer als Eigentümer, unter dem der Server läuft.
Medien in einem Bucket
Abschnitt betitelt „Medien in einem Bucket“Stelle die Objekte in einem leeren Bucket wieder her, bevor der Server startet, und setze dann blob_s3_bucket (und den Endpoint, die Region und die Zugangsdaten) oder blob_gcs_bucket darauf.
Die Schlüssel müssen gleich bleiben: Die Datenbank benennt jede Datei nach ihrem Schlüssel.
-
Aus einer Kopie in einem anderen Bucket kopierst du sie zurück:
Terminal-Fenster rclone copy --checksum backup:my-media-backup target:my-media-restored -
Aus den Versionen des eigenen Buckets des Servers kopierst du die Objekte, wie sie zum Zeitpunkt des Datenbank-Backups waren, in einen neuen Bucket.
rcloneliest die Versionen dieses Zeitpunkts mit--s3-version-at:Terminal-Fenster rclone copy --s3-version-at "2026-01-01 00:00:00" source:my-media target:my-media-restored -
Aus einem Replikat richtest du
blob_s3_bucketoderblob_gcs_bucketauf das Replikat oder kopierst es in einen Bucket im ursprünglichen Konto zurück.
Die Zugangsdaten des Servers müssen Objekte des wiederhergestellten Buckets lesen, schreiben und löschen können (s3:GetObject, s3:PutObject, s3:DeleteObject
und s3:AbortMultipartUpload bei Amazon S3; die Rolle roles/storage.objectUser auf dem Bucket bei Google Cloud Storage).
Starten und prüfen
Abschnitt betitelt „Starten und prüfen“Starte den Server auf die übliche Weise. Mit Docker Compose führt docker compose up -d zuerst my db upgrade -check, das Schema und my db upgrade aus;
bei einem Backup derselben Version ändern sie nichts. Prüfe dann:
/readyzantwortet mit200, und der Server protokolliert keinen Fehlerunknown key-encryption key.my projection verifymeldet keinen Unterschied (Projektionen prüfen und neu aufbauen).- Du kannst dich anmelden, und die neuesten Beiträge und ihre Medien werden angezeigt.
- Die Schlüssel der Actors haben sich nicht geändert: Der
publicKey.publicKeyPemeines Actors (curl -H 'Accept: application/activity+json' https://<host>/ap/actors/<id>) ist derselbe wie vor der Wiederherstellung. Andere Server prüfen die Signaturen des Servers mit diesem Schlüssel, ein unveränderter Schlüssel bedeutet also, dass die Föderation dort weitergeht, wo sie stehen geblieben ist. - Ein Beitrag, ein Follow oder ein Entfolgen erreicht einen anderen Server (ein Testkonto auf einem anderen Server sieht es).
Schreibvorgänge nach dem Backup gehen verloren: Beiträge, Follows und Uploads seitdem sind auf diesem Server weg, während andere Server die Aktivitäten, die sie erhalten haben, möglicherweise noch haben. Das lässt sich von hier aus nicht reparieren; stelle aus dem neuesten Backup wieder her, das du hast.
Mit einer Suchmaschine führst du nach der Wiederherstellung my search rebuild aus, ohne --keep, damit Beiträge, die neuer sind als das Backup, den Index verlassen (Volltextsuche).
Ohne den richtigen KEK
Abschnitt betitelt „Ohne den richtigen KEK“- Kein KEK: Der Server startet nicht.
my serveund die anderenmy-Befehle, die die Konfiguration lesen, brechen damit ab, mitThe required setting MY_KEK is not set.undkek: required when key_manager is local. - Ein anderer KEK: Der Server startet und antwortet auf
/readyz, aber alles, was ein mit dem alten KEK verschlüsseltes Secret liest, schlägt mitunknown key-encryption keyund der Schlüssel-ID des alten KEK fehl (local key manager: key "local:…" is not configured): Zustellungen an andere Server und signierte Abrufe (die privaten Schlüssel der Actors), Anmeldungen mit Zwei-Faktor-Authentifizierung, Webhook-Signaturen und die externen Anmeldeanbieter. Auch zuvor ausgestellte Media-Proxy-URLs funktionieren nicht mehr. Passwörter und Beiträge sind nicht mit dem KEK verschlüsselt, daher funktionieren die Anmeldung mit Passwort und das Lesen von Beiträgen weiter, was das Problem anfangs verbergen kann: Beobachte das Log auf den Fehler. - Finde den KEK, dessen Schlüssel-ID der Fehler nennt, setze ihn als
kek(oder inkek_previous) und starte neu. Ein Secret lässt sich ohne seinen KEK nicht wiederherstellen; wenn der KEK endgültig verloren ist, müssen die Schlüssel der Actors neu erzeugt werden, und andere Server sehen jeden Actor als neuen Schlüssel für dasselbe Konto.
Wiederherstellungsübung
Abschnitt betitelt „Wiederherstellungsübung“Von einem Backup weißt du erst, dass es funktioniert, wenn es wiederhergestellt wurde. Übe eine Wiederherstellung, bevor die Instanz öffentlich wird, und erneut nach einer Änderung daran, wie Backups erstellt werden (mindestens alle paar Monate):
-
Erstelle wie oben ein Backup der laufenden Instanz: die Datenbank, dann die Medien.
-
Stelle es auf einer anderen Maschine oder in einem anderen Compose-Projekt mit dem KEK und der Konfiguration von dem Ort wieder her, an dem du sie aufbewahrst (nicht vom laufenden Server kopiert), und mit unverändertem
host, damit die URLs der Akteure übereinstimmen. -
Lass die Kopie nicht föderieren. Setze
role = web, was keinen Job-Worker ausführt: Die mit der Datenbank wiederhergestellten Jobs enthalten Zustellungen, die beim Backup fällig waren, und eine Kopie, die sie ausführt, signiert sie mit den Schlüsseln der echten Akteure und sendet sie erneut an andere Server. Die Kopie vom Internet fernzuhalten, genügt nicht, da es schwer zu garantieren ist. Schalte den Wartungsmodus ein, sobald die folgenden Prüfungen bestanden sind, wenn du sie weiterlaufen lässt. -
Gib der Kopie außerhalb von Compose, zum Beispiel auf einer lokalen Maschine gegen eine Cloud-Instanz, diese Einstellungen, damit sie nichts von der laufenden Instanz berührt:
Einstellung Wert in der Kopie Warum rolewebFührt keinen Job aus, sodass nichts Wiederhergestelltes erneut zugestellt wird queuedbIn der Kopie eingereihte Jobs bleiben in ihrer Datenbank, statt die laufende Queue zu erreichen streampostgresTritt dem laufenden Ereignisstrom der Instanz nicht bei mailnoneSendet keine E-Mails an echte Benutzer der Blob-Store ein neuer Bucket (oder ein Verzeichnis) mit den wiederhergestellten Medien Lässt den laufenden Bucket unberührt database_urldie wiederhergestellte Datenbank Nie die laufende der KEK ( MY_KEKoderkey_managerundkms_key)wie live, von dem Ort, an dem du ihn aufbewahrst Ohne ihn startet die Kopie nicht hostwie live Damit die URLs der Akteure übereinstimmen -
Gehe Starten und prüfen durch: Anmelden, Beiträge und Medien sowie der
publicKeyeiniger Akteure im Vergleich mit der laufenden Instanz. -
Starte sie einmal ohne den KEK und einmal mit einem anderen und prüfe, dass sie fehlschlägt, wie Ohne den richtigen KEK beschreibt.
-
Notiere, wie lange jeder Schritt gedauert hat: So lange hält eine echte Wiederherstellung die Instanz außer Betrieb.
Für LLMs und Coding-Agenten:llms.txt,llms-full.txt, llms-small.txt