

Diese Seite ist eine maschinelle Übersetzung der englischen Seite, die maßgeblich ist. Englische Seite lesen
Datenbank: initialisieren, upgraden und neu anlegen
Wie Betreiber die Datenbank anlegen, auf ein neues Release upgraden und, nur auf Entwicklungs- und Testinstanzen, löschen.
Das Schema liegt in schema/, ein Verzeichnis pro Modul mit einer Datei pro Datenbank (schema/<NN>-<module>/sqlite.sql und postgres.sql). Die Server-Binary enthält das Schema ihres Releases, und
my schema apply wendet es an: Jedes Deployment führt es als einmaligen Job vor dem Server aus, mit dem Server-Image und den Datenbankeinstellungen des Servers, sodass das Server-Image das einzige Image ist, das ein Server braucht.
my serve wendet das Schema nie an. Wird der Server auf einer Datenbank ohne Schema gestartet, antwortet er auf /readyz mit 503 (siehe Den Server starten).
Daten, die eine Schemaänderung übernehmen muss (eine Spalte, die in zwei aufgeteilt wird, ein Wert, der in eine neue Tabelle wandert), schreibt das
my db upgrade des Server-Images um, das einmal pro Release läuft, nachdem das Schema angewendet wurde. Die vollständige Reihenfolge steht unter Upgrade.
Initialisieren (das Schema anwenden)
Abschnitt betitelt „Initialisieren (das Schema anwenden)“my schema apply führt nur die Anweisungen aus, die die Datenbank auf das Schema ihres Releases bringen: Auf einer leeren Datenbank legt es alles an,
auf einer aktuellen tut es nichts. Es kann beliebig oft gefahrlos ausgeführt werden, und jedes Upgrade führt es erneut aus.
Mit my schema apply
Abschnitt betitelt „Mit my schema apply“my schema apply liest die Datenbankeinstellungen der Konfiguration des Servers (database, database_url und database_dev_url,
aus -config <file> oder der Umgebung; andere Einstellungen braucht es nicht) und bringt die Datenbank auf das Schema des Releases der Binary:
my schema apply -dry-run # print the SQL statements it would run, and change nothingmy schema apply # run them- Es gibt die SQL-Anweisungen aus, die es ausführt, und führt sie in einer Transaktion aus: Schlägt eine fehl, bleibt keine davon bestehen.
Eine Datenbank, die bereits zum Schema passt, bleibt unverändert (
ok: the database matches the schema; nothing to apply). - Ein Plan, der eine Tabelle oder Spalte löscht, wird abgelehnt, und nichts läuft, es sei denn,
-allow-destructiveist angegeben. Gib es nur an, wenn die Release Notes es verlangen, und nach einem Backup. Eine SQLite-Tabelle zur Änderung neu aufzubauen, zählt nicht als Löschen. - Bei PostgreSQL baut es das Schema, mit dem es vergleicht, in einem temporären Schema derselben Datenbank auf und löscht es am Ende wieder,
auch bei einem Fehler; die Rolle braucht dort das Recht, ein Schema anzulegen. Wo sie es nicht hat, setze
database_dev_urlauf eine andere Datenbank, in der sie es hat (database_dev_url). Läufe gegen dieselbe Datenbank warten aufeinander, sodass zwei gleichzeitige beide erfolgreich sind. - Es unterstützt
database = sqliteunddatabase = postgresund beendet sich mit1, wenn es wegen eines Fehlers oder eines abgelehnten Löschens nichts angewendet hat.
Ab v0.1.0 enthält ein Upgrade zwischen unterstützten Releases nie eine Differenz, die Daten verliert; Releases vor v0.1.0 dürfen Spalten
und Tabellen löschen und brauchen -allow-destructive. Lies das SQL vor jedem Upgrade mit -dry-run (siehe Upgrade).
Über einen Connection-Pooler
Abschnitt betitelt „Über einen Connection-Pooler“my schema apply muss die Datenbank direkt erreichen. Es hält eine Sperre auf Sitzungsebene, die ein Pooler im Transaktionsmodus (das Transaction Pooling von PgBouncer, der gepoolte Connection-String von Neon) nicht aufrechterhält: Über einen solchen blieben zwei gleichzeitige Läufe hängen, statt fehlzuschlagen. Gib ihm eine direkte URL als database_url. pool_max_conns und die anderen pool_*-Parameter dürfen darin bleiben, ebenso in database_dev_url und stream_postgres_url: Die Befehle, die keinen Pool öffnen, ignorieren sie. my db upgrade, my db upgrade -check und die Konsole nehmen dieselbe URL.
my serve kann einen Pooler im Transaktionsmodus verwenden, solange:
- der Pooler Prepared Statements auf Protokollebene beherrscht, die der Server für jede Abfrage nutzt: PgBouncer 1.21 oder neuer mit
max_prepared_statementsüber 0, was der gepoolte Connection-String von Neon hat. Hinter einem Pooler ohne sie schlagen Anweisungen zufällig mitprepared statement ... does not existoderalready existsfehl: Fügedefault_query_exec_mode=execzur URL hinzu, was sie um den Preis eines zusätzlichen Roundtrips pro Abfrage vermeidet. stream_postgres_urleine direkte URL enthält, wennstream = postgres, daLISTENzu einer Sitzung gehört. Ein Listener auf einer gepoolten URL verbindet sich und empfängt dann nichts.- die URL keinen
search_pathoder anderen Parameter enthält, den der Pooler beim Verbindungsaufbau ablehnt: PgBouncer schließt eine solche Verbindung, außerignore_startup_parameterslistet ihn auf.
Docker Compose
Abschnitt betitelt „Docker Compose“In deploy/docker/compose.yaml laufen drei einmalige Dienste des Server-Images in dieser Reihenfolge, jeder erst,
nachdem der vorherige erfolgreich war, und der Server (my) startet zuletzt:
| Dienst | Führt aus |
|---|---|
upgrade-check |
my db upgrade -check (läuft auf einer leeren Datenbank durch) |
schema |
my schema apply, auf /data/my.db oder, mit der Ebene compose.postgres.yaml, auf dessen PostgreSQL (Docker-Compose-Dateien) |
upgrade |
my db upgrade |
cd deploy/dockerdocker compose up -d # pulls the image of MY_VERSION; the three one-off services run in order, then my startscurl -fsS localhost:8080/readyz # ready when it answers {"status":"ok"}docker compose exec -T my my admin create -username alice -email alice@example.com < password.txt- Wenn einer der drei fehlschlägt, startet
mynicht. Lies seine Ausgabe mitdocker compose logs upgrade-check(oderschema,upgrade). - Das Anlegen von Administratoren steht unter Administratoren und Rollen.
Andere Plattformen
Abschnitt betitelt „Andere Plattformen“Führe ohne Compose my schema apply des Server-Images als einmaligen Job aus (ein Kubernetes Job oder Init-Container, ein Cloud-Run-Job und so weiter),
mit denselben Datenbankeinstellungen wie der Server:
# SQLite: mount the volume that holds the database file at /datadocker run --rm -v my_data:/data -e MY_DATABASE=sqlite -e MY_DATABASE_URL=/data/my.db my schema apply
# PostgreSQLdocker run --rm -e MY_DATABASE=postgres -e MY_DATABASE_URL='postgres://my:...@db.example/my' my schema apply
Der Connection-Pool
Abschnitt betitelt „Der Connection-Pool“Der Pool von PostgreSQL folgt den pool_*-Parametern von database_url: pool_max_conns (standardmäßig der größere Wert aus 4 und der CPU-Anzahl) und pool_min_conns, die Verbindungen, die er hält, wenn nichts angefragt wird, wobei pool_max_conn_idle_time (30 Minuten) den Rest schließt. Setze pool_min_conns für eine Instanz, deren Anfragen weit auseinanderliegen, sonst öffnet jede eine Verbindung.
SQLite kennt ebenfalls pool_max_conns, mit demselben Standard, und pool_max_idle_conns, die höchste Anzahl untätiger Verbindungen, die es hält, eine Obergrenze und keine Untergrenze wie pool_min_conns (standardmäßig alle, und keine wird nach Zeit geschlossen, sodass eine ruhige Instanz sofort antwortet). Eine neue Verbindung liest das Schema ein, bevor sie ihre erste Abfrage ausführt, weshalb der Pool seine Verbindungen behält.
Upgrade
Abschnitt betitelt „Upgrade“Ein Upgrade auf ein neues Release führt immer diese Schritte in dieser Reihenfolge aus, mit dem Server-Image des neuen Releases:
- Sichere die Datenbank (und beim Dateisystem-Blob-Store die Medien). Siehe Backup.
my db upgrade -check. Es ändert nichts. Es endet mit1, wenn das neue Schema Daten verwerfen würde, die die Datenbank noch nicht übernommen hat, und nennt das Release, über das du zuerst upgraden musst; halte dann an und folge Releases überspringen. Eine leere Datenbank besteht die Prüfung.my schema apply, wie unter Initialisieren. Prüfe das SQL vorher mit-dry-run.my db upgrade. Es führt jeden Datenupgrade-Schritt des Releases aus, den die Datenbank noch nicht verzeichnet hat, baut die Projektionen neu auf, die diese Schritte nennen, und verzeichnet jeden Schritt. Erneut ausgeführt, tut es nichts. Schlägt ein Schritt fehl, endet es mit1; die abgeschlossenen Schritte bleiben verzeichnet, und ein erneuter Lauf setzt beim fehlgeschlagenen fort.- Starte den neuen Server. Er antwortet auf
/readyzmit503und loggt die fehlenden Schritte, bis jeder Datenupgrade-Schritt seines Releases verzeichnet ist.
my serve führt nie my db upgrade -check, my schema apply oder my db upgrade aus; sie sind einmalige Jobs. Führe immer nur einen davon gleichzeitig gegen eine Datenbank aus.
Die Schritte in einem Job ausführen
Abschnitt betitelt „Die Schritte in einem Job ausführen“my upgrade führt die Schritte 2 bis 4 in einem Prozess aus, nach den Prüfungen von my config check, sodass ein einziger einmaliger Job (eine Cloud-Run-Job-Ausführung, ein ECS-Task, ein Kubernetes Job) die gesamte Migration trägt:
my config checkmy db upgrade -checkmy schema apply, mit-allow-destructive, wennmy upgradees erhältmy db upgrade
Es hält beim ersten fehlgeschlagenen Schritt an und endet mit dem Code dieses Schritts; die späteren Schritte laufen nicht. Jeder Schritt gibt eine Zeile aus, die ihn nennt,
etwa ==> my schema apply, und danach die Ausgabe dieses Befehls, sodass das Log des Jobs zeigt, wo er angehalten hat. Führe nach der Behebung der Ursache
my upgrade erneut aus: Die abgeschlossenen Schritte finden nichts mehr zu tun. -config <file> wird an jeden Schritt weitergegeben.
my upgrade -dry-run führt my config check, my db upgrade -check und my schema apply -dry-run aus und ändert nichts: Lies das SQL, das es
ausgibt, vor dem Upgrade. Sichere die Datenbank vor my upgrade, wie in Schritt 1; es schaltet weder in den Wartungsmodus noch startet es
den Server.
Die meisten Releases fügen keinen Datenupgrade-Schritt hinzu: my db upgrade -check gibt ok: the database can be upgraded to this release aus und, bei einer
Datenbank, die die Schritte der früheren Releases verzeichnet hat, gibt my db upgrade ok: no data upgrade step to run aus. Eine neue Datenbank verzeichnet
jeden Schritt des Releases bei ihrem ersten my db upgrade, ohne etwas umzuschreiben. Führe beide trotzdem aus, damit das Vorgehen nicht davon abhängt, jede
Release Note zu lesen.
Der Abschnitt Upgrade der Release Notes listet die Schritte jedes Releases auf.
Der Server während eines Upgrades
Abschnitt betitelt „Der Server während eines Upgrades“Upgrades ohne Ausfallzeit sind nicht garantiert. Der vorherige Server arbeitet in der kurzen Zeit zwischen den Schritten 3 und 5 auf dem neuen Schema weiter,
kann aber an den Datenupgrade-Schritten nicht teilnehmen. Schalte für das Upgrade in den Wartungsmodus: Im Wartungsmodus
öffnet my serve keine Datenbankverbindung, daher ist das Backup konsistent, und nichts schreibt, während die Schritte laufen.
Halte das Wartungsfenster auf wenige Stunden begrenzt (wie lange).
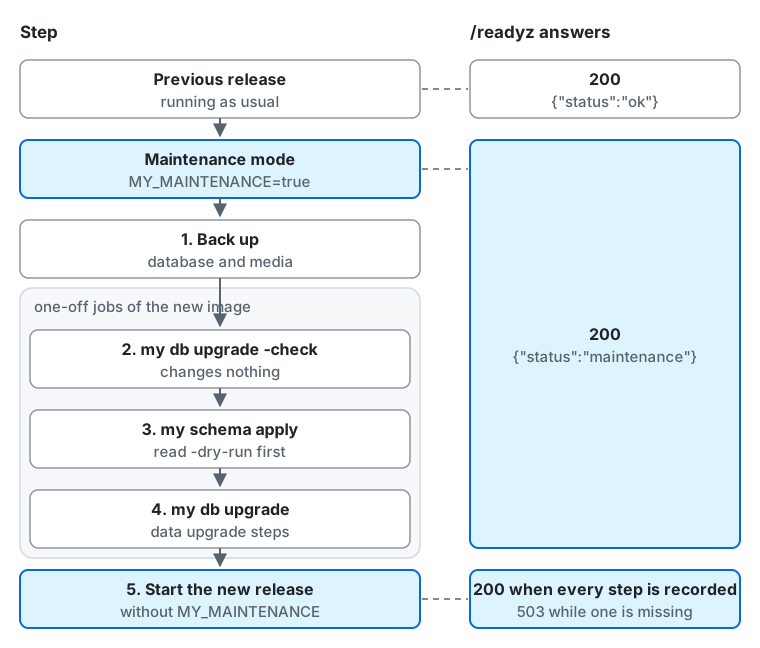
Vom oberen Rand des Diagramms nach unten:
- Vorheriges Release. Der Server läuft wie gewohnt, und
/readyzantwortet mit200und{"status":"ok"}. - Wartungsmodus. Führe das Deployment mit
MY_MAINTENANCE=trueerneut aus. Von jetzt an, bis das neue Release startet, antwortet/readyzmit200und{"status":"maintenance"}, sodass der Load Balancer die Server behält, während nichts die Datenbank erreicht. - 1. Sichere die Datenbank und die Medien.
- 2 bis 4: die einmaligen Jobs des neuen Images.
my db upgrade -checkändert nichts;my schema applyläuft, nachdem du sein-dry-rungelesen hast;my db upgradeführt die Datenupgrade-Schritte aus. - 5. Starte das neue Release ohne
MY_MAINTENANCE./readyzantwortet mit200und{"status":"ok"}, sobald jeder Datenupgrade-Schritt des Releases aufgezeichnet ist, und mit503, solange einer fehlt (oder das Schema nicht angewendet ist).
Mit Docker Compose ersetzt docker compose up den Container im Wartungsmodus, bevor die einmaligen Jobs laufen, sodass während der Schritte 2 bis 4 nichts
auf /readyz antwortet (Docker Compose).
Das SQL mit -dry-run prüfen
Abschnitt betitelt „Das SQL mit -dry-run prüfen“Bevor Schritt 3 irgendetwas anwendet, führe my schema apply -dry-run aus und lies, was es ausführen würde.
Ergänzungen (CREATE TABLE, ADD COLUMN, CREATE INDEX) sind das, was die meisten Releases enthalten. Eine Projektionstabelle kann auch neu aufgebaut werden,
was my db upgrade dann aus ihren Events neu füllt. Ein DROP von sonst etwas oder eine Typänderung sollte im Abschnitt Breaking changes
der Release Notes stehen; wenn nicht, halte an und melde es, bevor du es anwendest. my schema apply lehnt einen Plan ab, der eine Tabelle
oder Spalte löscht, es sei denn, -allow-destructive ist angegeben.
Docker Compose
Abschnitt betitelt „Docker Compose“docker compose up -d führt die Schritte 2 bis 5 selbst aus, in dieser Reihenfolge (siehe die Tabelle unter Initialisieren). Wenn einer davon fehlschlägt, startet der neue Server nicht.
cd deploy/docker
# 1. Switch to the maintenance mode. --no-deps keeps the one-off services from running.MY_MAINTENANCE=true docker compose up -d --no-deps --force-recreate my
# 2. Back up the volume (database and media) while the maintenance mode holds no connection.docker run --rm -v my_data:/data -v "$PWD":/backup busybox tar czf /backup/my-data-$(date +%Y%m%d%H%M).tar.gz -C /data .
# 3. Set MY_VERSION in .env to the new version (0.2.0, or its digest form 0.2.0@sha256:... from the notes), and pull it.docker compose pull
# 4. Check the SQL that the schema service will run.docker compose run --rm --no-deps upgrade-checkdocker compose run --rm --no-deps schema schema apply -dry-run
# 5. Upgrade: upgrade-check, schema, upgrade, then my starts again without the maintenance mode.docker compose up -dcurl -fsS localhost:8080/readyz
docker compose up ersetzt den Container my, bevor die einmaligen Dienste laufen, und startet den neuen erst, nachdem alle drei erfolgreich waren.
Schlägt einer fehl, meldet docker compose up das, und der Server bleibt angehalten: Stelle in der Zwischenzeit die exportierte Wartungsseite davor.
Lies docker compose logs <service> und behebe dann entweder die Ursache und führe docker compose up -d erneut aus oder gehe zurück.
Der Volume-Name my_data ist der Compose-Projektname (my) gefolgt vom Volume-Namen (data).
MY_VERSION ist das Einzige, was ein Upgrade ändert, und nichts ändert es für dich: Es gibt kein Tag latest, und 0.1 bewegt sich nur innerhalb von v0.1. Mit MY_VERSION=0.1 ist Schritt 3 allein docker compose pull, und er holt den neuesten Patch.
Um stattdessen aus dem Quellcode zu bauen, checke das Tag des neuen Releases aus und nutze in Schritt 3 docker compose -f compose.yaml -f compose.build.yaml build und in den anderen Schritten dieselben -f-Optionen.
Kubernetes
Abschnitt betitelt „Kubernetes“Führe die Schritte 2 bis 4 als einen Job aus, bevor du das neue Image ausrollst. Init-Container laufen nacheinander, jeder erst, nachdem der vorherige erfolgreich war, und der Haupt-Container läuft zuletzt, sodass ein Fehler den Job vor dem nächsten Schritt anhält. Gib den Containern dieselbe Konfiguration wie dem Deployment.
apiVersion: batch/v1kind: Jobmetadata: name: my-upgrade-v0-2-0spec: backoffLimit: 0 template: spec: restartPolicy: Never initContainers: - name: upgrade-check image: ghcr.io/mycroblog/my:0.2.0 args: [db, upgrade, -check] envFrom: [{ secretRef: { name: my-config } }] # the Deployment's settings - name: schema image: ghcr.io/mycroblog/my:0.2.0 args: [schema, apply] envFrom: [{ secretRef: { name: my-config } }] containers: - name: upgrade image: ghcr.io/mycroblog/my:0.2.0 args: [db, upgrade] envFrom: [{ secretRef: { name: my-config } }]kubectl set env deployment/my MY_MAINTENANCE=true && kubectl rollout status deployment/my# back up, and check the SQL with a one-off Pod of the new image: my schema apply -dry-runkubectl apply -f my-upgrade-v0-2-0.yamlkubectl wait --for=condition=complete --timeout=30m job/my-upgrade-v0-2-0kubectl set image deployment/my my=ghcr.io/mycroblog/my:0.2.0kubectl set env deployment/my MY_MAINTENANCE-kubectl rollout status deployment/mySchlägt der Job fehl, zeigt kubectl logs job/my-upgrade-v0-2-0 -c upgrade-check (oder -c schema, -c upgrade) warum, und das Deployment bleibt auf dem vorherigen Image.
Binde bei SQLite auf einem Volume dasselbe Volume im Job ein und halte zuerst die Pods des Deployments an: SQLite erlaubt einen Schreiber.
Cloud Run
Abschnitt betitelt „Cloud Run“Mit dem OpenTofu-Modul ist ein Upgrade ein Apply des neuen Releases, das my upgrade im Migrationsjob ausführt, bevor die Dienste das neue Image
übernehmen, und dort anhält, wenn es fehlschlägt: siehe Auf Cloud Run betreiben. Von Hand:
Cloud-Run-Jobs führen je einen Container aus, lege also pro Schritt einen Job an und führe sie der Reihe nach mit --wait aus, was fehlschlägt, wenn der Job fehlschlägt.
Gib den Jobs dieselben Umgebungsvariablen und Secrets wie dem Dienst.
gcloud run services update my --region=asia-northeast1 --update-env-vars=MY_MAINTENANCE=true# back up (see below)
gcloud run jobs deploy my-upgrade-check --region=asia-northeast1 --image=ghcr.io/mycroblog/my:0.2.0 \  --args=db,upgrade,-check --set-env-vars=... --set-secrets=...gcloud run jobs deploy my-schema --region=asia-northeast1 --image=ghcr.io/mycroblog/my:0.2.0 \  --args=schema,apply --set-env-vars=... --set-secrets=...gcloud run jobs deploy my-upgrade --region=asia-northeast1 --image=ghcr.io/mycroblog/my:0.2.0 \  --args=db,upgrade --set-env-vars=... --set-secrets=...
gcloud run jobs execute my-upgrade-check --region=asia-northeast1 --wait &&  gcloud run jobs execute my-schema --region=asia-northeast1 --wait &&  gcloud run jobs execute my-upgrade --region=asia-northeast1 --wait &&  gcloud run deploy my --region=asia-northeast1 --image=ghcr.io/mycroblog/my:0.2.0 --remove-env-vars=MY_MAINTENANCE
Um das SQL vorher zu prüfen, deploye den Schema-Job mit --args=schema,apply,-dry-run, führe ihn aus und lies seine Logs, bevor du ihn für das Apply erneut deployst.
Erstelle das Backup, nachdem der Server aufgehört hat zu schreiben (im Wartungsmodus oder angehalten), und vor jedem Schritt des Upgrades. Backup und Wiederherstellung behandelt jeden Teil vollständig; für ein Upgrade:
-
SQLite: Kopiere die Datenbankdatei zusammen mit ihren Dateien
-walund-shm, während kein Prozess sie geöffnet hat. Mit Compose deckt dastardes Volumes oben auch die Medien in/data/blobsab. -
PostgreSQL:
pg_dumpim Custom-Format, daspg_restoreliest.Terminal-Fenster pg_dump --format=custom --file=my-$(date +%Y%m%d%H%M).dump "postgres://my:...@db.example/my"Das eigene Backup einer verwalteten Datenbank (ein On-Demand-Backup von Cloud SQL, ein RDS-Snapshot) funktioniert ebenfalls; erstelle es zum selben Zeitpunkt.
-
Medien: Der Dateisystem-Blob-Speicher ist ein Verzeichnis, das mit der Datenbank kopiert wird.
-
Der KEK liegt nicht in der Datenbank. Behalte ihn dort, wo er bereits ist; eine wiederhergestellte Datenbank braucht denselben KEK.
Zurückgehen
Abschnitt betitelt „Zurückgehen“Es gibt keine Rückwärts-Migrationen. Um zurückzugehen, stelle das Backup wieder her, das vor dem Upgrade erstellt wurde, und starte dann das vorherige Release:
- Halte den neuen Server an (oder schalte ihn in den Wartungsmodus).
- Stelle das Backup wieder her: Entpacke mit Compose das Archiv in das geleerte Volume
(
docker run --rm -v my_data:/data -v "$PWD":/backup busybox sh -c 'rm -rf /data/* && tar xzf /backup/<archive> -C /data'); bei PostgreSQL mitpg_restore --clean --if-exists --dbname=<url> <dump>. - Starte das Image des vorherigen Releases (setze mit Compose
MY_VERSIONzurück auf die vorherige Version und führe danndocker compose up -daus).
Alles, was das neue Release nach dem Upgrade geschrieben hat, geht verloren, also gehe bald nach dem Upgrade zurück, bevor der Server viel föderiert.
Releases überspringen
Abschnitt betitelt „Releases überspringen“Jedes Release unterstützt Upgrades von derselben Minor-Version (zum Beispiel v0.2.1 auf v0.2.4) und vom neuesten Patch-Release der vorherigen
Minor-Version (das neueste v0.1.x auf v0.2.y). Patch-Releases entfernen nie Spalten oder Tabellen, daher funktioniert innerhalb einer Minor-Version jede Reihenfolge.
Um mehr als eine Minor-Version zu überbrücken, upgrade nacheinander über das neueste Patch-Release jeder Minor-Version und führe jedes Mal das gesamte Vorgehen aus.
Von v0.1.3 auf v0.4.0 zum Beispiel: das neueste v0.1.x, dann das neueste v0.2.x, dann das neueste v0.3.x, dann v0.4.0.
my db upgrade -check stoppt einen Sprung, der Daten verlieren würde, und nennt das Release, über das du gehen musst; zu diesem Zeitpunkt hat sich nichts geändert.
Projektionen prüfen und neu aufbauen
Abschnitt betitelt „Projektionen prüfen und neu aufbauen“Manche Tabellen sind Projektionen: Der Server leitet sie aus den Events und Ressourcen ihres Moduls ab (die Einschränkungen eines Kontos aus seinen Moderationsaktionen, zum Beispiel). Der Worker prüft jede Projektion einmal am Tag und korrigiert jede Differenz, die er findet. So prüfst oder korrigierst du eine von Hand:
my projection list # each projection with its module and tablesmy projection verify [<name>] # derive every projection, or the one named, and print the rows that differ; changes nothingmy projection rebuild [<name>] # derive them the same way and write the difference<name>ist eine Projektion oder eine ihrer Tabellen.verifygibt die Zeilen aus, die die Tabellen enthalten, die Quellen aber nicht ableiten (-), und die Zeilen, die die Quellen ableiten, die Tabellen aber nicht haben (+), und beendet sich mit1, wenn irgendeine abweicht.rebuildschreibt höchstens 500 Zeilen pro Transaktion, sodass Leser nie eine geleerte Projektion sehen. Führe es aus, während der Server ruhig ist: Eine Zeile, die sich während des Neuaufbaus ändert, behält ihren neuen Wert, und ein späteresverifymeldet jede verbleibende Differenz.
Neu anlegen (jede Zeile löschen)
Abschnitt betitelt „Neu anlegen (jede Zeile löschen)“Neu anlegen heißt, die Datenbank zu leeren und das Schema erneut anzuwenden. Ab v0.1.0 ist das Neuanlegen nur für Entwicklungs- und Testinstanzen gedacht.
Lege nie einen öffentlichen Server neu an, der mit anderen Servern föderiert.
Jede Zeile geht verloren und lässt sich nicht wiederherstellen. Auch die mit dem Key Encryption Key (KEK) verpackten Kontoschlüssel gehen verloren, sodass ein unter demselben Hostnamen neu angelegtes Konto einen anderen Schlüssel bekommt und für andere Server ein anderer Actor ist, und seine Follow-Beziehungen zu entfernten Konten kommen nicht zurück. Ein öffentlicher Server, der eine Schemaänderung nicht anwenden kann, geht stattdessen aus ihrem Backup zurück.
Es gibt keinen my-Befehl, der eine Datenbank löscht: Entferne sie mit den Werkzeugen der Datenbank und wende dann das Schema erneut an.
Die leere Datenbank hat kein aufgezeichnetes host und account_domain, daher zeichnet der nächste Start die konfigurierten Werte auf.
Docker Compose
Abschnitt betitelt „Docker Compose“cd deploy/dockerdocker compose stop my # stop the serverdocker run --rm -v my_data:/data busybox rm -f /data/my.db /data/my.db-wal /data/my.db-shmdocker compose up -d # the one-off services apply the schema to the empty database, then my starts- Hochgeladene und verarbeitete Medien (
/data/blobs) bleiben erhalten. Um sie zusammen mit der Datenbank zu löschen, entferne das benannte Volume mitdocker compose down -vund führe danndocker compose up -daus. Ohne-vbleibt das Volume erhalten. - Um vorher eine Kopie zu behalten, halte den Server an und kopiere
my.db(mit seinen Dateien-walund-shm) aus dem Volume.
PostgreSQL
Abschnitt betitelt „PostgreSQL“Lösche die Datenbank und lege sie leer mit demselben Eigentümer neu an (oder mit der Konsole der verwalteten Datenbank) und führe dann my schema apply aus:
# stop every server and job that uses the database firstdropdb --maintenance-db="postgres://postgres:...@db.example/postgres" mycreatedb --maintenance-db="postgres://postgres:...@db.example/postgres" --owner=my mymy schema applyFür LLMs und Coding-Agenten:llms.txt,llms-full.txt, llms-small.txt