

Diese Seite ist eine maschinelle Übersetzung der englischen Seite, die maßgeblich ist. Englische Seite lesen
Überblick über einen mycroblog-Server
Die erste Seite, die du liest, bevor du einen Server betreibst. mycroblog ist ein Microblog, der über ActivityPub mit dem Rest des Fediverse
föderiert; my ist seine Server-Software, eine einzige Binary, die den Server, den Job-Worker, den Web-Client und die Befehle enthält, die sich um sie
kümmern. Diese Seite zeigt, woraus ein Server besteht, was du per Konfiguration wählst, wie ein kleiner Server zu einem großen wächst
und wo du als Nächstes weiterliest.
Woraus ein Server besteht
Abschnitt betitelt „Woraus ein Server besteht“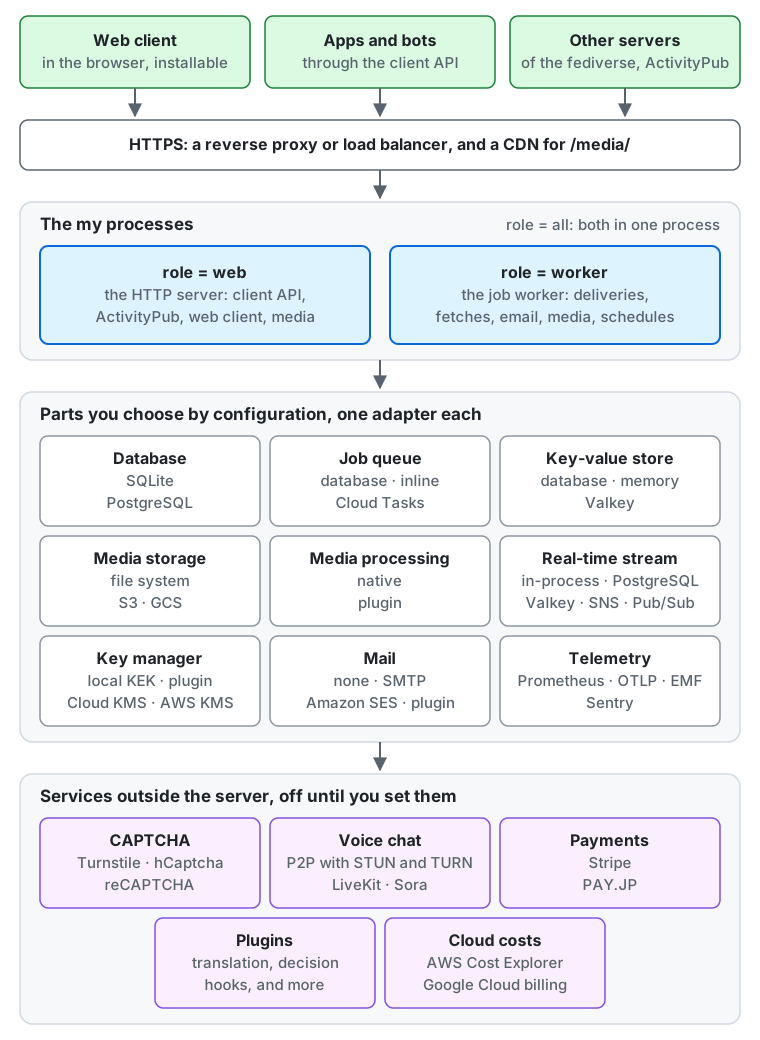
Im Diagramm von oben nach unten:
- Wer sich verbindet. Menschen nutzen den Web-Client in ihrem Browser (er lässt sich als App installieren), Apps und Bots nutzen die Client-API, und andere Fediverse-Server liefern und holen Beiträge über ActivityPub. Alle erreichen den Server über HTTPS.
- Vor dem Server. Standardmäßig spricht
myreines HTTP, daher beendet ein Reverse-Proxy oder Load Balancer HTTPS vor ihm. Auf einer einzelnen Maschine kannmystattdessen selbst HTTPS ausliefern (HTTPS vom Server aus ausliefern). Ein CDN vor den Mediendateien ist optional. - Die
my-Prozesse. Jeder Prozess führtmy serveaus, und seinerolelegt fest, was er ausführt:webden HTTP-Server,workerden Job-Worker, der Beiträge zustellt, von anderen Servern abruft, E-Mails sendet, Medien verarbeitet und die periodischen Jobs ausführt, undall, der Standard, beides in einem Prozess. - Die Teile, die du wählst. Jeder Teil in der Mitte des Diagramms hat eine Einstellung, die seinen Adapter wählt, aufgelistet im nächsten Abschnitt.
- Dienste außerhalb des Servers. CAPTCHA, Sprachchat, Zahlungen, Plugins und der Import der Cloud-Kosten bleiben jeweils aus, bis du sie einstellst, und der Server ruft dann den Dienst auf, den du nennst.
Teile, die du per Konfiguration wählst
Abschnitt betitelt „Teile, die du per Konfiguration wählst“Jeder Teil ist eine Einstellung der Konfigurationsreferenz, gesetzt in einer TOML-Datei oder als
Umgebungsvariable (MY_ und der Schlüssel in Großbuchstaben, etwa MY_DATABASE). Die erste Option jeder Liste ist der Standard.
Wo ein Teil Daten hält, wähle ihn vor dem ersten Start: Die Daten ziehen nicht von selbst um, wenn sich die Einstellung ändert.
| Teil | Einstellung | Optionen | Weiterlesen |
|---|---|---|---|
| Datenbank | database |
sqlite (eine Datei), postgres (PostgreSQL und kompatible Dienste) |
Datenbank, Backup |
| Job-Queue | queue |
db (eine Tabelle in der Datenbank), inline (führt jeden Job sofort im selben Prozess aus, für Tests und Entwicklung), cloudtasks (Google Cloud Tasks weckt den Server für jeden Job; braucht PostgreSQL) |
Die Job-Queue |
| Key-Value-Store, für Caches, Rate Limits und die Antworten, die einen Tag lang für erneut gesendete Schreibvorgänge aufbewahrt werden | kv |
db (eine Tabelle in der Datenbank), memory (jeder Prozess für sich), valkey (Valkey oder ein anderer Server mit Redis-Protokoll, von allen Prozessen geteilt) |
kv |
| Medienspeicher | blob |
fs (ein Verzeichnis), s3 (Amazon S3, Cloudflare R2, MinIO, Garage und andere S3-kompatible Speicher), gcs (Google Cloud Storage) |
Docker-Compose-Dateien, Medien sichern |
| Medienverarbeitung | media_image, media_video, media_audio, je eine für jede Dateiart |
native (im Server), plugin (ein Plugin von dir wandelt die Dateien dieser Art um) |
Medien umwandeln |
| Echtzeit-Stream zwischen Prozessen | stream |
hub (innerhalb eines Prozesses), postgres (LISTEN / NOTIFY), valkey, sns (Amazon SNS und SQS), pubsub (Google Cloud Pub/Sub) |
stream |
| Key-Manager, der die privaten Schlüssel der Konten verschlüsselt | key_manager |
local (ein Schlüsselverschlüsselungsschlüssel, den du aufbewahrst), gcpkms (Google Cloud KMS), awskms (AWS KMS), plugin |
Den Schlüssel verwalten |
mail |
none, smtp, ses (Amazon SES), plugin |
E-Mails versenden | |
| CAPTCHA | captcha |
none, turnstile (Cloudflare Turnstile), hcaptcha, recaptcha (Google reCAPTCHA v2) |
CAPTCHA |
| Sprachchat | voice |
off, p2p (Browser zu Browser, mit TURN aus voice_turn: none, coturn oder cloudflare), livekit, sora |
Sprachchat |
| Zahlungen von Unterstützern | payments |
none, stripe, payjp (PAY.JP) |
Unterstützer, Stripe, PAY.JP |
| Plugins | plugin_<kind>_address |
standardmäßig keine; eine Adresse für jede Art: translator, search, billing, mailer, media_image, media_video, media_audio, key_manager und die Entscheidungs-Hooks inbound.status, local.status, inbound.follow, signup.check, media.check, inbound.actor, local.profile |
Plugins, Entscheidungs-Hooks |
| Übersetzung von Beiträgen | translator_<provider>_*, plugin_translator_address |
keine (nur die eigene Übersetzung des Browsers); libretranslate, deepl, google (Google Cloud Translation), aws (Amazon Translate) oder ein Plugin von dir vor dem Dienst, den du wählst |
Beiträge übersetzen, ein Übersetzer-Plugin |
| Volltextsuche der Beiträge | search |
none; oder elasticsearch, opensearch oder meilisearch (Suchmaschinen); oder plugin, ein Plugin von dir vor einer anderen Suchmaschine |
Volltextsuche, ein Such-Plugin |
| CDN für Medien | media_origin |
nicht gesetzt (der Server liefert Medien von seinem eigenen Origin aus) oder der Origin deines CDN | Medien über ein CDN ausliefern |
| Cloud-Kosten | billing_sources |
keine, oder beliebige von aws (AWS Cost Explorer), gcp (Billing-Export oder Budget von Google Cloud), cloudflare (Nutzungskosten von Cloudflare), plugin |
Cloud-Kosten importieren |
| Metriken | metrics_exporter |
none, prometheus, otlp (OpenTelemetry), emf (CloudWatch) |
Metriken, Alarme |
| Traces | traces_exporter |
none, otlp |
Traces |
| Fehlerberichte | errors_exporter |
none (nur die Logzeile und die Fehlergruppen), sentry (Sentry, GlitchTip, Datadog), otlp |
Fehlerberichte |
Die veröffentlichte Binärdatei und das Container-Image enthalten jeden Adapter der Tabelle.
my config check meldet alle Probleme der Konfiguration auf einmal, bevor du den Server startest
(Produktions-Checkliste).
Vom kleinen Server zum großen
Abschnitt betitelt „Vom kleinen Server zum großen“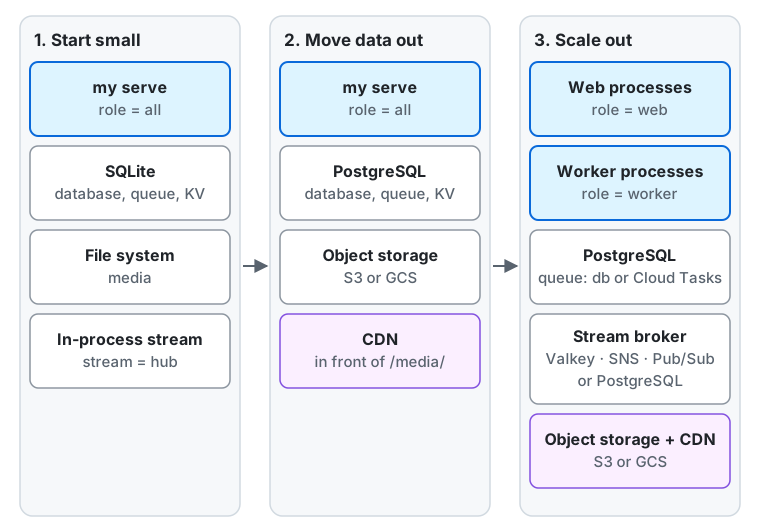
- Klein anfangen. Ein Prozess mit
role = all, auf SQLite, mit Medien im Dateisystem und den Standardwerten für den Rest: Queue und Key-Value-Store in der Datenbank und der Echtzeit-Stream innerhalb des Prozesses. Die Docker-Compose-Dateien indeploy/dockerstarten dieses Setup auf einer Maschine (Bereitstellung mit Docker Compose). Es passt zu einem persönlichen oder kleinen Server.stream = huberreicht nur den Prozess, in dem er läuft, daher bleibt dieses Setup bei einem Prozess. - Die Daten auslagern. PostgreSQL für die Datenbank, ein S3-kompatibler Bucket oder Google Cloud Storage für die Medien und ein CDN vor den Medien. Der Server ist noch ein Prozess, hängt aber nicht mehr an einer Platte, und die Prozesse des nächsten Schritts können die Daten teilen. Entscheide das nach Möglichkeit vor dem ersten Start: Die Daten später von SQLite und dem Dateisystem umzuziehen, ist eine Aufgabe für sich (Was zu sichern ist listet auf, was umziehen muss).
- Skalieren. Führe Prozesse mit
role = webfür die Anfragen undrole = workerfür die Jobs aus, so viele, wie jede Art braucht, und teile die Worker nach Job-Typ auf (Worker aufteilen). Mit mehr als einem Prozess braucht der Echtzeit-Stream einen Broker, der jeden Prozess erreicht (postgres,valkey,snsoderpubsub), und der Key-Value-Store sollte geteilt werden (dbodervalkey), damemorydie Rate Limits und die Antworten auf erneut gesendete Schreibvorgänge jedes Prozesses getrennt hält. Die Job-Queue bleibt in PostgreSQL oder zieht zu Google Cloud Tasks um (Cloud Tasks).
Die Bereitstellung auf Cloud Run ist ein Beispiel für ein Setup zwischen dem zweiten und dem dritten Schritt:
role = all auf Cloud Run, PostgreSQL auf Neon, Medien in Cloud Storage, Cloud Tasks für die Jobs und Pub/Sub für den
Stream, ohne laufende Instanz, solange niemand den Server nutzt.
Wie es weitergeht
Abschnitt betitelt „Wie es weitergeht“Lies die Betreiber-Leitfäden in dieser Reihenfolge:
- Loslegen: den Server betreiben oder auf Cloud Run deployen, dann die Checkliste für den Produktivbetrieb durchgehen, bevor du ihn für Nutzer öffnest.
- Den Server konfigurieren: ihre Einstellungen, die Registrierung, externe Login-Anbieter, E-Mail, CAPTCHA, das CDN, Linkvorschauen und Suchmaschinen und KI-Crawler.
- Funktionen einschalten: Moderation, Relays, Webhooks, Plugins und Entscheidungs-Hooks, Sprach-Chat, Volltextsuche, Unterstützer und ihre Zahlungen sowie Cloud-Kosten importieren.
- Im Alltag betreiben: Überwachung, Alarme, Fehlerberichte, Wartung, Backup, die Datenbank, den Key Encryption Key und Administratoren und Rollen.
- Rechtliches und Schließung: die Vorlagen für Datenschutzerklärung und Verarbeitungsverzeichnis sowie den Dienst schließen.
Die Konfigurationsreferenz listet jede Einstellung auf, und die Job-Referenz jeden Job, den die Worker ausführen.
Für LLMs und Coding-Agenten:llms.txt,llms-full.txt, llms-small.txt