

本页由英文页面机器翻译而来。内容以英文页面为准。 阅读英文页面
数据库:初始化、升级和重建
运维人员如何创建数据库、把它升级到新版本,以及仅限开发和测试实例的清空操作。
schema 位于 schema/,每个模块一个目录,每种数据库一个文件(schema/<NN>-<module>/sqlite.sql 和 postgres.sql)。服务器二进制文件内含其版本的 schema,由 my schema apply 应用:每种部署都会在服务器之前,用服务器镜像和服务器的数据库设置,把它作为一次性任务运行,因此服务器镜像是一个实例所需要的唯一镜像。my serve 从不应用 schema。在没有 schema 的数据库上启动时,服务器会在 /readyz 上返回 503(请参阅启动服务器)。
schema 变更需要带过去的数据(一列拆成两列,一个值移到新表)会由服务器镜像自带的 my db upgrade 重写,它在 schema 应用之后,每个版本运行一次。完整的顺序见升级。
初始化(应用 schema)
Section titled “初始化(应用 schema)”my schema apply 只运行使数据库达到其版本 schema 所需的语句:在空数据库上会创建所有内容,在已是最新的数据库上什么也不做。它可以安全地运行任意多次,每次升级都会再次运行它。
使用 my schema apply
Section titled “使用 my schema apply”my schema apply 读取服务器配置中的数据库设置(database、database_url 和 database_dev_url,来自 -config <file> 或环境变量;不需要其他设置),并使数据库达到二进制文件所属版本的 schema:
my schema apply -dry-run # print the SQL statements it would run, and change nothingmy schema apply # run them- 它会打印所运行的 SQL 语句,并在一个事务中运行它们:只要有一条失败,所有语句都不会保留。已经与 schema 一致的数据库保持不变(
ok: the database matches the schema; nothing to apply)。 - 删除表或列的计划会被拒绝,什么也不会运行,除非指定了
-allow-destructive。仅在版本说明要求时、且在备份之后才使用它。为修改 SQLite 表而重建表不算删除。 - 在 PostgreSQL 上,它会在同一数据库的临时 schema 中构建用于比较的 schema,并在结束时删除它,失败时也一样;角色需要在该数据库中创建 schema 的权限。如果没有该权限,请把
database_dev_url设置为另一个具有该权限的数据库(database_dev_url)。针对同一数据库的多次运行会互相等待,因此同时运行两次也都会成功。 - 它支持
database = sqlite和database = postgres,当因错误或拒绝删除而没有应用任何内容时以1退出。
从 v0.1.0 起,受支持版本之间的升级绝不包含会丢失数据的差异;v0.1.0 之前的版本可能会删除列和表,需要 -allow-destructive。每次升级前请用 -dry-run 阅读 SQL(参见升级)。
my schema apply 必须直接连接数据库。它持有会话级别的锁,而事务模式的连接池(PgBouncer 的事务池化、Neon 的 pooled 连接字符串)不会保持这种锁:通过连接池同时运行两次时,它们会挂起而不是失败。请把直连 URL 作为 database_url 提供给它。pool_max_conns 和其他 pool_* 参数可以保留在其中,也可以保留在 database_dev_url 和 stream_postgres_url 中:不打开连接池的命令会忽略它们。my db upgrade、my db upgrade -check 和控制台使用同样的 URL。
my serve 可以使用事务模式的连接池,前提是:
- 连接池支持协议级别的预处理语句,服务器的每个查询都会使用它:需要 PgBouncer 1.21 或更高版本,且
max_prepared_statements大于 0,Neon 的 pooled 连接字符串满足这一点。在不支持它的连接池后面,语句会随机地以prepared statement ... does not exist或already exists失败:在 URL 中添加default_query_exec_mode=exec可以避开预处理语句,代价是每个查询多一次往返。 - 当
stream = postgres时,stream_postgres_url使用直连 URL,因为LISTEN属于会话。使用 pooled URL 的监听者能够连接,但之后收不到任何内容。 - URL 中没有
search_path或其他连接池在连接时会拒绝的参数:除非ignore_startup_parameters列出了它们,否则 PgBouncer 会关闭这样的连接。
Docker Compose
Section titled “Docker Compose”在 deploy/docker/compose.yaml 中,服务器镜像的三个一次性服务按以下顺序运行,每个都只在前一个成功之后运行,服务器(my)最后启动:
| 服务 | 运行内容 |
|---|---|
upgrade-check |
my db upgrade -check(在空数据库上通过) |
schema |
my schema apply,作用于 /data/my.db,使用 compose.postgres.yaml 层时则作用于其 PostgreSQL(Docker Compose 文件) |
upgrade |
my db upgrade |
cd deploy/dockerdocker compose up -d # pulls the image of MY_VERSION; the three one-off services run in order, then my startscurl -fsS localhost:8080/readyz # ready when it answers {"status":"ok"}docker compose exec -T my my admin create -username alice -email alice@example.com < password.txt- 三者中任何一个失败,
my都不会启动。用docker compose logs upgrade-check(或schema、upgrade)查看其输出。 - 创建管理员的方法见管理员和角色。
不使用 Compose 时,请把服务器镜像的 my schema apply 作为一次性任务运行(Kubernetes Job 或 init container、Cloud Run job 等),并使用与服务器相同的数据库设置:
# SQLite: mount the volume that holds the database file at /datadocker run --rm -v my_data:/data -e MY_DATABASE=sqlite -e MY_DATABASE_URL=/data/my.db my schema apply
# PostgreSQLdocker run --rm -e MY_DATABASE=postgres -e MY_DATABASE_URL='postgres://my:...@db.example/my' my schema applyPostgreSQL 的连接池遵循 database_url 的 pool_* 参数:pool_max_conns(默认为 4 和 CPU 数量中较大的一个)和 pool_min_conns(没有请求时保留的连接数),其余连接由 pool_max_conn_idle_time(30 分钟)关闭。如果实例的请求间隔很长,请设置 pool_min_conns,否则每个请求都会打开一个连接。
SQLite 同样接受 pool_max_conns(默认值相同),以及 pool_max_idle_conns,即它最多保留的空闲连接数。它是上限,而不是像 pool_min_conns 那样的下限(默认保留全部连接,并且不会因超时而关闭任何连接,因此安静的实例也能立即响应)。新连接在第一次查询之前会解析 schema,这就是连接池保留连接的原因。
升级到新版本时,始终按以下顺序执行这些步骤,并使用新版本的服务器镜像:
- 备份数据库(如果使用文件系统 blob 存储,还要备份媒体)。请参阅备份。
my db upgrade -check。它不会改变任何内容。当新的 schema 会丢弃数据库尚未迁移的数据时,它以1退出,并指出需要先经由哪个版本升级;此时请停下来,并按照跳过版本操作。空数据库可以通过。my schema apply,与初始化中相同。请先用-dry-run检查 SQL。my db upgrade。它会运行该版本中数据库尚未记录的每个数据升级步骤,重建这些步骤所指明的投影,并记录每个步骤。再次运行时,它什么也不做。如果某个步骤失败,它以1退出;已完成的步骤仍保持已记录,再次运行会从失败的那一步继续。- 启动新的服务器。 在其版本的每个数据升级步骤都被记录之前,它会在
/readyz上返回503,并记录缺少的步骤。
my serve 从不运行 my db upgrade -check、my schema apply 或 my db upgrade;它们是一次性任务。同一时间对一个数据库只运行其中一个。
在一个作业中运行这些步骤
Section titled “在一个作业中运行这些步骤”my upgrade 会在 my config check 的检查之后,在一个进程中运行步骤 2 到 4,这样一个一次性作业(Cloud Run 作业的一次执行、ECS 任务、Kubernetes Job)就能承载整个迁移:
my config checkmy db upgrade -checkmy schema apply,如果给my upgrade指定了-allow-destructive,则带上它my db upgrade
它会在第一个失败的步骤处停止,并以该步骤的退出码退出;之后的步骤不会运行。每个步骤会先打印一行写有其名称的内容,例如 ==> my schema apply,然后是该命令的输出,因此作业的日志会显示它停在哪里。修复原因后,请再次运行 my upgrade:已完成的步骤会发现无事可做。-config <file> 会传给每个步骤。
my upgrade -dry-run 会运行 my config check、my db upgrade -check 和 my schema apply -dry-run,不会改变任何内容:请在升级之前阅读它打印的 SQL。请在 my upgrade 之前按步骤 1 备份数据库;它不会切换到维护模式,也不会启动服务器。
大多数版本不添加数据升级步骤:my db upgrade -check 会输出 ok: the database can be upgraded to this release,而在已经记录了先前版本各步骤的数据库上,my db upgrade 会输出 ok: no data upgrade step to run。新数据库会在第一次 my db upgrade 时记录该版本的每个步骤,没有需要重写的内容。无论如何都请把两者都运行一遍,这样流程就不用依赖阅读每份发布说明。发布说明的 Upgrading 部分列出了每个版本的步骤。
升级期间的服务器
Section titled “升级期间的服务器”不保证零停机升级。在步骤 3 到 5 之间的短暂时间内,旧服务器可以继续在新 schema 上工作,但它不能参与数据升级步骤。升级时请切换到维护模式:在维护模式下,my serve 不打开任何数据库连接,因此备份是一致的,步骤运行期间也不会有任何写入。请把维护时间控制在几个小时以内(多长时间)。
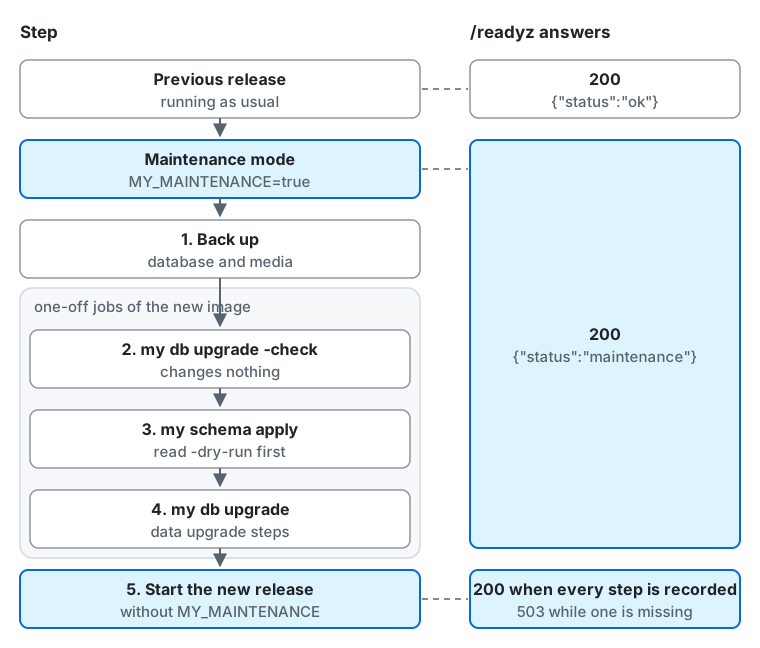
从图的上方往下:
- 旧版本。 服务器照常运行,
/readyz返回200和{"status":"ok"}。 - 维护模式。 使用
MY_MAINTENANCE=true重新部署。从此时起直到新版本启动,/readyz返回200和{"status":"maintenance"},因此负载均衡器会保留这些实例,同时没有任何请求到达数据库。 - 1. 备份数据库和媒体。
- 2 到 4:新镜像的一次性任务。
my db upgrade -check不做任何更改;my schema apply在你阅读其-dry-run之后运行;my db upgrade运行数据升级步骤。 - 5. 启动新版本,不带
MY_MAINTENANCE。当该版本的每个数据升级步骤都被记录后,/readyz返回200和{"status":"ok"};缺少某个步骤(或 schema 未应用)时返回503。
使用 Docker Compose 时,docker compose up 会在一次性任务运行之前替换维护模式的容器,因此在步骤 2 到 4 期间
/readyz 上没有任何响应(Docker Compose)。
用 -dry-run 检查 SQL
Section titled “用 -dry-run 检查 SQL”在步骤 3 应用任何内容之前,运行 my schema apply -dry-run,阅读它将要运行的内容。大多数版本包含的是新增内容(CREATE TABLE、ADD COLUMN、CREATE INDEX)。projection 表也可能被重建,之后由 my db upgrade 根据其事件重新填充。对其他任何内容的 DROP 或类型变更,都应列在版本说明的
Breaking changes 部分;如果没有列出,请在应用之前停下来并报告。除非指定 -allow-destructive,否则 my schema apply 会拒绝删除表或列的计划。
Docker Compose
Section titled “Docker Compose”docker compose up -d 会自动按顺序运行步骤 2 到 5(参见初始化中的表格)。其中任何一步失败,新服务器都不会启动。
cd deploy/docker
# 1. Switch to the maintenance mode. --no-deps keeps the one-off services from running.MY_MAINTENANCE=true docker compose up -d --no-deps --force-recreate my
# 2. Back up the volume (database and media) while the maintenance mode holds no connection.docker run --rm -v my_data:/data -v "$PWD":/backup busybox tar czf /backup/my-data-$(date +%Y%m%d%H%M).tar.gz -C /data .
# 3. Set MY_VERSION in .env to the new version (0.2.0, or its digest form 0.2.0@sha256:... from the notes), and pull it.docker compose pull
# 4. Check the SQL that the schema service will run.docker compose run --rm --no-deps upgrade-checkdocker compose run --rm --no-deps schema schema apply -dry-run
# 5. Upgrade: upgrade-check, schema, upgrade, then my starts again without the maintenance mode.docker compose up -dcurl -fsS localhost:8080/readyz
docker compose up 会在一次性服务运行之前替换 my 容器,并且只在三者都成功之后才启动新容器。如果其中一个失败,docker compose up 会报告失败,服务器保持停止状态:在此期间请在前面放置导出的维护页面。阅读 docker compose logs <service>,然后修复原因并再次运行 docker compose up -d,或者回滚。卷名 my_data 由 Compose 项目名(my)加上卷名(data)组成。
MY_VERSION 是升级唯一改变的内容,而且不会有任何东西替你改变它:没有 latest 标签,0.1 只在 v0.1 范围内移动。使用 MY_VERSION=0.1 时,步骤 3 只需 docker compose pull,它会获取最新的补丁版本。如果要从源代码构建,请检出新版本的标签,在步骤 3 中使用 docker compose -f compose.yaml -f compose.build.yaml build,并在其他步骤中使用相同的 -f 选项。
Kubernetes
Section titled “Kubernetes”在发布新镜像之前,把步骤 2 到 4 作为一个 Job 运行。init container 依次运行,每个都只在前一个成功之后运行,主容器最后运行,因此一旦失败,Job 会在下一步之前停止。请给这些容器与 Deployment 相同的配置。
apiVersion: batch/v1kind: Jobmetadata: name: my-upgrade-v0-2-0spec: backoffLimit: 0 template: spec: restartPolicy: Never initContainers: - name: upgrade-check image: ghcr.io/mycroblog/my:0.2.0 args: [db, upgrade, -check] envFrom: [{ secretRef: { name: my-config } }] # the Deployment's settings - name: schema image: ghcr.io/mycroblog/my:0.2.0 args: [schema, apply] envFrom: [{ secretRef: { name: my-config } }] containers: - name: upgrade image: ghcr.io/mycroblog/my:0.2.0 args: [db, upgrade] envFrom: [{ secretRef: { name: my-config } }]kubectl set env deployment/my MY_MAINTENANCE=true && kubectl rollout status deployment/my# back up, and check the SQL with a one-off Pod of the new image: my schema apply -dry-runkubectl apply -f my-upgrade-v0-2-0.yamlkubectl wait --for=condition=complete --timeout=30m job/my-upgrade-v0-2-0kubectl set image deployment/my my=ghcr.io/mycroblog/my:0.2.0kubectl set env deployment/my MY_MAINTENANCE-kubectl rollout status deployment/my如果 Job 失败,kubectl logs job/my-upgrade-v0-2-0 -c upgrade-check(或 -c schema、-c upgrade)会显示原因,Deployment 保持在旧镜像上。在卷上使用 SQLite 时,请在 Job 中挂载同一个卷,并先停止 Deployment 的 Pod:SQLite 只允许一个写入者。
Cloud Run
Section titled “Cloud Run”使用 OpenTofu 模块时,升级就是对新发布版本执行一次 apply:它会在服务换上新镜像之前,在迁移作业中运行 my upgrade,并在失败时停在那里:请参阅在 Cloud Run 上部署。手动操作时:
Cloud Run job 每个只运行一个容器,因此请为每个步骤创建一个 job,并使用 --wait 按顺序执行,job 失败时它也会失败。请给这些 job 与服务相同的环境变量和 secret。
gcloud run services update my --region=asia-northeast1 --update-env-vars=MY_MAINTENANCE=true# back up (see below)
gcloud run jobs deploy my-upgrade-check --region=asia-northeast1 --image=ghcr.io/mycroblog/my:0.2.0 \  --args=db,upgrade,-check --set-env-vars=... --set-secrets=...gcloud run jobs deploy my-schema --region=asia-northeast1 --image=ghcr.io/mycroblog/my:0.2.0 \  --args=schema,apply --set-env-vars=... --set-secrets=...gcloud run jobs deploy my-upgrade --region=asia-northeast1 --image=ghcr.io/mycroblog/my:0.2.0 \  --args=db,upgrade --set-env-vars=... --set-secrets=...
gcloud run jobs execute my-upgrade-check --region=asia-northeast1 --wait &&  gcloud run jobs execute my-schema --region=asia-northeast1 --wait &&  gcloud run jobs execute my-upgrade --region=asia-northeast1 --wait &&  gcloud run deploy my --region=asia-northeast1 --image=ghcr.io/mycroblog/my:0.2.0 --remove-env-vars=MY_MAINTENANCE
如果要先检查 SQL,请用 --args=schema,apply,-dry-run 部署 schema job 并执行它,阅读其日志后,再为实际应用重新部署它。
在服务器停止写入之后(处于维护模式或已停止)、升级的任何步骤之前进行备份。备份与恢复完整介绍了每个部分;对于升级:
-
SQLite:在没有任何进程打开数据库文件时,连同其
-wal和-shm文件一起复制。使用 Compose 时,上面对卷执行的tar也涵盖了/data/blobs中的媒体。 -
PostgreSQL:使用自定义格式的
pg_dump,pg_restore可以读取它。终端窗口 pg_dump --format=custom --file=my-$(date +%Y%m%d%H%M).dump "postgres://my:...@db.example/my"托管数据库自身的备份(Cloud SQL 按需备份、RDS 快照)也可以;请在同一时间点进行。
-
媒体:文件系统 blob 存储是一个目录,与数据库一起复制即可。
-
KEK 不在数据库中。请保留在原处;恢复后的数据库需要同一个 KEK。
没有反向迁移。要回退,请恢复升级前的备份,然后启动旧版本:
- 停止新服务器(或将其切换到维护模式)。
- 恢复备份:使用 Compose 时,把归档解压到清空的卷中(
docker run --rm -v my_data:/data -v "$PWD":/backup busybox sh -c 'rm -rf /data/* && tar xzf /backup/<archive> -C /data');使用 PostgreSQL 时,运行pg_restore --clean --if-exists --dbname=<url> <dump>。 - 启动旧版本的镜像(使用 Compose 时,把
MY_VERSION改回旧版本,然后运行docker compose up -d)。
新版本在升级之后写入的所有内容都会丢失,因此请在升级后尽快回滚,趁实例还没有进行太多联邦通信。
每个版本都支持从同一个次版本升级(例如从 v0.2.1 到 v0.2.4),以及从上一个次版本的最新补丁版本升级(从最新的 v0.1.x 到 v0.2.y)。补丁版本从不删除列或表,因此在同一个次版本内,任何顺序都可以。
要跨越多个次版本,请依次经过每个次版本的最新补丁版本升级,每次都运行完整的流程。例如从 v0.1.3 到 v0.4.0:先到最新的 v0.1.x,然后到最新的 v0.2.x,再到最新的 v0.3.x,最后到 v0.4.0。my db upgrade -check 会阻止会丢失数据的跳跃,并指出需要经过的版本;此时什么都还没有改变。
检查和重建 projection
Section titled “检查和重建 projection”有些表是 projection:服务器根据其模块的事件和资源推导出它们(例如账号的限制由其审核操作推导而来)。worker 每天检查一次所有 projection,并修正发现的任何差异。手动检查或修正某个 projection:
my projection list # each projection with its module and tablesmy projection verify [<name>] # derive every projection, or the one named, and print the rows that differ; changes nothingmy projection rebuild [<name>] # derive them the same way and write the difference<name>是一个 projection 或其中的一张表。verify打印表中存在但来源推导不出的行(-),以及来源推导出但表中缺少的行(+),有任何差异时以1退出。rebuild每个事务最多写入 500 行,因此读取者永远不会看到被清空的 projection。请在实例空闲时运行:重建期间发生变化的行会保留其新值,之后运行verify会报告剩余的差异。
重建(清除所有行)
Section titled “重建(清除所有行)”重建是指清空数据库并再次应用 schema。从 v0.1.0 起,重建仅适用于开发和测试实例。切勿重建与其他服务器联邦的公开实例。
所有行都会丢失且无法恢复。用密钥加密密钥(KEK)包装的账号密钥也会丢失,因此在相同主机名下重新创建的账号会得到不同的密钥,对其他服务器来说是一个不同的 Actor,其远程关注关系也不会恢复。无法应用 schema 变更的公开实例应改为从备份回滚。
没有用于清除数据库的 my 命令:请用数据库自身的工具删除它,然后再次应用 schema。空数据库中没有记录 host 和 account_domain,因此下次启动时会记录所配置的值。
Docker Compose
Section titled “Docker Compose”cd deploy/dockerdocker compose stop my # stop the serverdocker run --rm -v my_data:/data busybox rm -f /data/my.db /data/my.db-wal /data/my.db-shmdocker compose up -d # the one-off services apply the schema to the empty database, then my starts- 已上传和已处理的媒体(
/data/blobs)会保留。要连同数据库一起清除它们,请用docker compose down -v删除命名卷,然后运行docker compose up -d。不加-v时卷会被保留。 - 如果要先保留一份副本,请停止服务器,并从卷中复制
my.db(连同其-wal和-shm文件)。
PostgreSQL
Section titled “PostgreSQL”删除数据库并以相同的所有者重新创建一个空数据库(或使用托管数据库的控制台),然后运行 my schema apply:
# stop every server and job that uses the database firstdropdb --maintenance-db="postgres://postgres:...@db.example/postgres" mycreatedb --maintenance-db="postgres://postgres:...@db.example/postgres" --owner=my mymy schema apply供 LLM 和编程智能体使用:llms.txt,llms-full.txt, llms-small.txt