

本页由英文页面机器翻译而来。内容以英文页面为准。 阅读英文页面
mycroblog 服务器概述
这是运行服务器之前首先要读的页面。mycroblog 是一个通过 ActivityPub 与联邦宇宙中其他服务器联邦的微博客;my 是它的服务器软件,是一个单一的二进制文件,包含服务器、任务 worker、Web 客户端,以及维护它们的命令。本页介绍服务器由哪些部分组成、哪些部分通过配置选择、小型服务器如何成长为大型服务器,以及接下来该读什么。
服务器的组成
Section titled “服务器的组成”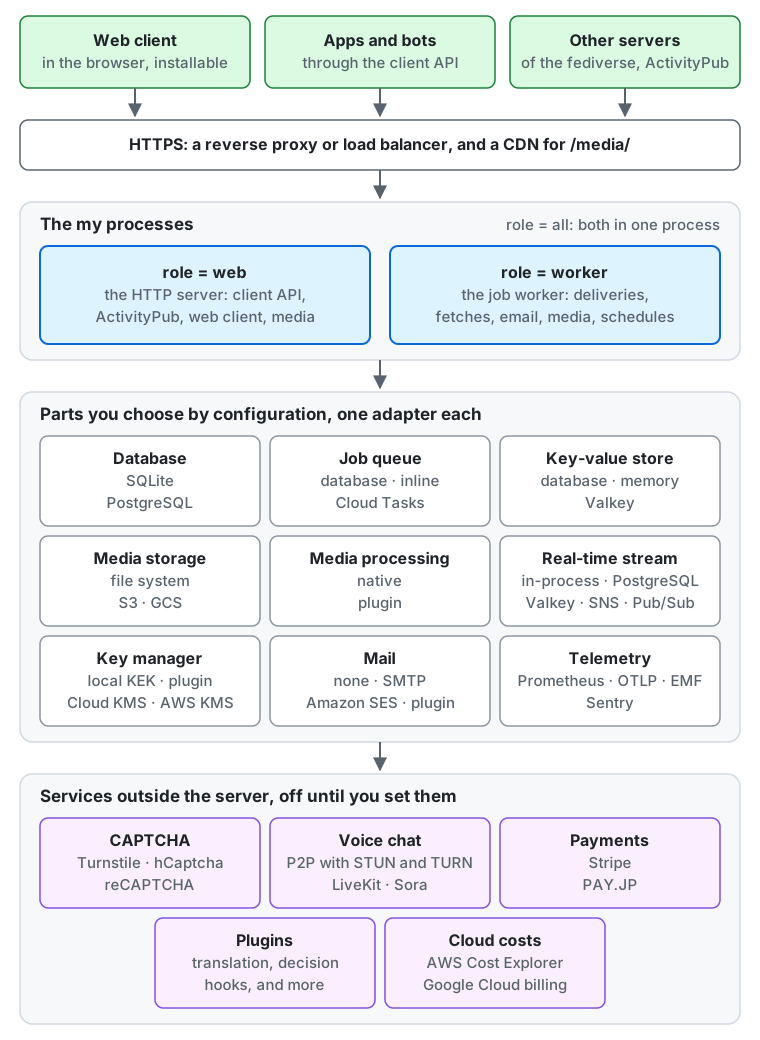
按图中从上到下的顺序:
- 谁会连接。 用户在浏览器中使用 Web 客户端(也可以作为应用安装),应用和机器人使用客户端 API,联邦宇宙中的其他服务器通过 ActivityPub 投递和获取帖子。它们都通过 HTTPS 连接到服务器。
- 服务器前端。 默认情况下
my使用明文 HTTP,因此由放在它前面的反向代理或负载均衡器终止 HTTPS。 在单台机器上,my也可以自己提供 HTTPS(由服务器直接提供 HTTPS)。 在媒体文件前面放置 CDN 是可选的。 my进程。 每个进程运行my serve,它的role决定它运行什么:web是 HTTP 服务器;worker是任务 worker,负责投递帖子、从其他服务器获取内容、发送邮件、处理媒体以及运行周期性任务;默认值all则在一个进程中同时运行两者。- 你选择的组件。 图中间的每个组件都有一个选择其适配器的设置,列在下一节中。
- 服务器外部的服务。 CAPTCHA、语音聊天、支付、插件和云费用导入在你设置之前都保持关闭,设置后服务器会调用你指定的服务。
通过配置选择的部分
Section titled “通过配置选择的部分”每个部分都是配置参考中的一个设置,可以写在 TOML 文件中,也可以作为环境变量设置(MY_ 加上大写的键,例如 MY_DATABASE)。每个列表中的第一个选项是默认值。
凡是保存数据的部分,请在第一次启动之前选定:设置改变时,数据不会自己迁移。
| 部分 | 设置 | 选项 | 接着阅读 |
|---|---|---|---|
| 数据库 | database |
sqlite(一个文件)、postgres(PostgreSQL 及兼容的服务) |
数据库、备份 |
| 任务队列 | queue |
db(数据库中的一张表)、inline(在同一进程中立即运行每个任务,用于测试和开发)、cloudtasks(Google Cloud Tasks 为每个任务唤醒服务器;需要 PostgreSQL) |
任务队列 |
| 键值存储,用于缓存、速率限制,以及为重复发送的写入请求保留一天的应答 | kv |
db(数据库中的一张表)、memory(每个进程各自独立)、valkey(Valkey 或其他 Redis 协议的服务器,由所有进程共享) |
kv |
| 媒体存储 | blob |
fs(一个目录)、s3(Amazon S3、Cloudflare R2、MinIO、Garage 和其他 S3 兼容的存储)、gcs(Google Cloud Storage) |
Docker Compose 文件、备份媒体 |
| 媒体处理 | media_image、media_video、media_audio,每种文件各一个 |
native(在服务器内部)、plugin(由你的插件转换该类文件) |
转换媒体 |
| 进程之间的实时流 | stream |
hub(在一个进程内部)、postgres(LISTEN / NOTIFY)、valkey、sns(Amazon SNS 和 SQS)、pubsub(Google Cloud Pub/Sub) |
stream |
| 密钥管理器,用于加密账号的私钥 | key_manager |
local(由你保管的密钥加密密钥)、gcpkms(Google Cloud KMS)、awskms(AWS KMS)、plugin |
管理密钥 |
| 电子邮件 | mail |
none、smtp、ses(Amazon SES)、plugin |
发送电子邮件 |
| CAPTCHA | captcha |
none、turnstile(Cloudflare Turnstile)、hcaptcha、recaptcha(Google reCAPTCHA v2) |
CAPTCHA |
| 语音聊天 | voice |
off、p2p(浏览器到浏览器,TURN 由 voice_turn 决定:none、coturn 或 cloudflare)、livekit、sora |
语音聊天 |
| 支持者付款 | payments |
none、stripe、payjp(PAY.JP) |
支持者、Stripe、PAY.JP |
| 插件 | plugin_<kind>_address |
默认没有;每种类型一个地址:translator、search、billing、mailer、media_image、media_video、media_audio、key_manager,以及决策钩子 inbound.status、local.status、inbound.follow、signup.check、media.check、inbound.actor、local.profile |
插件、决策钩子 |
| 帖子翻译 | translator_<provider>_*、plugin_translator_address |
无(只有浏览器自带的翻译);libretranslate、deepl、google(Google Cloud Translation)、aws(Amazon Translate),或者在你所选服务前面的你自己的插件 |
翻译帖子、翻译插件 |
| 帖子的全文搜索 | search |
none;或 elasticsearch、opensearch 或 meilisearch(搜索引擎);或 plugin,即在另一个引擎前面的你自己的插件 |
全文搜索、搜索插件 |
| 媒体的 CDN | media_origin |
未设置(服务器从它自己的源提供媒体),或你的 CDN 的源 | 通过 CDN 提供媒体 |
| 云费用 | billing_sources |
无,或 aws(AWS Cost Explorer)、gcp(Google Cloud 的账单导出或预算)、cloudflare(Cloudflare 的用量费用)、plugin 中的任意几项 |
导入云费用 |
| 指标 | metrics_exporter |
none、prometheus、otlp(OpenTelemetry)、emf(CloudWatch) |
指标、告警 |
| 追踪 | traces_exporter |
none、otlp |
追踪 |
| 错误报告 | errors_exporter |
none(只有日志行和错误分组)、sentry(Sentry、GlitchTip、Datadog)、otlp |
错误报告 |
发布的二进制文件和容器镜像包含表中的每个适配器。
my config check 会在你启动服务器之前,一次性报告配置的所有问题
(生产检查清单)。
从小型服务器到大型服务器
Section titled “从小型服务器到大型服务器”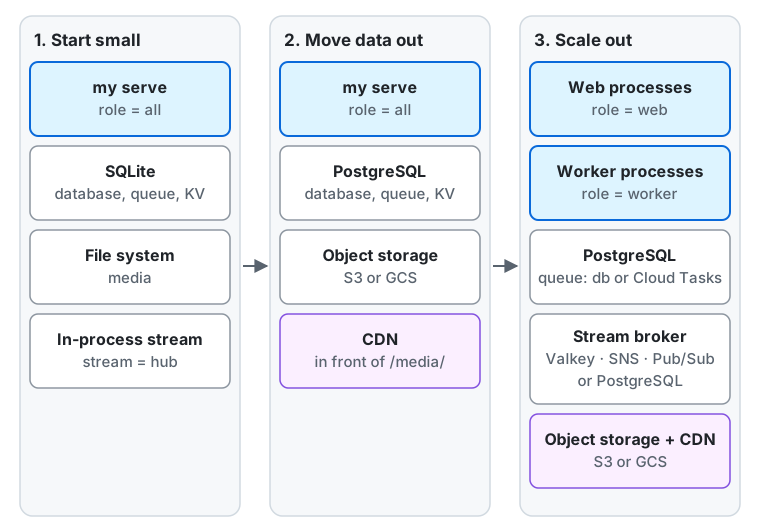
- 从小规模开始。 一个
role = all的进程,使用 SQLite,媒体存放在文件系统上,其余使用默认值:队列和键值存储在数据库中,实时流在进程内部。deploy/docker中的 Docker Compose 文件可以在一台机器上启动这套配置(使用 Docker Compose 部署)。它适合个人或小型服务器。stream = hub只能到达它所在的进程,因此这套配置只能保持一个进程。 - 把数据移出去。 数据库使用 PostgreSQL,媒体使用 S3 兼容存储桶或 Google Cloud Storage,并在媒体前面放置 CDN。服务器仍是一个进程,但不再依赖单块磁盘,下一阶段的多个进程也可以共享这些数据。如果可以,请在首次启动前做出决定:之后再把数据从 SQLite 和文件系统迁出是一项单独的工作(需要备份的内容列出了需要迁移的内容)。
- 横向扩展。 用
role = web的进程处理请求,用role = worker的进程处理任务,按各自需要运行任意数量,并按任务类型拆分 worker(拆分 worker)。有多个进程时,实时流需要一个能到达每个进程的代理(postgres、valkey、sns或pubsub),键值存储也应当共享(db或valkey),因为memory会让每个进程的速率限制和对重复发送的写入请求的应答彼此独立。任务队列继续留在 PostgreSQL 中,或迁移到 Google Cloud Tasks(Cloud Tasks)。
Cloud Run 部署是介于第二和第三阶段之间的一个配置示例:在 Cloud Run 上运行 role = all,PostgreSQL 使用 Neon,媒体存放在 Cloud Storage,任务使用 Cloud Tasks,流使用 Pub/Sub,没有人使用服务器时不运行任何实例。
接下来读什么
Section titled “接下来读什么”按以下顺序阅读运营指南:
供 LLM 和编程智能体使用:llms.txt,llms-full.txt, llms-small.txt