

本页由英文页面机器翻译而来。内容以英文页面为准。 阅读英文页面
备份与恢复
本文说明需要备份什么、如何在实例继续运行的情况下完成每项备份、如何从备份恢复实例,以及如何在真正需要之前演练恢复。升级时也要做备份,相关步骤见升级。
需要备份什么
Section titled “需要备份什么”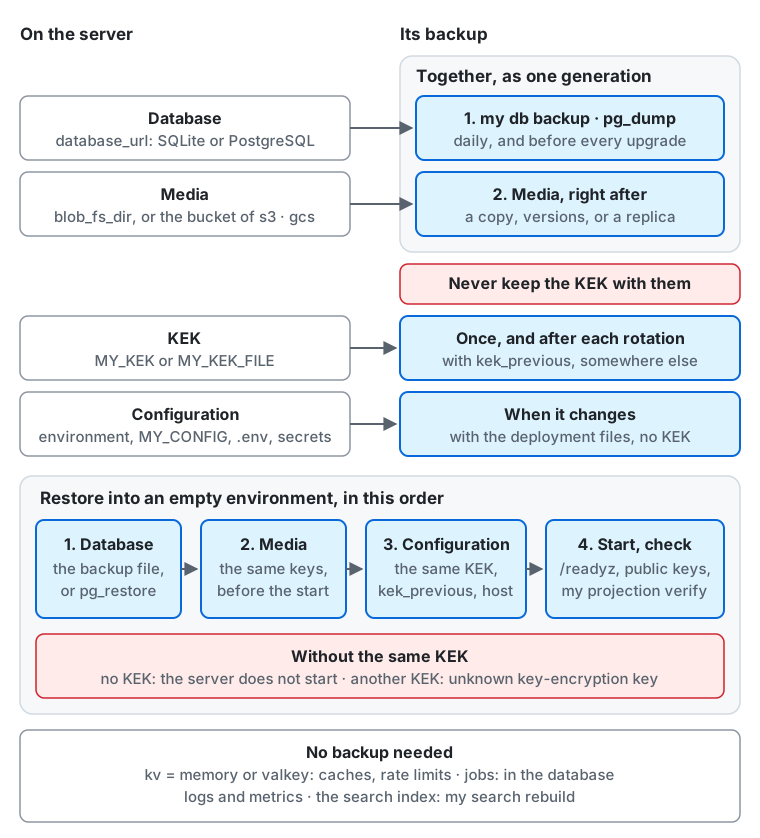
按图中从上到下的顺序:
- 数据库(
database_url:SQLite 或 PostgreSQL)最先备份,使用my db backup或pg_dump,每天一次,并在每次升级前进行。 - 媒体(
blob_fs_dir,或s3、gcsblob 存储的存储桶)紧接着备份,方式可以是复制、存储桶的版本或副本。这两份备份构成一代,放在一起保存,存放在服务器之外并加密。 - KEK(
MY_KEK或MY_KEK_FILE)备份一次,每次轮换后再备份,连同kek_previous一起,并且绝不与数据库备份放在同一个地方。使用key_manager = gcpkms或awskms时,KEK 保留在 KMS 中:只要还保留着需要它的备份,就要让kms_key的密钥保持启用(停用 AWS KMS 密钥)。 - 配置(环境变量、
MY_CONFIG、.env和各项密钥)在发生变化时随部署文件一起复制,不包含 KEK。 - 恢复要在空环境中按以下顺序进行:数据库,然后在服务器启动前放回使用相同键名的媒体,再放回使用同一个 KEK、
kek_previous和host的配置;然后启动服务器,检查/readyz、my projection verify和各 actor 的公钥(恢复)。没有 KEK 时服务器无法启动;使用另一个 KEK 时,读取密钥会失败并报unknown key-encryption key(没有正确的 KEK 时)。 - 不需要备份的有:
kv = memory或valkey时的键值存储(缓存和速率限制)、任务(它们在数据库中)、日志和指标,以及搜索引擎的索引(my search rebuild会重新生成)。
| 内容 | 存放位置 | 备份方法 | 没有备份时会丢失 |
|---|---|---|---|
| 数据库 | SQLite 文件(database_url)或 PostgreSQL 数据库 |
SQLite 或 PostgreSQL | 一切:账号、帖子、关注关系、设置 |
| 媒体 | fs blob 存储的目录 blob_fs_dir,或 s3 blob 存储的存储桶 blob_s3_bucket、gcs blob 存储的存储桶 blob_gcs_bucket |
媒体或存储桶中的媒体 | 上传的图片、视频和音频文件,以及缓存的远程文件 |
| KEK | 你保存 MY_KEK 或 MY_KEK_FILE 所指文件的地方(使用 Compose 时为 secrets/kek;绝不在数据库中) |
KEK,与数据库分开 | 每个 actor 的私钥,以及随之而来的该 actor 在联邦宇宙中的身份,还有数据库中保存的其他密钥 |
| 配置 | 环境变量、配置文件(MY_CONFIG)、各项密钥(MY_VAPID_PRIVATE_KEY、邮件和支付的密钥)、使用 Compose 时的 .env |
随部署文件一起复制 | 数据不会丢失,但实例无法以相同方式启动;更改 host 会使所有联邦 URL 失效 |
不需要备份的内容:
- 键值存储(
kv)。kv = db时它是数据库的一部分。kv = memory或kv = valkey时,它保存缓存、速率限制计数器,以及短期状态,例如等待第二重验证的登录。用空的 Valkey 恢复后,缓存会重新填充,速率限制重新计数,进行中的登录或语音通话需要重新开始。 - 任务队列(
queue)。queue = db和queue = cloudtasks时,任务是数据库的一部分,会随数据库一起恢复。Cloud Tasks 的任务只是为数据库中的任务传递信号;恢复后,服务器会在几分钟内再次为到期的任务发出信号。 - 日志和指标,服务器不会读回它们。
- 搜索引擎的索引(如果有的话)。
my search rebuild会从数据库重新生成它。如果你确实为搜索引擎做了快照,快照中包含帖子的文字,包括快照之后被删除的帖子,因此要像对待数据库备份一样对待它们(全文搜索)。
Web Push 的 VAPID 密钥是配置中的一项密钥。换用新密钥会使所有现有订阅的推送通知停止(Web Push VAPID 密钥),所以要把它和配置放在一起保存。
备份频率和存放位置
Section titled “备份频率和存放位置”- 数据库:至少每天一次,并在每次升级前进行。保留多代备份,例如 7 份每日、4 份每周和 3 份每月备份,这样即使很晚才发现错误也仍然可以撤销。支持时间点恢复的托管 PostgreSQL 可以覆盖其保留期内的日子。
- 媒体:每次都与数据库一起备份(见数据库与媒体的顺序)。
- KEK 和配置:在它们变化时备份。KEK 轮换也是一种变化:在使用新 KEK 之前先备份它,并且只要
kek_previous还列着旧 KEK,就继续保留它。 - 存放位置:远离服务器及其磁盘,放在另一个故障域中(另一台机器、另一个区域、另一个服务商或账号)。放在服务器自身磁盘上的备份,会随该磁盘的损坏一起丢失。
- 加密:数据库备份包含邮箱地址、密码哈希和私信;要对其进行静态加密(使用加密的存储桶,或在上传前用
age或gpg加密文件)。其中的密钥(例如各 actor 的私钥)已用 KEK 加密,所以绝不要把 KEK 和数据库备份放在同一个地方:同时拿到两者的人可以读取所有密钥。 - 保留期限:备份会保留用户已删除的数据,或你应要求已清除的数据。请按照隐私政策中写明的周期删除旧的备份。
备份期间服务器可以继续运行。如果要获得与某个时间点完全一致的备份(例如在升级前),请先切换到维护模式:在维护模式下,my serve 不打开任何数据库连接,也不写入任何内容。
SQLite
Section titled “SQLite”my db backup <file> 在服务器继续运行的同时,把 SQLite 数据库的一致副本写入一个新文件。副本包含命令开始前已提交的所有写入(包括仍在 -wal 文件中的写入),不包含之后的写入。它是单个文件,由于省略了空闲页,比原文件小。该命令拒绝写入已经存在的文件,并且只在 database = sqlite 时可用。
my db backup /backup/my-$(date +%Y%m%d%H%M).db使用 Docker Compose 时,在服务器的容器中运行它。副本写在容器内部,所以要把它写到数据卷中,再从那里移出来:
cd deploy/dockerdocker compose exec -T my my db backup /data/backup.dbdocker run --rm -v my_data:/data -v "$PWD":/backup busybox sh -c 'mv /data/backup.db /backup/my-$(date +%Y%m%d%H%M).db'服务器运行时,不要用 cp 或 tar 复制数据库文件:单独的数据库文件会缺少仍在 -wal 文件中的写入,而在写入过程中复制的副本可能已损坏。没有任何进程打开数据库时(服务器已停止,或处于维护模式),直接复制是可以的;这时要连同 -wal 和 -shm 文件一起复制。
PostgreSQL
Section titled “PostgreSQL”使用 pg_dump 的自定义格式,pg_restore 可以读取这种格式。它读取的是单个快照,所以服务器可以继续运行。
pg_dump --format=custom --file=my-$(date +%Y%m%d%H%M).dump "postgres://my:...@db.example/my"使用 Compose 层 compose.postgres.yaml 时,在数据库的容器中运行它(用 -f 或在 COMPOSE_FILE 中指定该层):
cd deploy/dockerdocker compose exec -T postgres pg_dump --format=custom -U my my > my-$(date +%Y%m%d%H%M).dump请使用与服务器主版本相同或更新的 pg_dump。
托管的 PostgreSQL 有自己的备份,对于大型数据库,这是更好的选择:
- Cloud SQL 和 Amazon RDS 每天自动备份;开启时间点恢复后,可以恢复到保留期内的任意一秒。请把两者都打开,将保留期设置为覆盖你想要的备份代数,并在每次升级前做一次按需备份(Cloud SQL 的按需备份、RDS 的快照)。
- 它们的恢复会创建一个新实例(或覆盖一个实例):之后把
database_url指向它。 - 这些备份留在服务商的账号中。也请时不时把
pg_dump导出到账号之外的地方,以免丢失账号时连同数据一起丢失。
fs blob 存储把所有文件保存在 blob_fs_dir 下(使用 Compose 时为 /data/blobs):上传的文件在 objects/ 中,正在写入的文件在 tmp/ 中。可以用任何复制文件的工具(tar、rsync、卷或磁盘的快照)复制该目录,tmp/ 除外。文件先写在 tmp/ 下,再一步重命名到 objects/ 中,因此在服务器运行时复制,objects/ 中也绝不会出现只写了一半的文件。
docker run --rm -v my_data:/data -v "$PWD":/backup busybox \ tar czf /backup/blobs-$(date +%Y%m%d%H%M).tar.gz -C /data --exclude=blobs/tmp blobs用 rsync 复制到备份主机,第一次之后的复制量会很小,因为媒体文件一旦写入就不再改变。
存储桶中的媒体
Section titled “存储桶中的媒体”s3 和 gcs blob 存储把每个文件都保存为存储桶 blob_s3_bucket 或 blob_gcs_bucket 中的一个对象,以它的键命名:处理后的媒体在 media/ 下,按原样接收的上传文件在 uploads/ 下,缓存的远程文件在 remote/ 下。存储桶保持私有:服务器读取这些文件,并在 /media/ 下提供它们。对象只有在完整写入之后才会出现,因此在服务器运行时进行的复制永远不会包含写了一半的文件。请分三层保护存储桶,从成本最低的到最安全的。
版本控制。 在服务提供对象版本控制的地方(Amazon S3、Google Cloud Storage、MinIO 等)为存储桶开启它。被删除或被覆盖的对象会作为非当前版本保留下来,存储桶就可以回到某次数据库备份的时刻。
aws s3api put-bucket-versioning --bucket my-media --versioning-configuration Status=Enabled使用 Amazon S3 和 Google Cloud Storage 的 OpenTofu 模块时,设置 versioning = true:它会开启版本控制,并添加下面针对非当前版本的规则,其保留天数为 noncurrent_version_days(默认 35)。Cloudflare R2 没有对象版本控制,而另一种 S3 兼容存储的模块不会创建存储桶,因此这两种情况请使用下面的复制。
生命周期规则。 启用版本控制后,每个被删除的文件在规则将它移除之前,都会一直产生存储费用。请添加一条规则,在你最旧的数据库备份的保留期之后删除非当前版本(对于不含按月备份的备份频率和位置中的各代备份,是 35 天),这样你保留的每一份数据库备份都仍能找到它的文件,而用户删除的文件也不会比你的隐私政策所说的保留得更久。再添加一条规则,在一天后中止未完成的分片上传:服务器会自行中止大文件失败的上传,但在上传中途停止的进程会留下它的分片。
{ "Rules": [ { "ID": "noncurrent-versions", "Status": "Enabled", "Filter": {}, "NoncurrentVersionExpiration": { "NoncurrentDays": 35 }, "AbortIncompleteMultipartUpload": { "DaysAfterInitiation": 1 } } ]}aws s3api put-bucket-lifecycle-configuration --bucket my-media --lifecycle-configuration file://lifecycle.json在另一个账号或区域中的副本。 版本控制能防范误操作,但不能防范存储桶或拥有它的账号丢失,而且服务器自己的凭据可以删除对象。请保留一份这些凭据无法触及的副本:
-
复制。 Amazon S3 可以把启用版本控制的存储桶复制到另一个区域或另一个账号的存储桶(跨区域或同区域复制,目标由另一个账号拥有)。请同样为目标开启版本控制,并且不要复制删除操作(保持删除标记复制关闭),这样实例上的删除就不会波及副本。其他服务有各自的复制功能,例如 Cloud Storage 的双区域存储桶和 MinIO 的存储桶复制。
-
定时复制。 在没有复制功能的地方,或者要复制到另一个服务商时,请按数据库备份的计划,在备份之后立即复制存储桶,使用只能读取实例存储桶、且只能写入备份存储桶的凭据:
终端窗口 rclone copy --checksum source:my-media backup:my-media-backup不带
--delete的rclone copy和aws s3 sync只会添加新对象,从不从副本中移除任何对象。文件一经写入就不会改变,因此第一次运行之后,每次复制只传输新增的文件。请按你的保留政策的计划从副本中删除旧对象,或者在那里同样开启版本控制和生命周期规则。
凭据不要放进副本:存储桶不保存任何机密,但配置中的 blob_s3_access_key_id 和 blob_s3_secret_access_key 指明了密钥,它们应与配置放在一起。gcs blob 存储不保存密钥:它使用机器或 Cloud Run 的服务账号。
数据库与媒体的顺序
Section titled “数据库与媒体的顺序”先备份数据库,再备份媒体,并把两者作为一代放在一起保存。对于存储桶,在数据库备份之后运行的复制就是媒体备份;开启版本控制时,数据库备份时刻的版本就是媒体备份。
数据库记录了它所使用的媒体文件,而媒体副本是稍后片刻才取得的。在这片刻之间:
- 新上传的文件可能出现在媒体副本中,而数据库副本中没有对应的行。它们是没有被任何东西使用的文件;会占用空间,但没有害处。
- 在数据库备份之后被删除的文件(已删除帖子的媒体、从未附加到帖子的上传文件)在数据库副本中有记录,但不在媒体副本中。恢复后,该文件会返回
404,显示它的帖子会显示缺失的图片。
反过来的顺序更糟:在媒体备份和数据库备份之间上传的每个文件在恢复后都会丢失,包括新帖子的媒体。在维护模式下同时完成两项备份,可以避免这两种缺口。
在 OpenTofu 目标上
Section titled “在 OpenTofu 目标上”这些模块除了服务商提供的功能之外,不保留任何自己的备份:Cloud SQL 和 RDS 的托管 PostgreSQL 有自动备份,保留期由你设置,而只有服务商历史记录的数据库(Neon)只能回溯到该历史记录所及的范围。请自行安排以下事项,使用实例不持有的凭据:
- 数据库,每天一次。 在托管数据库的服务商之外的机器或定时任务上,对实例的 PostgreSQL 运行
pg_dump(请参阅 PostgreSQL),加密转储文件,并把它写入另一个账号或服务商的存储桶。请保留备份频率和位置中所述的各代备份。该任务只需要database_url,不需要其他任何内容;它绝不能持有 KEK。 - 媒体,紧接其后。 在存储桶模块上设置
versioning = true后,这些版本就是最近noncurrent_version_days天内的副本;若要防范账号丢失,还要按数据库转储的计划,如存储桶中的媒体所述,运行rclone copy把实例的存储桶复制到别处的存储桶。 - KEK 和配置不在定时计划之内:在它们更改时再备份(KEK 和配置)。
KEK 与配置
Section titled “KEK 与配置”KEK 不在数据库中。请按照管理密钥加密密钥中的说明,与数据库备份分开备份一次,并在每次轮换后再次备份。把配置(环境变量、配置文件、.env 和密钥文件)的副本与部署文件放在一起保存,不包含 KEK。
备份中保存着其实例的 host 和 account_domain。启动恢复后的数据库时要使用相同的值:值不同时,服务器会拒绝启动。
在空环境(新机器、新卷或新数据库)中按以下顺序恢复:数据库、媒体(目录或存储桶),然后是配置,使用备份时正在使用的同一个 KEK(以及相同的 kek_previous)。然后照常启动服务器。
SQLite
Section titled “SQLite”停止服务器,用备份文件替换数据库文件,如果还留有旧的 -wal 和 -shm 文件,就把它们删除。使用 Docker Compose 时,恢复到卷 my_data 中(现有的卷,或另一台机器上的新卷):
cd deploy/dockerdocker compose down # keeps the volume; on a new machine, `docker compose up --no-start` creates itdocker run --rm -v my_data:/data -v "$PWD":/backup busybox sh -c ' rm -rf /data/my.db /data/my.db-wal /data/my.db-shm /data/blobs && cp /backup/my-202601010000.db /data/my.db && tar xzf /backup/blobs-202601010000.tar.gz -C /data && chown -R 65532:65532 /data'docker compose up -d服务器镜像以用户 65532 运行,该用户必须拥有卷中的文件(即上面的 chown)。
PostgreSQL
Section titled “PostgreSQL”恢复到一个新的空数据库中,准备方式与新实例相同,但不要应用 schema:转储中已经包含它。
-
创建角色和数据库。
-
恢复转储。以超级用户身份恢复时,恢复的表保留其所有者(该角色必须存在);以数据库所有者身份恢复时,加上
--no-owner。终端窗口 pg_restore --exit-on-error --dbname="postgres://postgres:...@db.example/my" my-202601010000.dump -
如果使用托管数据库自己的备份,请改用服务商的方式恢复,并把
database_url指向恢复后的实例。
使用 Compose 层 compose.postgres.yaml 时,只在新卷上启动数据库,然后恢复到其中。容器已经创建好了角色和数据库:
cd deploy/dockerdocker compose up -d --wait postgresdocker compose exec -T postgres pg_restore --exit-on-error --no-owner -U my -d my < my-202601010000.dumpdocker compose up -d如果要覆盖现有数据库进行恢复(回滚升级),请使用 pg_restore --clean --if-exists,如回滚所示。
在服务器启动前,把媒体副本解压到 blob_fs_dir 中,文件归服务器运行时所用的用户所有。
存储桶中的媒体
Section titled “存储桶中的媒体”在服务器启动前,把对象恢复到一个空存储桶中,然后将 blob_s3_bucket(以及端点、区域和凭据)或 blob_gcs_bucket 设置为该存储桶。键必须保持不变:数据库按键来指定每个文件。
-
从另一个存储桶中的副本恢复时,把它复制回来:
终端窗口 rclone copy --checksum backup:my-media-backup target:my-media-restored -
从实例自身存储桶的版本恢复时,把数据库备份时刻的对象复制到一个新存储桶。
rclone用--s3-version-at读取那一时刻的版本:终端窗口 rclone copy --s3-version-at "2026-01-01 00:00:00" source:my-media target:my-media-restored -
从副本恢复时,把
blob_s3_bucket或blob_gcs_bucket指向副本,或者把它复制回原账号中的一个存储桶。
服务器的凭据需要能读取、写入和删除恢复后存储桶中的对象(Amazon S3 上为 s3:GetObject、s3:PutObject、s3:DeleteObject
和 s3:AbortMultipartUpload;Google Cloud Storage 上为该存储桶的角色 roles/storage.objectUser)。
照常启动服务器。使用 Docker Compose 时,docker compose up -d 会先运行 my db upgrade -check、schema 和 my db upgrade;对于同一版本的备份,它们不会做任何更改。然后检查:
/readyz返回200,并且服务器日志中没有unknown key-encryption key错误。my projection verify没有报告差异(检查和重建投影)。- 你可以登录,并且最新的帖子及其媒体能正常显示。
- 各 actor 的密钥没有改变:某个 actor 的
publicKey.publicKeyPem(curl -H 'Accept: application/activity+json' https://<host>/ap/actors/<id>)与恢复前相同。其他服务器用该密钥验证实例的签名,所以密钥不变意味着联邦会从中断的地方继续。 - 发帖、关注或取消关注能到达另一台服务器(另一个实例上的测试账号能看到)。
备份之后的写入会丢失:此后的帖子、关注和上传在本实例上都不复存在,而其他服务器可能仍保留着它们收到的活动。这在本实例上无法修复;请从你手头最新的备份恢复。
如果使用搜索引擎,恢复后运行 my search rebuild,不带 --keep,这样比备份更新的帖子会从索引中移除(全文搜索)。
没有正确的 KEK 时
Section titled “没有正确的 KEK 时”- 没有 KEK:服务器无法启动。
my serve以及其他读取配置的my命令会在此停止,并报The required setting MY_KEK is not set.和kek: required when key_manager is local。 - 使用另一个 KEK:服务器能启动并响应
/readyz,但任何读取用旧 KEK 加密的密钥的操作都会失败,报unknown key-encryption key以及旧 KEK 的密钥 ID(local key manager: key "local:…" is not configured):向其他服务器的投递和带签名的获取(各 actor 的私钥)、使用双重验证的登录、Webhook 签名,以及外部登录服务商。之前签发的媒体代理 URL 也会失效。密码和帖子没有用 KEK 加密,所以用密码登录和阅读帖子仍然正常,这可能在一开始掩盖问题:请留意日志中的错误。 - 找到错误中所示密钥 ID 对应的 KEK,把它设为
kek(或放进kek_previous),然后重启。没有 KEK 就无法恢复密钥;如果 KEK 永久丢失,就必须重新生成各 actor 的密钥,其他服务器会把每个 actor 视为同一账号使用了新密钥。
备份只有在被恢复过之后才能确定可用。请在实例公开之前演练一次恢复,并且在备份方式发生变化之后再演练一次(至少每隔几个月一次):
-
如上所述对在线实例做一次备份:先是数据库,然后是媒体。
-
在另一台机器上或另一个 Compose 项目中恢复它,使用你保管它们的地方的 KEK 和配置(不要从在线服务器复制),并保持
host不变,使 actor 的 URL 保持一致。 -
不要让副本参与联邦。设置
role = web,它不运行任何任务 worker:随数据库一起恢复的任务包括备份时已到期的投递,运行它们的副本会用真实 actor 的密钥为它们签名,并再次发送给其他服务器。仅仅让副本不连接互联网是不够的,因为这很难保证。如果你让它继续运行,请在下面的检查通过之后开启维护模式。 -
在 Compose 之外,例如在本地机器上对着云端实例,请给副本以下设置,使它不触碰在线实例的任何内容:
设置 副本中的值 原因 roleweb不运行任何任务,因此恢复的内容不会被再次投递 queuedb副本中入队的任务留在它自己的数据库中,而不会进入在线队列 streampostgres不加入实例的在线事件流 mailnone不向真实用户发送邮件 blob 存储 保存已恢复媒体的新存储桶(或目录) 不触碰在线存储桶 database_url已恢复的数据库 绝不是在线的那个 KEK( MY_KEK,或key_manager和kms_key)与在线相同,来自你保管它的地方 没有它,副本无法启动 host与在线相同 使 actor 的 URL 保持一致 -
走一遍启动和检查:登录、帖子和媒体,以及将几个 actor 的
publicKey与在线实例进行比较。 -
不带 KEK 启动一次,再用一个不同的 KEK 启动一次,并检查它是否如没有正确的 KEK所述那样失败。
-
记下每个步骤花了多长时间:这就是真实恢复时实例停机的时长。
供 LLM 和编程智能体使用:llms.txt,llms-full.txt, llms-small.txt