

本頁由英文頁面機器翻譯而成。內容以英文頁面為準。 閱讀英文頁面
維護
本頁說明如何為了處理資料庫、KV 或佇列而暫停伺服器,以及暫停期間要顯示什麼。
有兩種工具:
- 維護模式(
maintenance = true、MY_MAINTENANCE=true或my serve -maintenance)。my serve啟動時不開啟任何轉接器,並以503、Retry-After,以及每種用戶端都能理解的回應來回答所有請求。只要my serve本身能執行,就使用這種方式。 - 匯出的頁面(
my maintenance export)。以相同範本產生的靜態 HTML,在my serve完全無法執行時(例如正在替換映像檔,或修訂版本無法啟動),交由負載平衡器、CDN 或反向代理提供。請參閱匯出維護頁面。
維護模式的回應
Section titled “維護模式的回應”程序只會讀取監聽位址、host、account_domain、web_origin、代理(trusted_proxies、trusted_proxy_header)、來源檢查(origin_secret、origin_secret_previous、origin_secret_header)、status_page_url,以及 maintenance_* 設定(設定參考)。
資料庫、佇列、blob 儲存、KV、郵件和串流的設定不會被讀取或檢查,所以在這段期間它們可以是錯的或無法連線。
不論 role 為何,它都只提供 HTTP:沒有任務、沒有週期性任務、沒有串流 broker。不論 tls 設定為何,它也只提供一般的 HTTP,位於 listen 或其預設值 :8080(由伺服器本身提供 HTTPS)。
my config check -maintenance 會檢查維護模式所讀取的內容,不多也不少。
設定了 origin_secret 時,需要標頭但沒有帶標頭的請求,會得到該項檢查的 403,而不是下表的回應。
| 請求 | 狀態 | 內容 |
|---|---|---|
GET /healthz、GET /readyz、GET /health/live、GET /health/ready |
200 |
{"status":"maintenance"} |
GET /api/v1/instance/health |
503 |
{"status":"maintenance"} |
用戶端 API 的其餘部分(/api/*)和回應 JSON 的 OAuth 端點 |
503 |
類型為 /api/v1/problems/maintenance 的 application/problem+json,帶有 message、until,以及設定了時的 status_page_url |
ActivityPub(依路徑、Accept 或 Content-Type)、WebFinger、host-meta、NodeInfo、付款 webhook、Cloud Tasks 和 Cloud Scheduler 的呼叫(/_internal/*) |
503 |
{"error":"maintenance"} |
| 其他所有請求(頁面、網頁用戶端、它的資源、表單送出) | 503 |
維護頁面,或在 Accept 要求 JSON 時回應 problem |
每個回應都有 Retry-After 和 Cache-Control: no-store。Retry-After 在 maintenance_until 還在未來時,是距離它的秒數(最多 86,400),否則是 maintenance_retry_after(Go duration,預設 10m)。
頁面與 problem 會顯示:
| 設定 | 顯示為 |
|---|---|
maintenance_server_name |
伺服器的名稱。未設定時是主機名稱(實例自己的名稱在資料庫中) |
maintenance_message |
純文字的公告,最多 2,000 個字元,所有語言都相同 |
maintenance_until |
預計何時結束工作(RFC 3339)。頁面以 UTC 顯示;網頁用戶端以使用者的時區顯示 |
status_page_url |
狀態頁面的連結(監控) |
maintenance_* 設定在正常運作期間可以維持設定:它們只在 maintenance 為 true 時才會使用。
頁面的文字依 Accept-Language 而定(否則是英文)。
當 API 以維護 problem 回應時,網頁用戶端會顯示全螢幕的維護公告,讓使用者維持登入,並在 Retry-After 之後重試。
請把維護控制在幾個小時以內。其他伺服器遇到 503 時會重試傳送,但沒有一個會讀取 Retry-After;當它們的重試次數用完,這段期間送來的活動對這個伺服器而言就遺失了。依據各主要實作的重試排程,最短的重試期間大約是一天(Akkoma 約 1 天、Misskey 約 1.5 天、Mastodon 約 2–3 天、Pleroma 約 7 天)。搜尋引擎會把短暫的 503 視為暫時性停機,但 Google 建議不要對 robots.txt 回應 503 超過一兩天。停止超過一兩天就不算維護了:請改為結束服務(結束服務)。
- 事先公告。 提前在狀態頁面(
status_page_url)和公告(管理 → 公告)中發布維護時段。 在部署的設定中設定maintenance_message和maintenance_until,如果前端提供匯出的頁面,也請更新它們(my maintenance export)。 - 停止推送佇列(Cloud Tasks)——請參閱下方。否則時段內的每次傳送都會是
503,並用掉任務的一次嘗試。 - 切換到維護模式:以
MY_MAINTENANCE=true重新部署(依下方各目標)。每個副本都會以維護模式重新啟動;負載平衡器會保留它們,因為/readyz回應200。 - 進行作業。
- 切換回來:不帶
MY_MAINTENANCE(或設為false)重新部署,確認/health/ready和/api/v1/instance/health回應{"status":"ok"},然後恢復推送佇列並關閉公告。
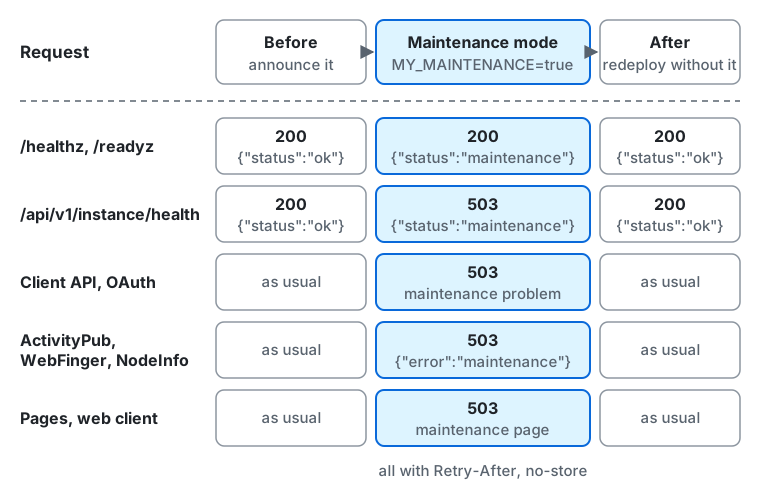
由左至右:
- 之前,也就是你公告維護的期間,每個請求都照常回應:
/healthz、/readyz和/api/v1/instance/health以{"status":"ok"}回應200。 - 維護模式中(
MY_MAINTENANCE=true):/healthz、/readyz、/health/live和/health/ready以{"status":"maintenance"}回應200。/api/v1/instance/health以{"status":"maintenance"}回應503。- 用戶端 API 的其餘部分和回應 JSON 的 OAuth 端點,會得到帶有維護 problem 的
503。 - ActivityPub、WebFinger 和 NodeInfo 以
{"error":"maintenance"}回應503。 - 頁面和網頁用戶端會得到帶有維護頁面的
503。 - 每個回應都有
Retry-After和Cache-Control: no-store。
- 你不帶
MY_MAINTENANCE重新部署之後,每個請求又照常回應。
-
Cloud Tasks:暫停佇列,佇列會繼續接受新任務但停止派送,作業結束後再恢復。任務的嘗試次數是佇列的
retryConfig.maxAttempts。終端機視窗 gcloud tasks queues pause my-jobs --location=asia-northeast1gcloud tasks queues resume my-jobs --location=asia-northeast1也請暫停
/_internal/tick的 Cloud Scheduler 任務(gcloud scheduler jobs pause/resume),或讓它的呼叫在這段期間以503失敗。任務本身存放在資料庫中:用完嘗試次數的 Cloud Tasks 任務只會失去它的觸發訊號,作業結束後的第一次 tick 會再次觸發所有到期的任務。
各部署目標的做法
Section titled “各部署目標的做法”以下前端的錯誤頁面會以匯出的頁面回應伺服器的錯誤。請只比對伺服器沒有在執行時的錯誤(502 和 504,以及負載平衡器在沒有健康後端時自己回應的 503),或只在 my serve 無法執行時才開啟該規則:對所有 503 生效的規則,也會取代維護模式自己的回應,例如用戶端 API 和網頁用戶端讀取的 problem。
Cloud Run
Section titled “Cloud Run”部署一個帶有該變數的新修訂版本,作業結束後再移除:
gcloud run services update my --region=asia-northeast1 \ --update-env-vars=MY_MAINTENANCE=true,MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Zgcloud run services update my --region=asia-northeast1 --remove-env-vars=MY_MAINTENANCE,MY_MAINTENANCE_UNTIL使用 OpenTofu 模組時,請改在區塊中以 settings = { maintenance = "true" } 設定並套用,因為下一次套用會還原區塊所寫的內容:升級前後的做法請見在 Cloud Run 上部署。
當 Cloud Run 不經負載平衡器而直接對外公開時,它前面沒有任何東西,因此維護模式是唯一的工具。
當 my serve 無法執行時,若位於全域外部應用程式負載平衡器後方:把匯出的 index.html 上傳到一個加入為後端 bucket 的 Cloud Storage bucket,並加入自訂錯誤回應政策,以它回應後端的 502 和 504,並設定 overrideResponseCode: 503。只有全域外部應用程式負載平衡器有自訂錯誤回應(區域或傳統版本都沒有),而且該政策只套用於來自後端的回應,不套用於 Google Front End 自己產生的回應。這種方式無法傳送 Retry-After:錯誤來源的自訂標頭不會被加上。
# Part of the URL map (gcloud compute url-maps import).defaultCustomErrorResponsePolicy: errorService: https://www.googleapis.com/compute/v1/projects/<project>/global/backendBuckets/my-maintenance errorResponseRules: - matchResponseCodes: ["502", "504"] path: /index.html overrideResponseCode: 503AWS ECS
Section titled “AWS ECS”為服務的任務定義註冊一個新修訂版本,在容器的環境中加上 MY_MAINTENANCE=true,把服務更新到這個版本,作業結束後再以不含該變數的版本做同樣的事。使用 OpenTofu 模組時,請改在區塊中以 settings = { maintenance = "true" } 設定並套用,因為下一次套用會還原區塊所寫的內容:升級前後,先套用維護模式,再套用新版本,最後套用不含它的區塊,做法如在 Cloud Run 上部署所述。
當 my serve 無法執行時,若位於 CloudFront 後方:把匯出的 index.html 上傳到作為第二個來源的 S3 bucket(錯誤頁面不能來自出問題的來源),並為 502 和 504(以及只在 my serve 無法執行時的 503)加入自訂錯誤回應,設定 ResponsePagePath: /maintenance/index.html 和 ResponseCode: 503。CloudFront 可以透過帶有自訂標頭的回應標頭政策加上 Retry-After,但該政策會套用到該快取行為的所有回應,因此請只在維護期間附加,之後再移除。
應用程式負載平衡器的固定回應無法承載匯出的頁面:它的內容最多 1,024 個字元,也不會設定 Retry-After 之類的標頭。只能用它來回應簡短的文字和狀態:
{ "Type": "fixed-response", "FixedResponseConfig": { "StatusCode": "503", "ContentType": "text/plain", "MessageBody": "This server is under maintenance. Please try again later. / メンテナンス中です。しばらくしてからお試しください。" }}沒有 Retry-After 時,其他伺服器會依照自己的排程重試,上述的維護時段已經考慮到這一點。
Docker Compose
Section titled “Docker Compose”deploy/docker/compose.yaml 會把 .env 的設定傳給伺服器,也會從 shell 取得 MY_MAINTENANCE、MY_MAINTENANCE_MESSAGE 和 MY_MAINTENANCE_UNTIL。設定它們並重新建立 my 服務,作業結束後取消設定 MY_MAINTENANCE 並再次重新建立。--no-deps 可避免執行一次性的資料庫服務(upgrade-check、schema、upgrade);升級時才會執行它們(升級):
MY_MAINTENANCE=true MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Z docker compose up -d --no-deps --force-recreate mydocker compose up -d --no-deps --force-recreate my當 my serve 無法執行時,若位於 nginx 後方:從一個目錄提供匯出的頁面,依 Accept-Language 選擇其中一個,並以它作為 503 回應 nginx 自己的 502 和 504(伺服器停止或沒有回應)。維護模式自己的 503 會原封不動地通過,因為 proxy_intercept_errors 保持關閉。
map $http_accept_language $maintenance_page {    default  en.html;    ~*^ja    ja.html;}
server {    # ...    location / {        proxy_pass http://my:8080;        error_page 502 504 =503 /maintenance/$maintenance_page;    }    location /maintenance/ {        internal;        alias /srv/maintenance/;   # the -out directory of my maintenance export        add_header Retry-After 600 always;        add_header Cache-Control no-store always;    }}
microk8s(Kubernetes)
Section titled “microk8s(Kubernetes)”在 Deployment 上設定該變數,這會重新部署 Pod,作業結束後再移除:
microk8s kubectl set env deployment/my MY_MAINTENANCE=true MY_MAINTENANCE_UNTIL=2026-10-24T03:00:00Zmicrok8s kubectl rollout status deployment/mymicrok8s kubectl set env deployment/my MY_MAINTENANCE- MY_MAINTENANCE_UNTIL-在維護模式中,/readyz 上的 readiness probe 會持續通過,因此部署會完成,Service 也會繼續把流量導向這些 Pod。
當 my serve 無法執行時,若位於 NGINX Ingress Controller(microk8s 的 ingress 附加元件)後方:用一個小型的 nginx Deployment 提供匯出的頁面(例如從包含 index.html、en.html 和 ja.html 的 ConfigMap 提供),並把它設為自訂的預設後端,讓控制器從它回應伺服器的 502 和 504(只在 my serve 無法執行時才加入 503):
metadata: annotations: nginx.ingress.kubernetes.io/custom-http-errors: "502,504" nginx.ingress.kubernetes.io/default-backend: my-maintenance # a Service in the same namespace維護期間的監控
Section titled “維護期間的監控”/healthz、/readyz、/health/live和/health/ready維持200與{"status":"maintenance"}:負載平衡器和 Kubernetes 會保留這些實例。/api/v1/instance/health以{"status":"maintenance"}回應503(監控)。除非可用性監控比對內容,或設有維護時段,否則它們會將伺服器視為停擺;請暫停它們或設定時段。
供 LLM 與程式設計代理使用:llms.txt,llms-full.txt, llms-small.txt